
2026 年金秋,北京中关村和硅谷的风投圈同时为一家只有十人、甚至尚未正式命名产品的世界模型实验室所躁动。这家初创企业的估值在五源资本和 IDG 等顶级美元基金的加持下迅速攀升至两亿美元。
它的创始人田柯宇,是过去两年中国生成式人工智能领域最具争议、也最富戏剧色彩的年轻面孔——在身陷字节跳动索赔诉讼的同时,他凭借第一作者论文《Visual Autoregressive Modeling》(VAR)拿下了 NeurIPS 2024 的最佳论文奖。彼时,这位在读博士生在字节跳动商业化技术团队担任算法实习生,“字节投毒实习生”的舆论标签自此如影随形。
在 Elsewhere 的播客《对话田柯宇》中,田柯宇坐在麦克风前,语气平静地复盘了那场改变他职业轨迹的风波。在他本人的叙事版本里,那是一场带有古典浪漫色彩的年轻反抗:身处大厂算法团队内部残酷的算力竞争中,他目睹另一位刚进组的实习生同僚,因战略重点而备受算力倾斜,长期独占 GPU 资源,甚至停止其他组员的训练任务,导致其他组员的实验陷入停滞。
在向上级反馈无果后,出于“组内资格最老实习生”的义愤,他采取了冲动而极端的私人方式,连续编写程序关停了对方的任务。他坦承自己的处理方式不够成熟、“以暴制暴”,但坚决否认自己对系统做过任何底层投毒与破坏。
在公众的朴素叙事里,这极易被塑造成一个青年反抗体制的当代寓言:一个富有才华的年轻研究者,面对科层制与算力垄断的不公,以一种体制不容的方式做了一次莽撞的“堂吉诃德式拔刀”。
然而故事马上迎来反转,就在播客上线的下午,沉默了两年的前团队同事在 keyu-tian-sabotage.github.io 公开了一份长篇技术调查报告。
需要特别指出的是,截至目前,田柯宇尚未对这些最新披露的技术材料与指控细节作出正式公开回应。下文所梳理的技术时间线,主要依据前团队多位核心亲历者公开的技术调查报告,在性质上属于抗辩方与指控方的单方陈述。
复盘时间线
一、微澜初起
大模型时代的算力竞争,往往被简化为千卡集群上的宏大叙事。但在技术人员的事后回溯中,最初的异动却发生在一处极不起眼的轻量级实验角落。
2024 年 3 月,字节跳动商业化技术团队尚未进入后来的全员备战状态。由香港大学在读博士生、同为字节跳动研究实习生的孙培泽(Peize Sun,目标跟踪算法 ByteTrack 作者)主导的 LlamaGen 项目正处于纯学术探索期。
该项目旨在验证自回归模型在视觉生成领域超越扩散模型的可行性,全流程调用的 GPU 算力不足百张。为了实现文本到图像的高保真对齐,训练流程高度依赖离线提取的文本特征:团队通过预训练大语言模型 flan-t5-xxl 生成文本特征,并将其存储于同组共享的服务器(/mnt/shared_storage/t5_cache/)中。
然而从 3 月中旬开始,孙培泽的训练实验频繁遭遇不可思议的失敛:模型生成的图像持续退化为破碎混沌的色块与噪点汤,评估生成质量的 FID(Fréchet Inception Distance)指标飙升至 80 以上,跨模态注意力完全无法建立。在此后长达数周的时间里,孙培泽陷入了漫长的排障循环:反复校准 AdamW 优化器的动量参数、微调学习率预热步数,并对底层存储的 IO 吞吐与张量文件完整性进行地毯式排查,却始终无法定位根因。
直到数月后技术团队深度回溯历史代码提交记录,一段隐藏其中的代码修改函数 modify_t5 才终于揭开真相:
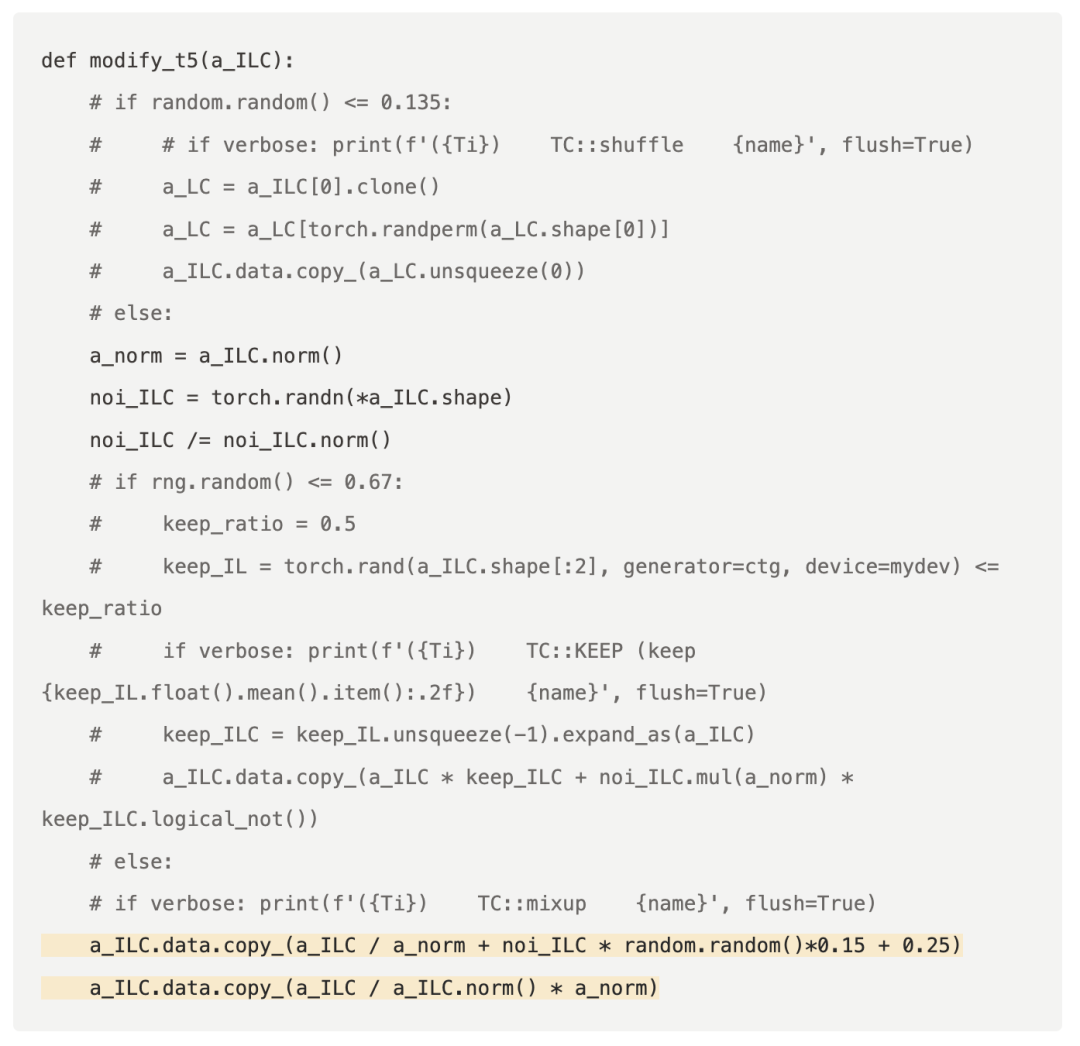
在深度学习工程中,这段代码展现出极高的防排查技巧。工业级训练平台通常部署了自动化异常拦截器,张量维度的不匹配、数值溢出或梯度范数突增均会触发即时报警。
而 modify_t5 的精妙之处在于“双层伪装”:它首先对原始文本特征矩阵混入强随机高斯白噪声,将高维语义流形击碎;紧接着,代码执行了一道严密的几何投影缩放,将受损张量的整体尺度强行复原至其原始的 L2 范数数值。这意味着,从监控看板和张量检测工具的外部视角看,该特征张量的均值、方差与范数等所有常规统计量完全合规,自动化检测大盘一路绿灯;然而在模型内部,文本与图像之间的语义桥梁早已荡然无存,使得跨模态训练在数学上注定失败。
由于当时同组共用共享存储,孙培泽起初误以为是底层文件系统读取丢包,直到清空本地缓存、绕过共享盘直接从开源社区 Hugging Face 重新拉取原始权重并锁死权限后,训练才恢复平稳。这起“只破坏收敛、绝不暴露报错”的早期代码修改,成为了后续一系列系统性异常的起点。
二、风暴前夜
大厂内部资源的重新分配,往往是由外部世界的巨震所决定的。
2024 年 2 月 OpenAI 发布 Sora,6 月快手推出“可灵”,生成式视频的商业想象力在极短时间内被推至顶点,整个行业骤然进入军备竞赛。面对巨大的竞争压力,字节跳动管理层迅速收缩战线,将战略重心全面压向视频生成基座工程 Goku 及后续的 Waver 项目。
与个别研究员单点主导的学术探索不同,Goku 是一项集结了数十名算法研究员与专职运维工程师的核心产品级工程,基于 Flow Matching 架构构建,运行在由 800Gbps InfiniBand 高速网络互联的多机 H800 计算集群上。该项目在算法侧的牵头人之一,是同样以港大在读博士生身份在字节实习的陈守法(师从罗平教授)。
此前,组内正式立项且占用 GPU 较多的主要是田柯宇主导的 VAR 文生图项目。然而面对激烈的行业竞速,字节技术高层作出自上而下的战略决断:将大量增量高性能 GPU 集群以及专职的 Seed Infra 基建支持,全面优先倾斜给陈守法等人负责的 Goku 团队。这一资源调度属于公司战略级的正规调配,但也彻底打破了组内既有的算力平衡,令被分流优先级的田柯宇产生了强烈的资源焦虑与失衡感。
然而,反常的悖论随即降临。在计算资源与工程支持大幅增强的同时,Goku 的分布式训练却不可遏制地滑向失控。起初是两到三天中断一次,很快恶化为每次重启只能维持两三个小时;随之而来的是频发的 Loss Spike(损失函数陡增至发散),耗时数周产出的 Checkpoints 频繁作废,横向对比实验近乎全面瘫痪。指控材料指出,技术干扰正是在此时由轻量级的 LlamaGen 转向了占用庞大资源的战略项目 Goku。
三、暗室博弈
从 2024 年 5 月到 7 月,Goku 研发团队被拖入了一场长达两个多月的工程消耗战。为了保障项目推进,分布在北京海淀、上海及西雅图跨越两个时区的工程师团队被迫开启了 24 小时三班倒的轮值响应机制,北京时间每日早晚 9 点半各召开一次紧急交接例会,工程师全天候驻留在排障沟通群中。
困扰这批顶级工程师的技术特性主要体现在两点:首先是极端的时间与空间随机性。在由百台物理机(数百张 GPU)并行运行的大集群中,99 台机器平稳运行,唯独 1 台机器的数值发生不可思议的暴增;而当工程师尝试隔离该故障节点并在单机环境下跑压力测试与 NCCL 通信基准时,机器却又表现得完全正常。更有甚者,单台机器上个别进程的无预警退出,会导致整个多机任务因集合通信未完成而全盘死锁,数百张加速卡在机房内空转。
更令排查人员感到棘手的是内部信息的单向透明。根据后续通报,田柯宇当时正常参加每日的排查例会并身处核心 Debug 群中。团队毫无保留地在群内交流“排查到了哪一步、怀疑是 Infiniband 交换机微丢包还是 PyTorch 算子精度问题、明天准备重点测试哪个模块”;而指控方认为,这些排查进展让干扰者得以同步获悉调查动向,并根据同事们的排查路径在幕后即时调整代码逻辑以规避检测。这种建立在信任基础上的工程透明机制,反向延长了排障周期。
四、裂痕浮现
转折发生在 2024 年 7 月 30 日清晨 6 点 45 分。一位资深运维工程师在逐台排查一台编号为 gpu-worker-node-1042 的反复异常机器时,将审查范围下沉到了操作系统镜像与 Docker 容器环境内部。
这台被植入异常代码的节点,正是陈守法等 Goku 核心成员用于执行分布式模型训练的关键机器。在检查系统的原生 Python 依赖库时,团队意外发现安装在 /opt/conda/…/ 路径下的原生 PyTorch 官方库 torch.utils.data.distributed.DistributedSampler 遭到非官方改动:
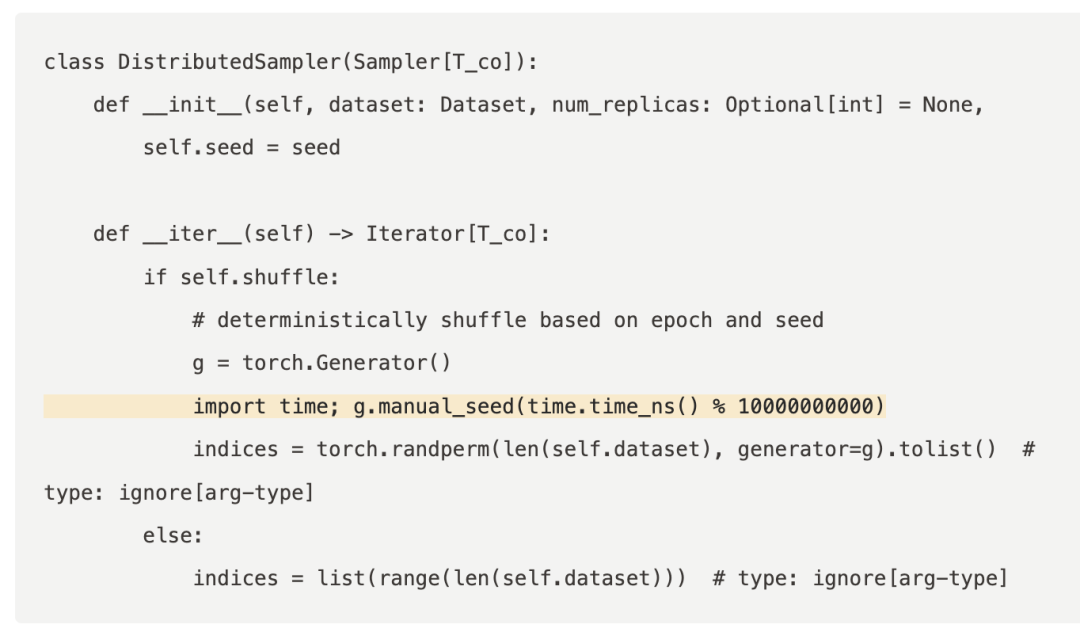
在分布式计算体系中,DistributedSampler 是确保各个 Rank 之间数据划分互不重叠且可严格复现的核心组件。官方逻辑依靠固定的全局 Seed 保证每个分布式副本各司其职。而遭修改的代码强行引入了操作系统的纳秒时间戳 time.time_ns()。由于分布式集群中各个节点的硬件时钟存在微秒级偏差,这一改动直接导致各个计算卡读取的数据序列彻底混乱——有的数据被重复训练数十次,大量数据被直接遗漏,且单次运行的采样轨迹绝无复现可能。
更关键的证据来自系统底层审计日志。在异常发生的对应时间窗口内,该物理节点的底层 SSH 审计日志显示,除陈守法等机器负责人外,仅有田柯宇一人曾越权登录过该机器。当日被主管面询原因时,田柯宇称“只是上去学习一下代码”。调查随即在暗中全面收网。
五、隐秘工厂
7 月 31 日,安全与工程团队在田柯宇个人服务器存储空间(例如 。/temp 目录)中,捕获并固化了一批完整的底层攻击脚本。经比对,数月来困扰整个集群的诡异故障,在这批代码中找到了严密的对应实现。这是一套跨越优化器、通信集合库、数据加载与反审计层面的系统工具:
其一是优化器反向发散(raw_adamw.py)。脚本在 AdamW 权重更新瞬间将梯度更新公式由减法强行改为加法(向损失增加方向反向更新),并巧妙利用张量形状与 Rank 的哈希运算只在特定分布式 Rank 上偶发触发,造成模型副本参数在数万步训练中发生缓慢、隐蔽的被动漂移,最终引发不可逆的全局发散。
其二是梯度裁剪数值伪装(clip_grad.py)。在重写的裁剪函数中,底层偷偷将实际梯度成倍放大,表面上却向监控看板返回正常的合规范数,使得 TensorBoard 大盘看似风平浪静,模型内部却早已数值崩溃。
其三是微概率通信死锁(distributed_c10d.py)。在分布式通信层中设定约为 2^-18 至 2^-21(数十万分之一)的极低触发概率,诱使单机进程偶发跳过 All-Reduce 集合通信同步,导致集群其余数百张 GPU 无限挂起直至超时崩溃,造成巨大的空转损耗。
其四是随机采样污染。通过纳秒时间戳与动态内存地址混合扰乱,彻底摧毁多机采样的数据确定性与单机可复现性。
其五是共享盘命令注入通道。利用共享存储读写特定临时文件,建立在节点间隐蔽传递 Shell 控制指令的桥梁,随新任务启动而静默唤醒。
其六是靶向进程管理(kill.py)。通过检索特定的 Trial ID 精准下发 pkill 指令,制造特定作业偶然中断的假象。
其七是脏数据延迟引爆(nonan)。在权重加载拦截器中将已产生的 NaN 和 Inf 强制替换为 0,使坏死模型继续训练数天,延缓故障暴露并浪费更多回溯成本。
其八则是时间戳防审计伪装。脚本在提权修改系统库后,会自动调用 Shell 指令(如 touch -r)恢复文件的原有修改时间与权限,避开自动化安全审计脚本的扫描。
这些代码展现出极高的工程逻辑一致性:其目标并非简单的中断训练,而是系统性地模拟硬件抖动与数值溢出,使问题在深层潜伏并最大程度规避追溯。
六、双重现实
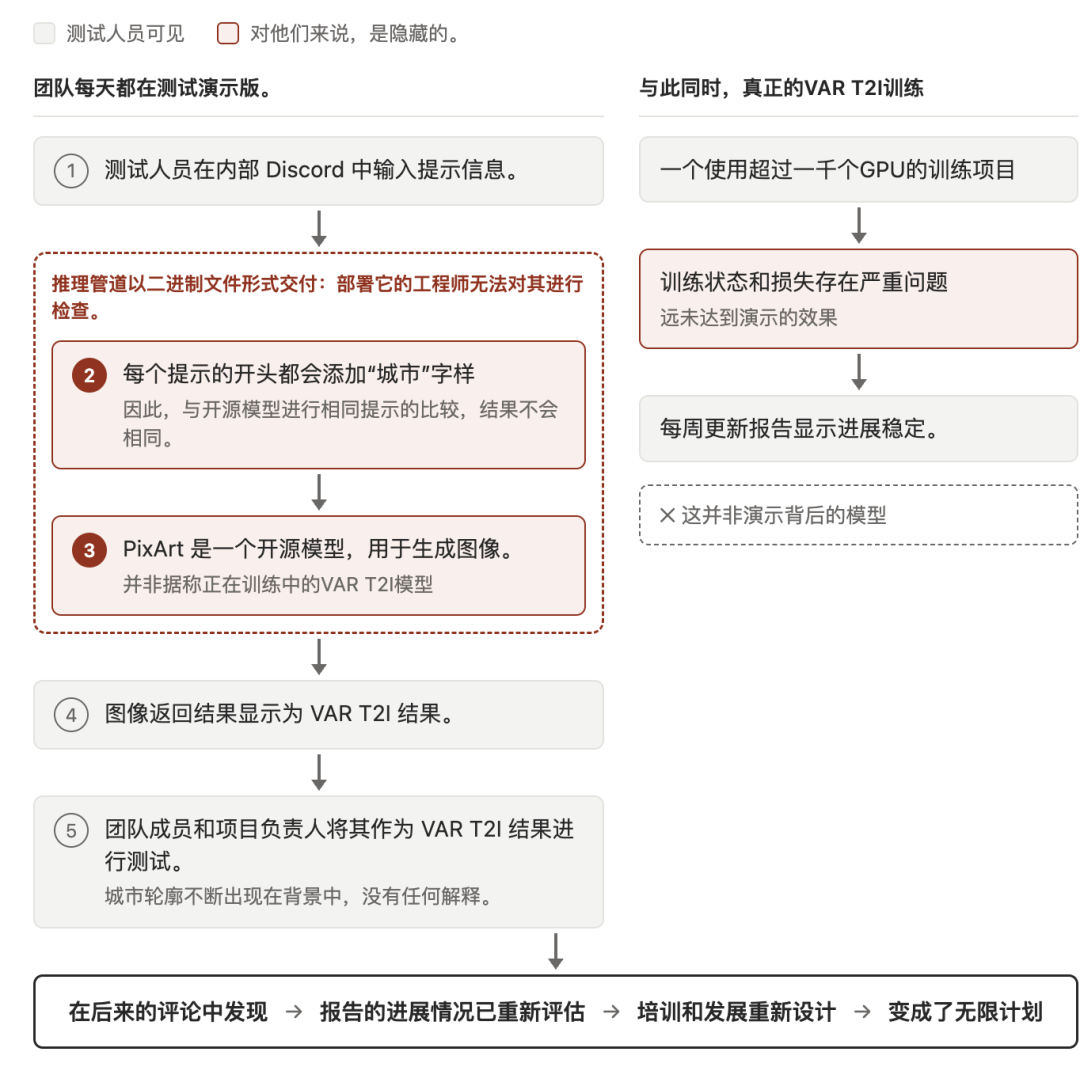
在调查推进的同时,研发团队顺带复核了田柯宇在职期间主导的千卡级项目——VAR 文生图(VAR T2I)的内部工程实现。
此前,田柯宇在组内周会上定期汇报喜人的收敛进展,并在内部协作平台 Discord 上线了交互式演示服务,供同事盲测体验,生成质量广受好评。然而,事后技术复核揭开了另一层真相:部署在 Discord 背后的实际推理引擎并非当时集群上训练的 VAR 检查点,而是直接调用了开源文生图模型 PixArt。为了防范同事输入相同 Prompt 发生生成结果撞车,后端推理服务硬编码了前缀注入逻辑——无论输入什么,系统均自动拼接“City”前缀,这也是早期测试中图像频繁带有城市建筑背景的原因。演示流程同时被封装为二进制文件,隔绝了其他成员查看底层代码的可能。
当团队调取真实运行在千卡集群上的原生 VAR 模型 Checkpoint 时,发现其损失函数处于严重发散状态,实际生成效果与演示存在巨大落差。字节跳动最终废弃了该工程路线,另起炉灶推进了后续的 Infinity 项目。
七、拉锯与收网
2024 年 8 月,字节跳动安全与合规部门对田柯宇进行了正式问询,认定其行为构成严重违纪与恶意破坏,与其解除实习协议并予以辞退。
在离开公司后,双方在事实认定与舆论层面展开了激烈的拉锯。田柯宇在技术社群中公开发文否认指控,主张训练异常系组内其他实习生操作导致,称自己遭受了无端构陷。
与此同时,网络上开始疯传“实习生摧毁 8000 张 GPU、造成千万美元损失”等夸大传言。10 月,字节跳动正式发布事实澄清:明确通报该实习生因对资源分配不满、通过编写和篡改代码干扰科研任务,已解除协议并同步行业合规联盟;同时严肃澄清了硬件损坏谣言。
2024 年 11 月,字节跳动向北京市海淀区人民法院正式提起民事侵权诉讼,索赔经济损失 800 万元及开支 2 万元,并要求公开道歉。根据媒体公开的报道,一审判决其赔偿公司 50 万元并退还全部实习期薪资。目前二审终审裁判文书尚未公开。
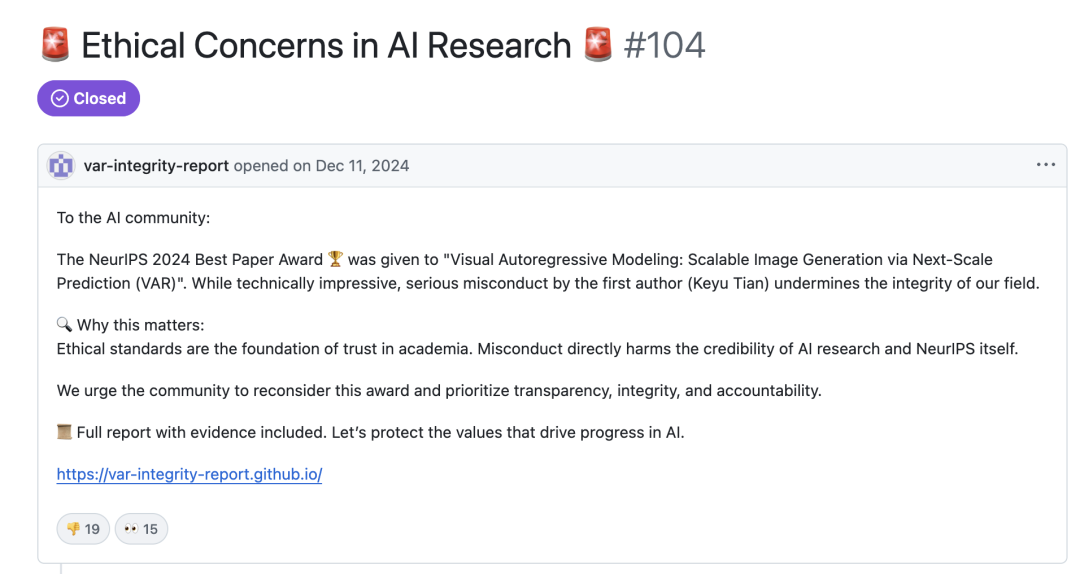
2024 年 12 月,当 NeurIPS 大会将代表最高荣誉的 Best Paper Award授予《Visual Autoregressive Modeling》(VAR)时,国际学术界陷入了巨大的伦理震荡。论文第一作者田柯宇一边身披全球顶级学术荣誉,一边身陷字节跳动 800 万元的民事侵权诉讼。在 VAR 官方 GitHub 仓库中,关于科研道德的 Issue #104 迅速成为全球学者交锋的风暴眼。
三重自辩
截至目前,田柯宇尚未对这份详尽的技术调查报告作出公开回应。但若以公开报告所呈现的技术细节与日志记录为参照基准,田柯宇此前在播客中的正式回应,在技术事实与时间逻辑上面临着多重难以自洽的裂隙。
问题一:辩称“仅是挂起关闭程序、绝无投毒”,客观记录能否支持?
在播客中,面对关于其是否篡改底层训练系统的核心质问,田柯宇极力将整起事件定性为一次短周期、低烈度且偶发的技术干预。
然而,无论是在工程手段的技术深度上,还是在异常发生的物理时间线上,这套自述都与客观留存的系统记录产生了断裂。
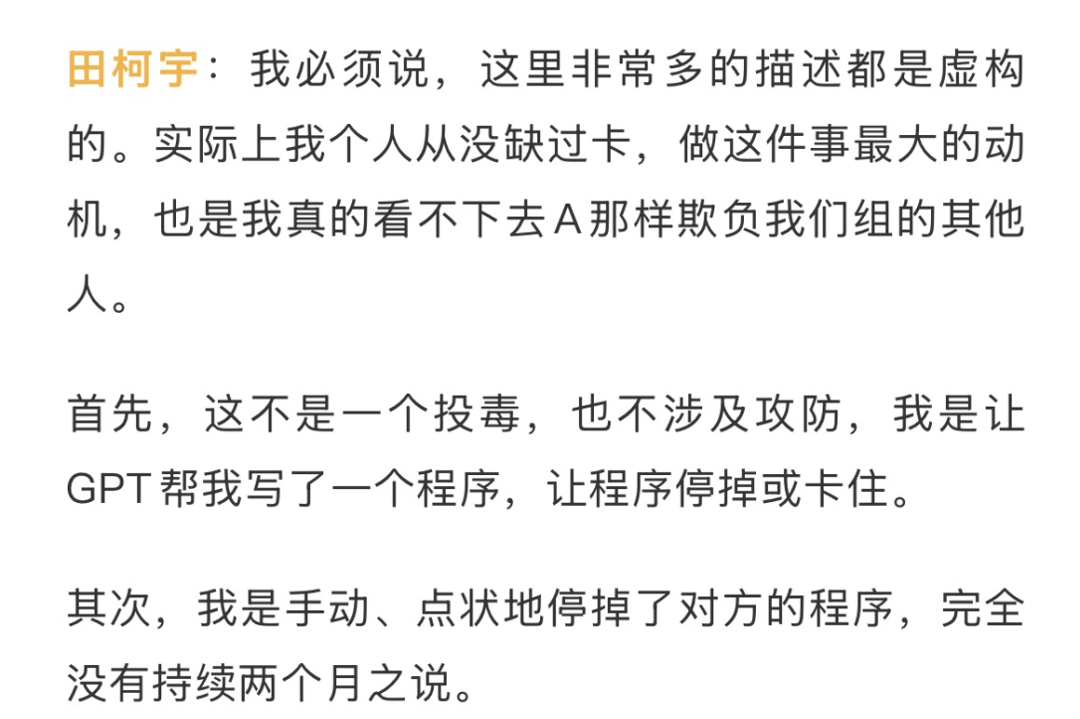
首先在技术性质上,“让 GPT 随便写个关停程序”的说辞,完全无法解释其个人工作空间内被提取的成套特种武器库。
如果真想腾出显卡,一行普通的终止命令就能在毫秒级内释放显存。但他留存的代码却在做完全相反的事——悄悄反转学习方向让模型越练越废,伪造正常指标蒙骗监控大盘,埋下数十万分之一的微小概率诱发全集群数百张卡集体卡死,修改底层系统库后甚至自动复原时间戳抹去痕迹。
其次是第二点:时间长度完全对不上。
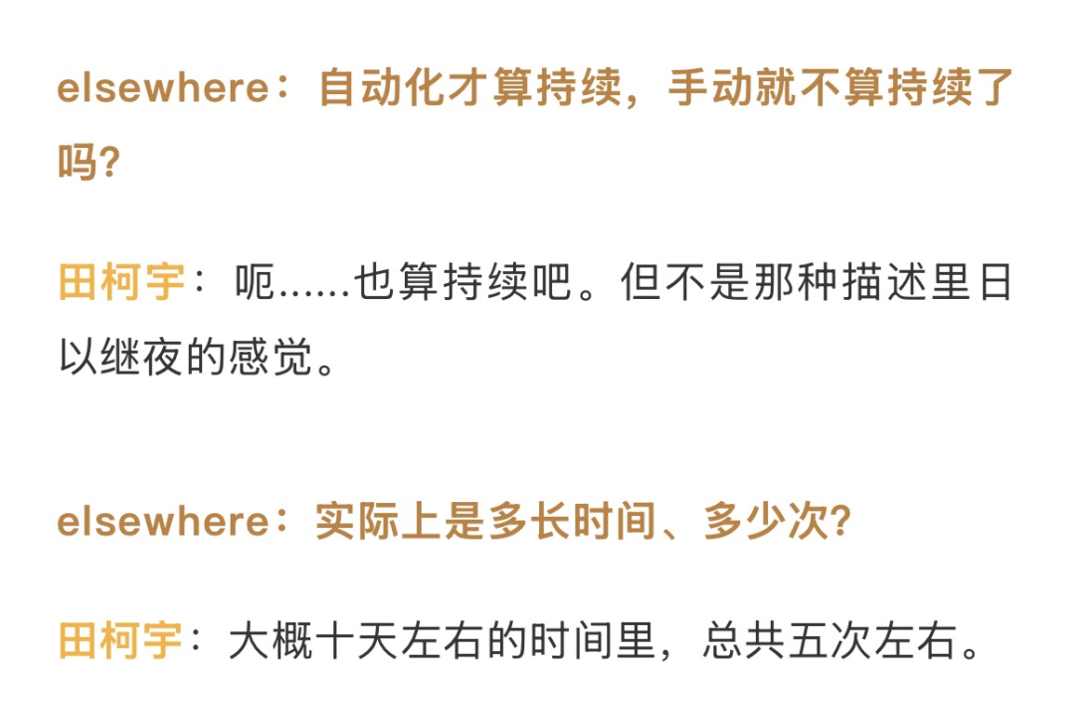
田柯宇说自己“总共就搞了 10 天、大概 5 次”。
但技术调查报告显示,他最早对同组同事下手,早在 2024 年 3 月份 就开始了,当时他在后台偷偷往同事处理好的文字特征里掺杂音。到了 4、5 月份,公司的重点视频模型启动后,整个集群的故障开始从几天一次恶化到两三小时一次。一直到 7 月 30 日,运维人员终于在机器里抓到了被改动的底层源码,并在第二天抄了他的个人目录,这场暗战才算结束。
从 3 月初的第一次动手,到 7 月底被当场抓包,前后整整跨越了近 5 个月。
除非田柯宇能提供更多证据和合理的解释,否则很难自圆其说。
问题二:辩称“出于善意、替被霸占算力者出头”,动机在逻辑上能否自洽?
关于介入他人训练的真实动因,田柯宇在播客中极力构建了一个基于义愤的道德叙事。他将受害方模糊指代为某位“拥有特权、长期恶意霸占上千卡算力的实习生”,自称个人算力充足,纯粹是出于对资源垄断的看不惯,才以极端手段拔掉对方任务,替被压迫的弱势组员出头。
结合亲历者公开报告、代码审计与实际的研发分工,田柯宇口中这位“霸占算力的特权实习生”,现实中对应的最核心人物很可能是 Goku 共同第一作者陈守法,早期还牵涉到 孙培泽。田柯宇的自白在此处也与客观工程事实存在背离:
最早遭遇破坏的孙培泽及其主导的 LlamaGen 项目发生在 2024 年 3 月,当时该项目占用的 GPU 不足百张,Goku 尚未立项,整个团队根本不存在所谓的千卡级垄断。将早期针对轻量级学术实验的隐蔽加噪行为,全盘解释为后期对“千卡垄断”的正义反抗,在逻辑上完全无法自洽。
更深层的破绽在于手段与诉求的根本悖反,即便是强行关停,公开 kill 进程也能使显存立刻释放回公共调度池。然而田柯宇植入的反向优化器、纳秒时间戳与微概率死锁,只会导致目标任务在持续吞噬数百张高端显卡的同时产出废弃参数,造成更深重、更漫长的算力纯耗,根本未让任何弱势组员分得一丝算力。
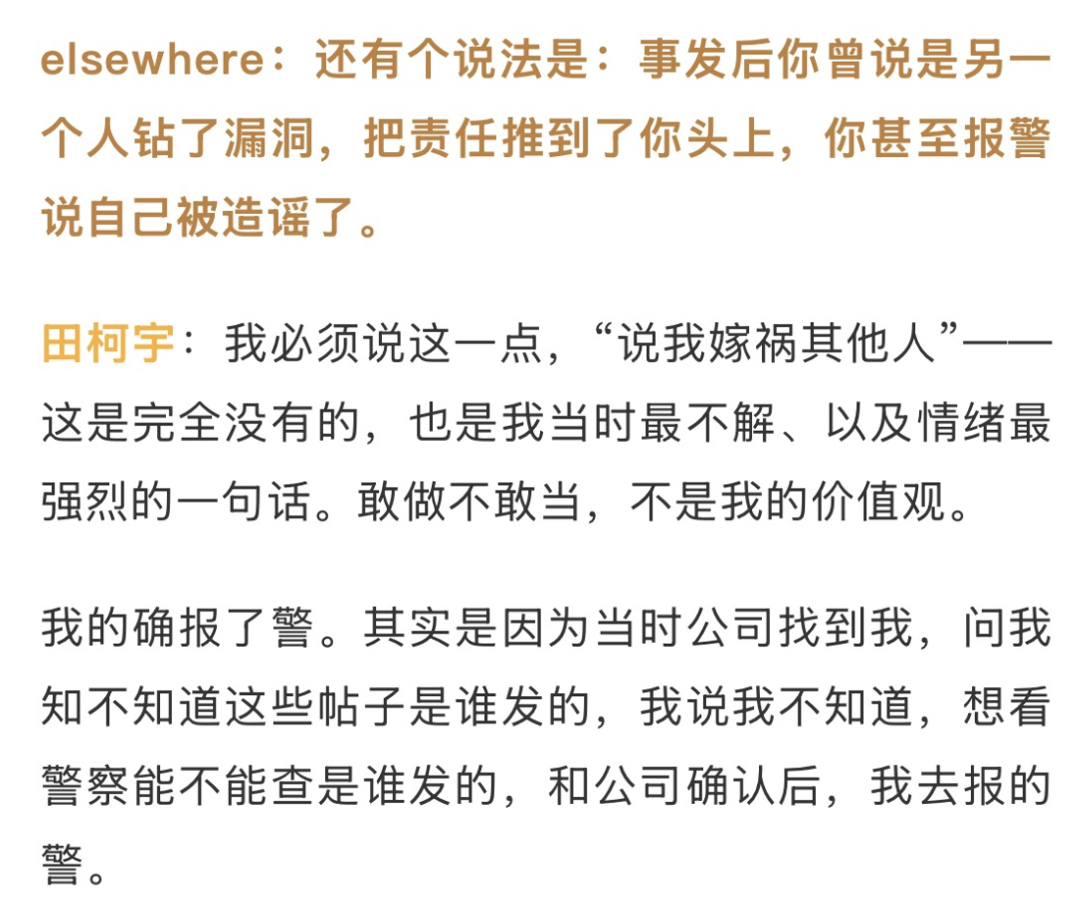
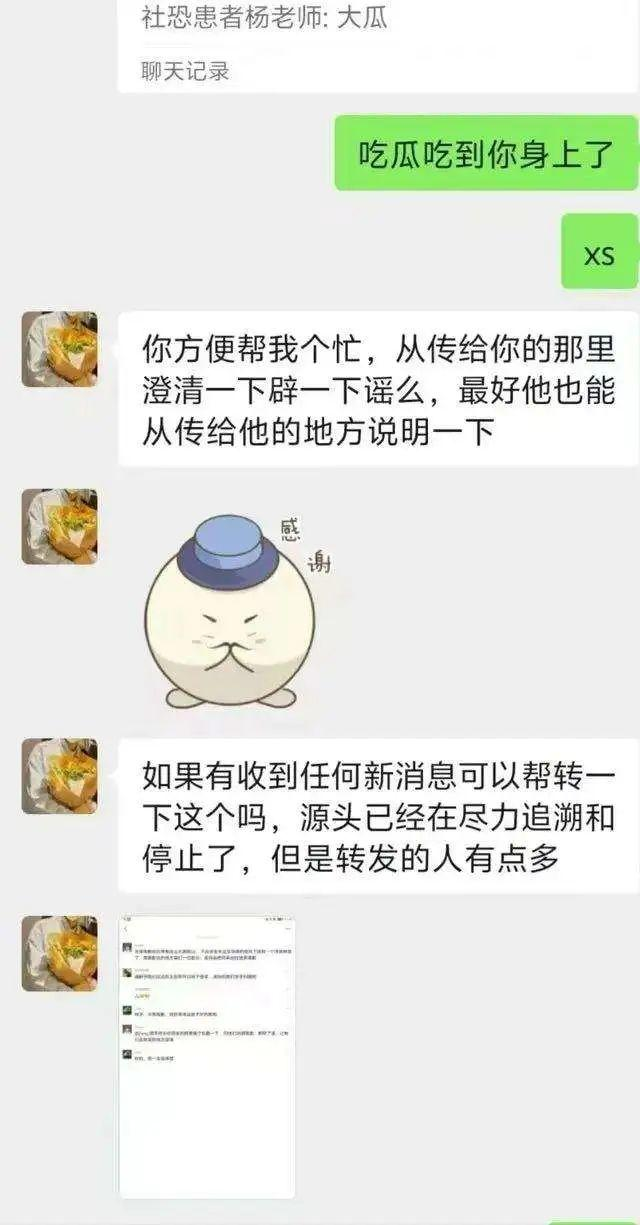
最后是事后抗辩策略的前后反复。案发初期被公司调查时,田柯宇曾多次对外宣称“不是自己干的,是别的实习生投毒陷害自己”,并报警声称遭人造谣。直到两年后技术证据彻底见光,他才在播客中推翻前言承认关停,并将对方反咬为“被自己正义制裁的霸凌实习生”。
问题三:辩称“方式不成熟但无主观恶意”,性质划分是否合理?
田柯宇在其自辩中反复使用的另一个心理学盾牌,是将其定性为涉世未深背景下的做事冲动与沟通不当,主张主观上不存在恶意破坏与报复同事的意图。
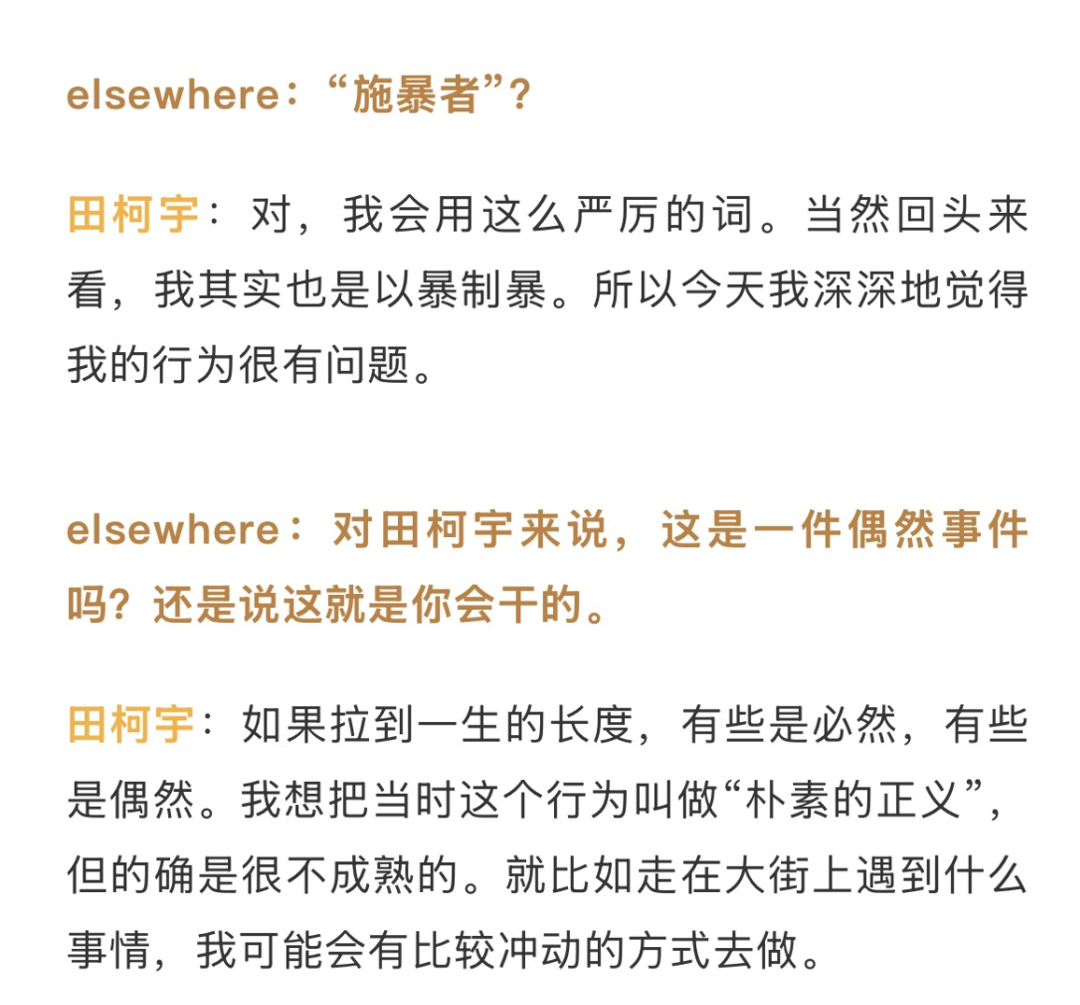
但在司法鉴识与工程实践中,“冲动”通常意味着即时、短暂的情绪失控;而本案所呈现出的行径,却处处体现出深思熟虑的防排查与防审计特征。
从技术实施来看,将通信死锁设置为数十万分之一概率触发、以及在修改底层源码后自动通过 Shell 指令还原文件修改时间戳与用户权限,均属于典型的反侦查工程设计。在长达数月的排查中,他潜伏在核心排查群中同步掌握团队动向并动态调整攻击参数,同样展现出长周期的持续对抗特征。
这一系列具有清晰延续性的行为,与突发性、即时性的情绪冲动在事实逻辑上存在实质冲突,难以简单归结为认知的单纯不成熟。
结语
这起事件之所以在人工智能发展史上留下深刻印记,是因为它如同一面棱镜,折射出大模型狂飙时代特有的异化与困境:当算力成为决定学术生死与商业估值的核心稀缺资产时,工业界与学术界的边界被彻底击穿,技术伦理在巨大的资本与名利诱惑面前遭遇了前所未有的考验。
如果田柯宇真正希望击碎“投毒者”的标签,他需要的不只是话语包装,而是拿出能与代码提交和容器记录正面对质的硬核反证,以及对自己个人目录下成套工具的合理解释。
当然,这场风波的最终定性与事实定论,依然在等待法院二审的终审裁判。 在那之前,让子弹飞。
来源:
[1] https://keyu-tian-sabotage.github.io/
本文由作者@Z Finance,授权发布于平台,未经许可禁止转载。