
导读:大模型时代,业务智能体(Agent)正在客服、调度、用户司机协作等核心业务场景中爆发。然而,从“Demo 演示惊艳”到“敢放进生产环境”,中间隔着一整个质量评测与工程保障体系。本文将系统揭秘货拉拉如何打造面向业务 Agent 的全生命周期自动化评测平台,实现 Agent 质量从“不可知、不可控”走向“可量化、可验证、可信任”。
一、为什么业务 Agent 评测这么难?
1.1 一个让人尴尬的交付现场
你或许也经历过这样的场景:
团队耗时一个月,基于工作流或自研 LLM 打造了一个“智能客服/调度助手” Agent。Demo 演示时表现极其出彩:意图识别精准、工具调用行云流水、多轮对话滴水不漏。
然而一到生产环境,问题接踵而至:
- 回答漂移:同一个费用解答场景,昨天回答按标准口径解释,今天版本微调后却直接给用户承诺了优惠券;
- 工具误调/死循环:遇到复合查询时,Agent 反复调用相同的接口拉取数据,直至 Token 耗尽超时;
- 非确定性输出:测试环境 100% 通过的用例,线上遇到微小的 Prompt 扰动或多轮上下文累积,瞬间答非所问;
- 性能崩塌:高并发场景下,首字延迟(TTFT)从 800ms 飙升至 5s+,流式输出频频中断卡顿。
更棘手的是,当你去排查日志时,发现每一次模型调用的单步推理看起来“都很合理”,但最终的业务交付结果就是错的。由于缺乏统一基准,研发改了一处 Prompt,往往“修好了一个 Bug,暗中引入了三个新缺陷”。
1.2 核心症结:传统测试与单点打分的双重失效
传统测试与单点 Prompt 评估无法支撑业务 Agent,根本原因在于以下三重失控:
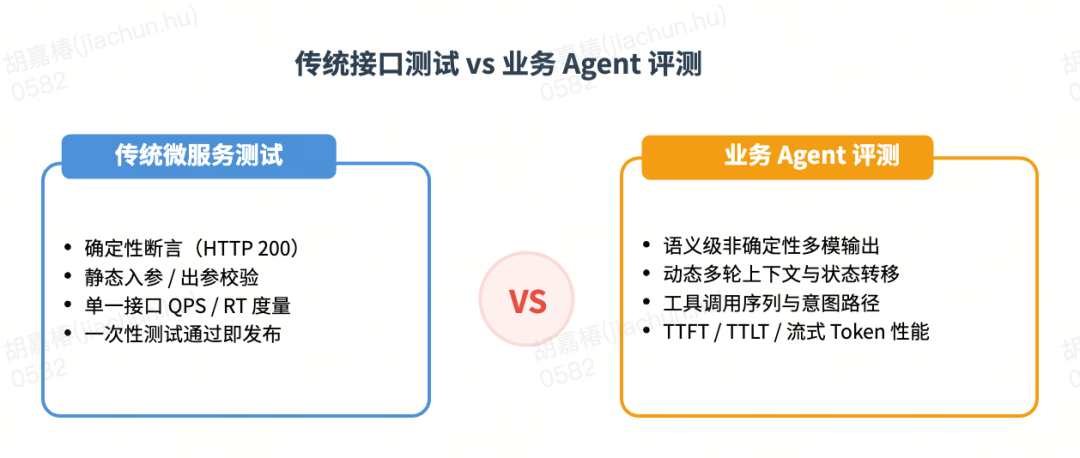
- 确定性断言失效:LLM 具有天然的概率输出特性,传统的 equals 或正则断言无法判断一段语义表述是否准确、是否有幻觉、是否遵守业务红线。
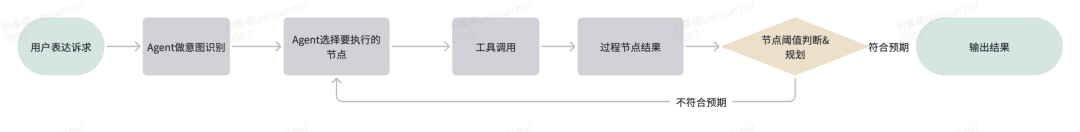
- 上下文与工具链路复杂:业务 Agent 的执行并非简单的”一问一答”,而是一个多轮迭代的动态决策链路。从用户提出目标开始,Agent 需要依次完成意图理解、计划生成、步骤选择、工具调用、结果处理,再根据中间结果判断是否需要修正规划或重试,循环往复直至交付最终结果。整个链路深度集成了企业 MCP 工具库、知识库检索、工作流调用等能力,错误可能发生在”意图理解 – 参数提取 – 工具选择 – 结果组装 – 规划修正”的任意一个节点,且问题往往具有传导性——上游的理解偏差会被下游的工具调用逐级放大,最终导致结果偏离预期。
- 性能度量维度跃迁:Agent 场景下的性能不再只是单纯的 QPS,首字生成时间(TTFT)、总生成时间(TTLT)、Token 吞吐速率(TPS)直接决定了真实用户的交互体验。
核心结论:
“Agent 能跑,不代表能用;单次回答惊艳,不代表生产稳定可靠。”
业务 Agent 的生产级交付,必须由一套完备、客观、自动化的评测基础设施(Evaluation & Benchmark Harness)来保驾护航。
二、评测范式演进:从“凭感觉点测”到“工业化流水线”
在货拉拉业务 Agent 评测体系的建设过程中,我们经历了三个阶段的演进:
| 演进阶段 | 核心特征 | 评测手段 | 痛点与局限 |
|---|---|---|---|
| 第一代:人工盲测与单点 Prompt 打分 | 依赖工程师人工单句提问,肉眼比对效果 | 少量 Excel 用例,单轮输入输出校验 | 覆盖度极低、主观性强、无法自动化回归 |
| 第二代:离线数据集与单一 LLM-as-a-Judge | 引入离线 Benchmark 数据集与大模型裁判打分 | 离线批处理脚本、单一相似度算法 | 裁判模型存在幻觉与自评偏见、脱离发布流水线、缺乏性能度量 |
| 第三代:全生命周期自动化评测平台 | 业务规则 + 智能裁判 + 拦截隔离 + CI/CD 门禁 + 性能压测 + 线上巡检 | 多元协议打通、动态流水线卡点、全链路多维基准度量 | 实现 Agent 可量化、可验证、可卡点、可进化的生产闭环 |
三、货拉拉业务 Agent 评测平台整体架构
为了让业务 Agent 在全生命周期中“进得来、测得准、卡得住、看得清”,货拉拉自研了 业务智能体评测平台,整体架构划分为五大核心分层与六大工程支柱:
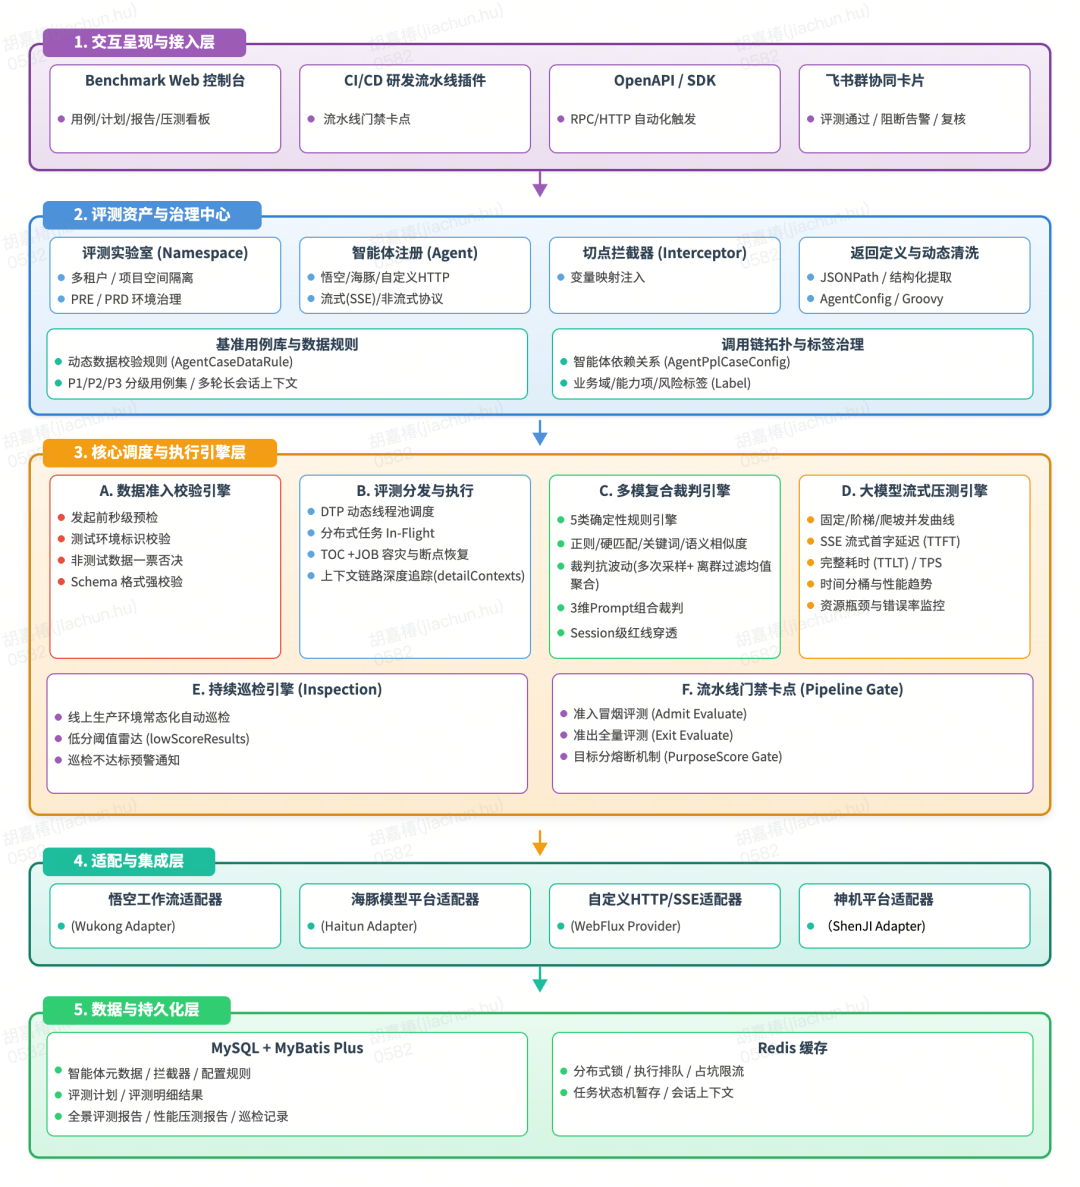
核心六大支柱与解决的问题:
| 支柱 | 要解决的核心问题 | 货拉拉评测平台的工程落地 |
|---|---|---|
| 支柱一:多元适配与资产管理 | 如何统一管理多业务场景、多模型平台及异构协议? | 实验室多租户隔离;适配货拉拉自研工作流/模型平台、自定义 HTTP 流式/非流式协议;三级切点拦截器(Interceptor)参数映射;Groovy/JSONPath 响应解析;调用链拓扑配置与多维标签体系。 |
| 支柱二:高保真执行与环境拦截 | 如何避免测试过程污染真实生产环境,并实现依赖隔离? | 测试数据校验规则引擎,动态用例规则校验;发起评测前批量预检与秒级拦截;非合规测试数据严禁发起评测。 |
| 支柱三:多模复合智能裁判体系 | 如何消除大模型裁判打分漂移、兼顾硬事实校验与长对话整体体验? | 内置5类确定性规则(语义相似度/关键词/硬匹配/正则/结构化校验);三维 Prompt 模板(平台/Agent/用例级)动态组合;裁判引擎多次采样均值抗波动;Session 级短板红线穿透与渐进加权综合评分。 |
| 支柱四:体系化评测计划与全景报告聚合 | 如何管理多版本评测目标、横向对比并产出业务可读的全景报告? | 评测计划目标管理与版本基线对比;智能体报告聚合打通功能与性能一体化看板深度集成发布系统;评测计划报告自动生成并推送飞书群,对接自研测试质量平台。 |
| 支柱五:大模型性能与稳定性压测 | 如何评估 Agent 在高并发与流式交互下的极限表现? | 自研 LLM 压测引擎;支持固定/阶梯/线性爬坡曲线;精确度量 TTFT、TTLT、RPS 及 Token 吞吐。 |
| 支柱六:CI/CD 门禁、追踪与闭环 | 如何无缝嵌入交付流水线,并实现长会话还原与低分缺陷归因? | 支持准入(Admit)与准出(Exit)评测,分数不达标自动熔断发布;低分专项筛选与专家人工复核闭环。 |
四、核心支柱的工程落地与技术细节
4.1 支柱一:全方位智能体资产治理与链路拓扑
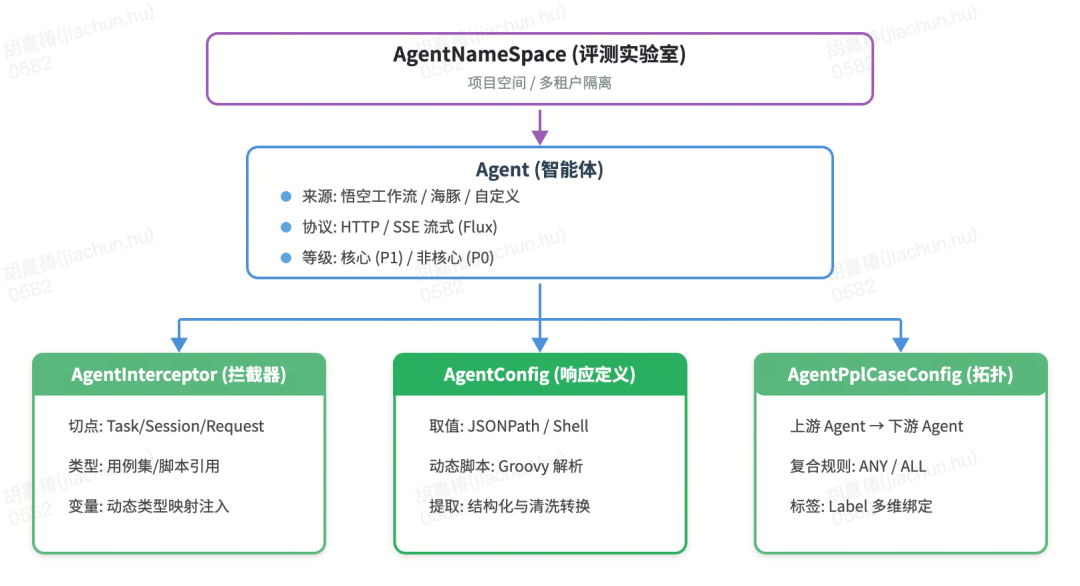
1. 实验室与多来源协议适配
不同业务线(客服、货运助手)对 Agent 的要求各异。平台通过评测实验室实现多租户隔离,并建立统一的 Agent 元数据模型:
- 命名空间与项目隔离: 按项目空间和业务线进行多租户资源隔离;
- 多平台纳管:无缝对接内部自研工作流/模型平台及自定义 Agent HTTP 服务;
- 版本与环境追踪:严密关联 Agent 的代码版本、Prompt 版本、知识库切片以及运行环境(PRE/PRD),保证任何一次评测结果都具备 100% 的可复现性;
- 流式交互与协议解析:原生支持非流式与 SSE 流式响应,支持 resultPath(JSONPath)与 resultType(Path / Shell)对多模态异构结果进行精准提取。
2. 参数动态映射与拦截器
在复杂的业务评测中,测试入参往往需要根据上下文动态计算或转换。平台设计了3类切点拦截器:
- 三级切入点:支持 TASK_BEFORE(任务执行前)、SESSION_BEFORE(多轮会话前)、REQUEST_BEFORE(单次请求前);
- 切点类型与变量注入:支持 AGENT_CASE(用例数据集动态注入)与 SHELL_REF(脚本动态引用),将计算产物强类型映射为 String、Number、Boolean、JSONObject 或 JSONArray,精准注入到 Agent 请求报文中。
-
动态返回参数取值与脚本清洗
针对 Agent 输出的非标准嵌套 JSON、Markdown 混杂或特殊格式,平台提供 AgentConfig 规则引擎:
- 嵌套 JSON的快速点选:页面调试后JSON格式的返回结果,支持快速点选提取response字段与通用字段映射;
- 内置 Groovy 脚本执行能力:支持在沙箱中动态运行清洗逻辑,将复杂输出结构化为标准评测载荷。
-
智能体调用链拓扑与标签体系
- 调用链拓扑配置:定义源 Agent 与下游目标 Agent 之间的调用关系,支持配置 ANY / ALL 复合匹配规则;
- 多维标签治理:在智能体维度建立“业务域、能力项、风险等级、用例类别”多维标签,支持按标签动态下发用例集与调用链路由。
4.2 支柱二:数据集测试数据合规校验与准入门禁
在业务 Agent 评测实践中,“垃圾数据输入,只会产生垃圾评测结果”。如果测试数据集未经严格校验就直接下发,极易引发严重问题:
- 数据污染与环境越界:误用线上未脱敏的生产数据或非测试环境标识,可能导致 Agent 在调用工具时发生非预期的真实写操作;
- 算力与 Token 浪费:用例格式错误(如必填字段缺失、JSON 语法不合法、参数类型不匹配)导致 Agent 在执行几十轮对话后因底层报错崩溃,白白消耗大量推理 Token;
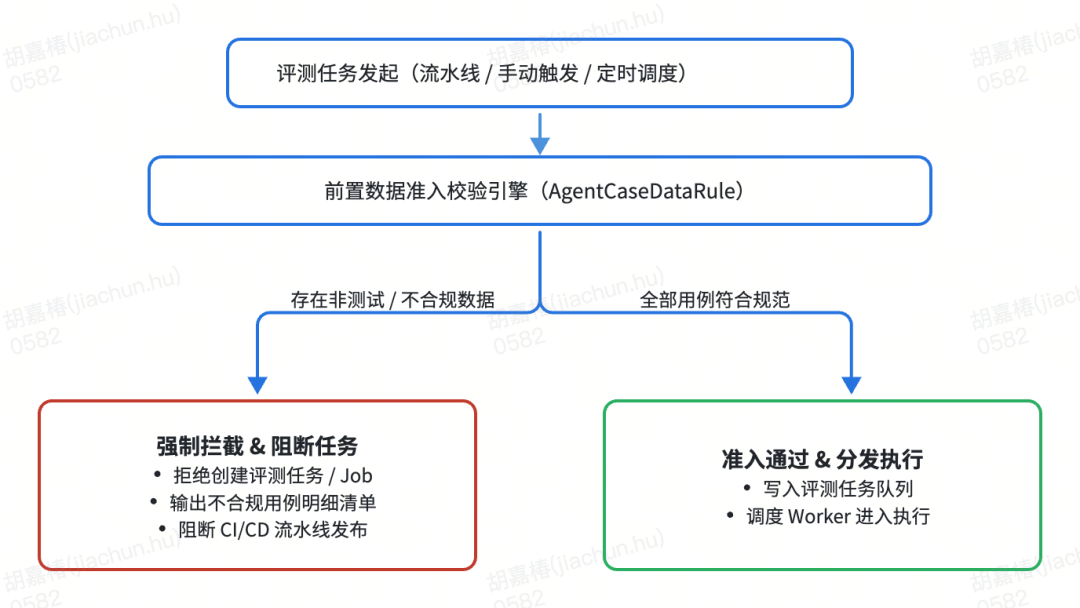
为此,平台构建了基于测试数据校验规则引擎 的严格前置准入卡点体系,全面推行“非合规测试数据一票否决,严禁发起评测”:
-
多维动态数据校验规则引擎
平台支持面向不同业务实验室与智能体场景,按需沉淀和配置细粒度的测试数据契约规则:
- 测试标识与环境合规性校验:强制校验请求参数中是否包含合法的测试环境标识,严禁未脱敏的线上真实数据或非测试账号混入评测集;
- Schema 与强类型约束:深度检查用例中的 Headers、Params、Body 是否符合目标 Agent 入参 Schema,包括必填字段完整性、字段类型、取值枚举范围以及 JSON 格式合法性;
-
发起前批量预检与秒级阻断
在流水线准入/准出触发或用户在平台点击“发起评测”的第 0 毫秒,系统会调用 checkAgentInfoAndCases 对所选数据集执行全量扫描:
- 零容忍熔断拦截:一旦发现哪怕 1 条用例不符合测试数据标准,直接阻断评测调度,禁止生成评测 Job,坚决杜绝“带病评测”;
- 精准定位与修复指引:返回清晰的校验诊断报告,明确告知具体是哪一条用例、哪个字段违反了哪项规则,引导用例维护者在前端快速修正,保障评测基准集的绝对纯净与高保真。
4.3 支柱三:多模复合智能裁判与多维评分体系
在传统评测中,单一的大模型裁判(LLM-as-a-Judge)往往面临三大痛点:裁判自身存在概率波动(打分漂移)、缺乏分层业务约束(打分规则一刀切)以及多轮对话孤立评判(割裂整体体验)。同时,对于订单号、金额、JSON 数据结构等强确定性事实,单纯依赖 LLM 判读容易出现漏检与误判。
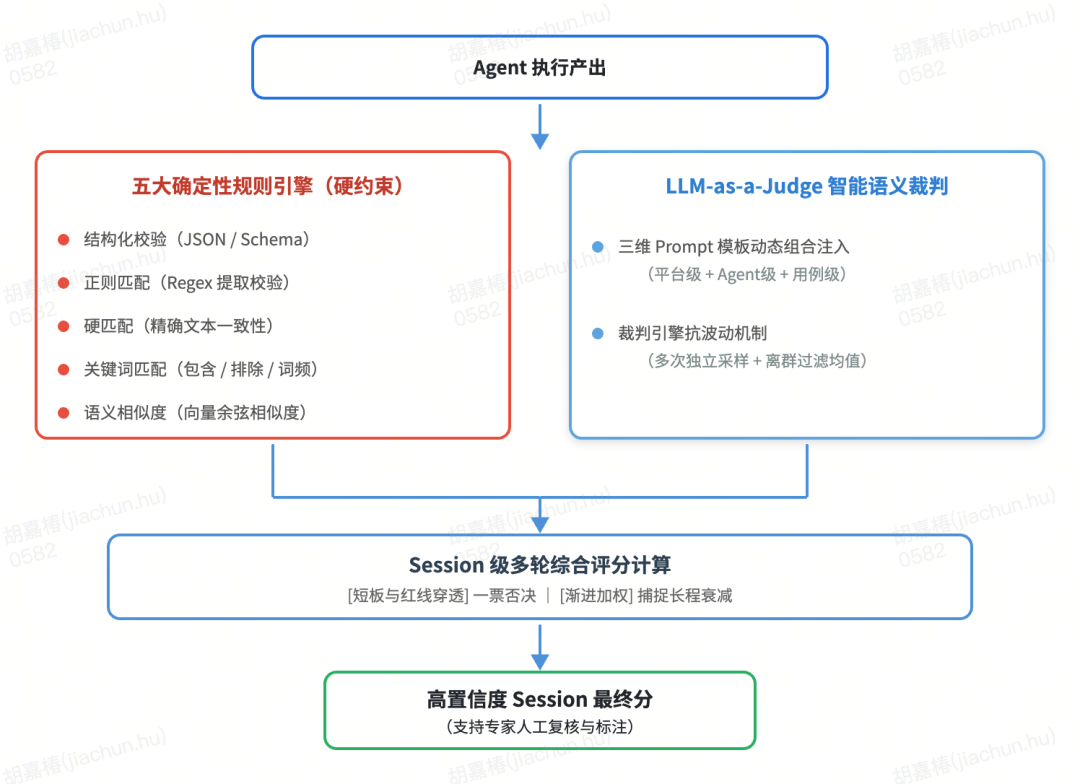
为了实现客观、精准、高可信的评测打分,平台打造了“内置五大确定性规则 + 三维 Prompt 组合裁判 + 裁判引擎抗波动 + Session 级红线穿透”的多模复合裁判评分体系:
-
五大内置确定性规则引擎(精准硬约束打分)
对于确定性强、容错率低的业务场景,平台内置了 5 种高效的规则断言算法,直接由计算型引擎执行,提供毫秒级、零幻觉的客观评分:
- 结构化校验:深度校验 Agent 输出的 JSON / XML 格式合法性、字段完整性、Key-Value 数据类型及嵌套 Schema 契约,特别适用于 Tool Calling 入参生成与结构化报表场景;
- 正则匹配:通过预置或自定义正则表达式,精准校验订单号、手机号、车牌号、金额数字、日期格式等关键业务实体的提取与表达准确率;
- 硬匹配:针对标准枚举值、固定系统指令、特定操作返回码执行严格的字面全等判定,不容许任何字符偏差;
- 关键词匹配:支持“必须包含词(Must-have)”、“禁止违规词(Must-not-have)”以及命中词频阈值配置,用于服务禁言、红线合规与关键话术覆盖度校验;
- 语义相似度:基于文本嵌入向量(Embedding)计算 Agent 回答与标准参考答案(Golden Reference)的余弦相似度(Cosine Similarity),快速判定大段非结构化文本的语义贴近度。
-
三维 Prompt 模板动态组合体系
为了让裁判大模型既具备全局通用尺度,又能深入理解特定业务域的深层约束,平台设计了分层动态注入的 Prompt 模板体系,打分时按组合规则自动拼装成最终的 Judge Prompt:
- 平台级模板:沉淀全局通用的评测元规则,包括标准打分尺度(0~100 分制定义)、事实性与幻觉判定准则、结构化打分理由(Reasoning)与扣分点输出格式;
- Agent 维度模板:注入具体业务 Agent 的角色定位、业务边界与专业规范(如客服话术风格、运力调度决策口径、赔付承诺权限等);
- 用例维度模板:绑定单条测试用例的特定上下文、意图判定要点(Rubric)、期望提取参数及特定业务场景的判定逻辑。
三层模板解耦维护与沉淀,打分时按需组装,避免了每个用例都重复编写冗长背景的维护成本,确保评判标准的结构化与统一性。
-
裁判引擎抗波动机制
针对大模型自身打分存在概率波动、温度敏感等问题,平台在裁判底层实现了抗波动评判引擎:
- 并发多次采样:对单条评测产出,后台并发下发多路独立的裁判请求(支持相同或异构 Judge 模型);
- 离群过滤与均值聚合:自动识别并剔除偏离度过大的异常极值打分,对有效置信区间内的打分进行加权均值聚合,产出高稳定性的最终分与综合裁决说明;
- 方差监控与置信度熔断:若多次采样打分的方差超过设定阈值,系统判定该样本存在打分争议,自动推入人工复核池,防止裁判自身的不确定性影响评测基线。
-
Session 级多轮综合评分:短板与红线穿透原则
在复杂的多轮对话交互中,孤立地对每一轮 Query-Response 进行单点打分再算术平均,往往会掩盖关键阶段的业务崩溃(如:前 9 轮服务完美,第 10 轮突然向用户泄露商业底价或给出违规承诺)。
平台在会话(Session)级度量中引入了端到端综合评分算法:
- 红线与短板穿透原则:
在多轮对话的任意一轮中,一旦触发超级红线违规(如违规承诺、敏感数据泄露、越权写操作)或核心步骤发生严重错误(短板得分触底),该单项扣分将直接穿透至整个 Session 的全局最终总分(一票否决或封顶惩罚),真实反映端到端的业务可用性;
- 渐进加权平均分:
多轮对话中,随着上下文不断拉长,Agent 发生“上下文腐烂”和意图漂移的概率呈指数级上升。系统采用前轻后重的渐进权重曲线,对话越靠后的轮次赋予越高的打分权重,深度考验 Agent 在长程交互中的持久记忆与逻辑韧性。
-
客观评测与主观评测并行:人工校准 + 自动放大的闭环
在 Agent 评测体系中,单一的自动化打分或纯人工评判都有其固有局限。平台构建了 “ 客观评测守底线、主观评测拉上限、人工校准做放大 “ 的三位一体评分体系,兼顾效率与质量:
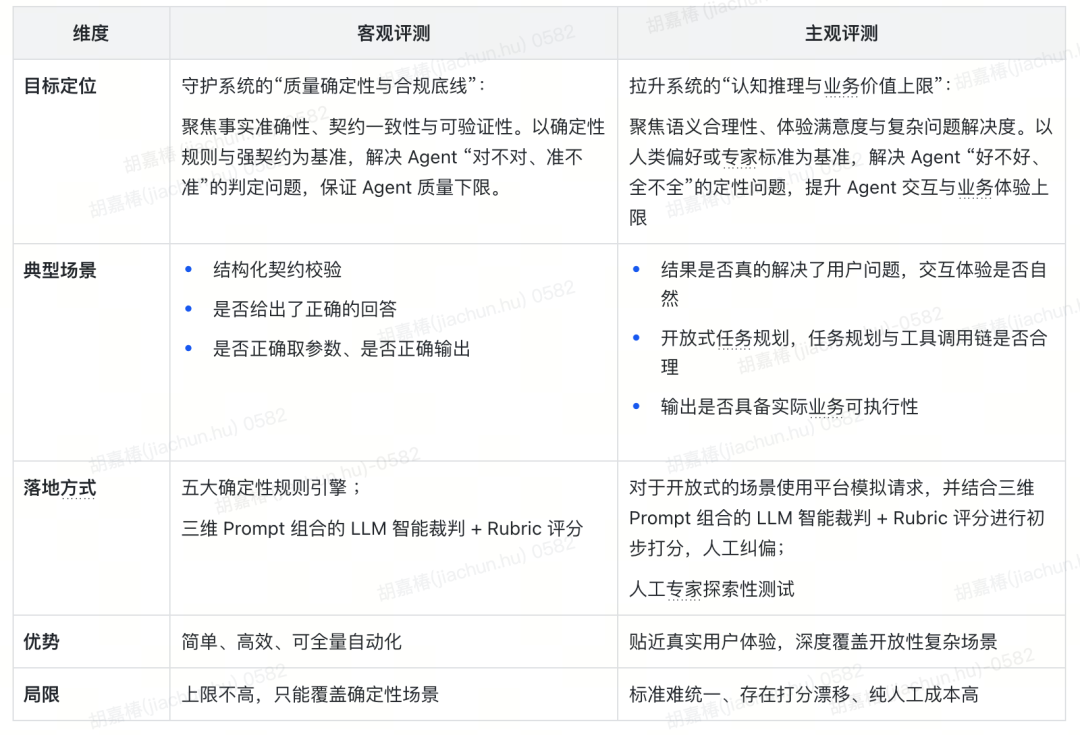
更现实的做法是将两者有机结合,并通过人工复核形成持续进化的闭环:
- 客观评测覆盖高频、结构化、可规则化的部分: 由确定性规则引擎执行,守住质量底线,实现全量、毫秒级自动化校验;
- 主观评测覆盖开放性、高价值、复杂业务场景: 由多模复合智能裁判(三维 Prompt + 抗波动引擎 + Session 级综合评分)执行,拉升体验上限;
- 人工复核校准 + 自动放大:对于争议用例、红线触发样本或重点业务版本,业务专家通过可视化复核工作台进行人工打分与标注;人工修正的样本自动沉淀为黄金对齐数据集,反哺迭代裁判 Prompt 与评分规则,形成”人工定标 → 规则沉淀 → 自动放大”的持续进化闭环。
4.4 支柱四:体系化评测计划与全景报告聚合
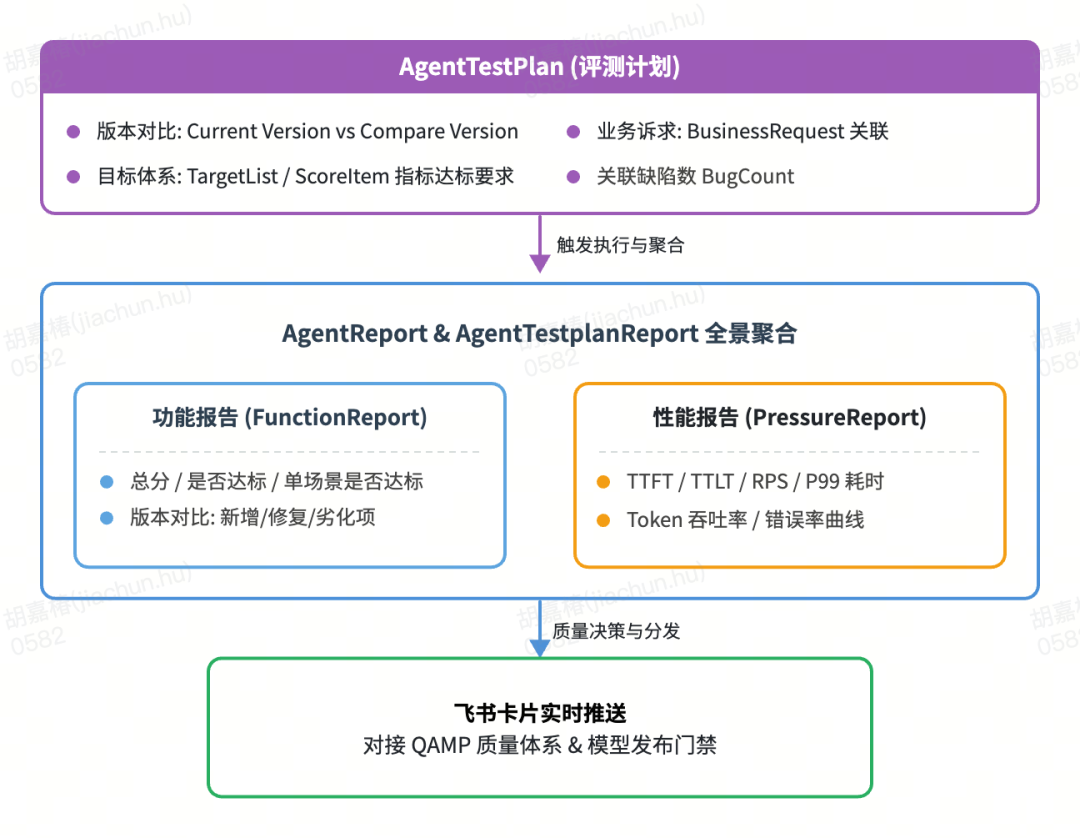
将评测能力嵌入到研发交付的 CI/CD 流水线中,是消灭“带病上线”的核心防线:
-
评测计划与版本对比基准
:
- 目标体系量化:支持针对不同业务能力项设定目标分与权重,自动计算加权达标情况;
- 业务诉求与缺陷关联:关联业务需求与缺陷统计,使评测计划成为研发与业务协同的共同语言。
- 版本基线横向对比:显式关联当前版本与对比基线版本,直观度量 Prompt 迭代、模型升级前后的分数波动;
-
功能 + 性能 + 安全 一体化全景报告
- 全景聚合看板: 将智能体元数据、响应配置、功能评测明细、性能压测数据与安全方面表现深度整合,形成一站式评测画像;
- 多渠道即时推送:评测结束后自动生成 ,支持一键推送到指定的飞书群组。
4.5 支柱五:大模型性能与稳定性压测引擎
针对业务大模型在长文本、流式输出、高并发场景下的性能瓶颈,平台内置了自研的 LLM 性能压测引擎:
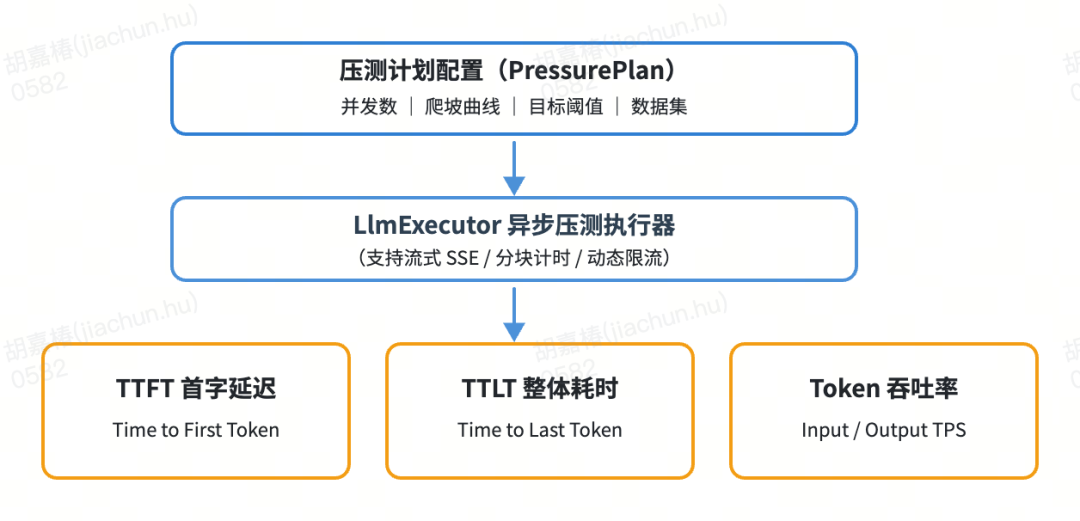
1. 核心特性
- 多元压力曲线:支持固定并发、线性爬坡,真实模拟业务早晚高峰流量;
- 流式精准计时:针对 SSE 流式响应,精确捕捉首 Token 到达时间(TTFT)与完整文本生成时间(TTLT);
- 压测指标大盘:响应耗时(RT)、首字延迟 (TTFT)、吞吐量(RPS)、完整耗时 (TTLT)和请求失败率,助力容量规划与模型选型 。
追踪与闭环
4.6 支柱六:CI/CD 门禁、
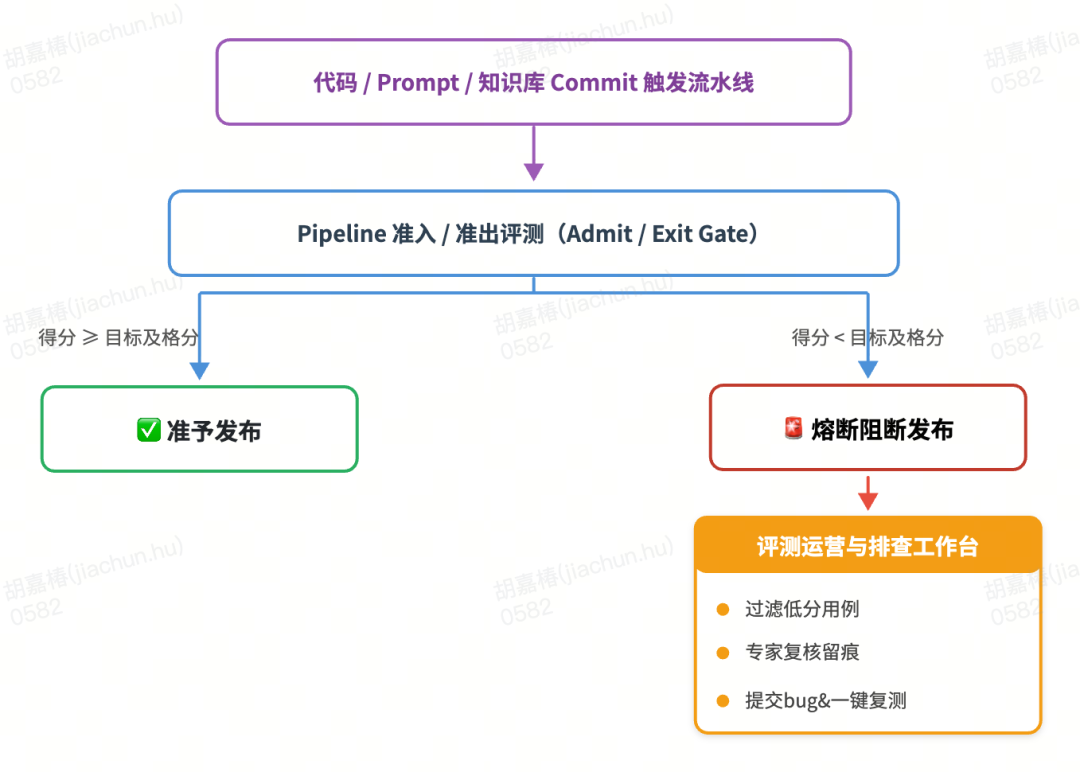
评测的核心在于闭环。平台通过深度嵌入交付流水线与提供完善的排查工作台,保障 Agent 长期运行质量:
-
CI/CD 流水线准入准出门禁
- 准入评测:在合并代码或变更 Prompt 时自动触发核心冒烟用例集;
- 准出评测:发布前执行全量基准测试,自动比对目标分数(
purposeScore)。若分数不达标,流水线直接返回FAIL并阻断发布,彻底消灭“带病上线”。
-
低分专项筛选与缺陷闭环
- 低分雷达:支持按分数阈值快速拉取低分用例列表,精准聚焦缺陷;
- 人工复核与标注:业务专家可在工作台对争议结果进行二次复核与改分,修正样本自动沉淀为裁判模型的优化数据;
- 常态化巡检:线上分钟级自动巡检生产环境 Agent,发现异常即时告警,实现质量长效守护。
五、效果与收益
货拉拉业务 Agent 评测平台上线以来,已在客服、运力调度、数据研发等多个核心业务场景中常态化运行,取得了显著的效能与质量收益:
| 关键收益指标 | 建设前(人工/简单脚本) | 建设后(QA Benchmark 平台) | 提升幅度 / 效果 |
|---|---|---|---|
| 版本回归评测耗时 | 天级人工逐轮验证 | 小时级全自动回归 | 效率提升 5~10 倍 |
| 上线质量合格率 | 约 78%(上线后频繁打补丁) | 98.5%
(流水线强制门禁拦截) |
线上缺陷率下降 85% |
| 复杂场景 Bug 检出率 | < 40%(仅能发现明显语法错) | 92%
(复合裁判 + 拦截器校验) |
深度逻辑缺陷拦截能力翻倍 |
| 压测与容量摸高 | 无法模拟流式 TTFT 与高并发 | 支持分钟级产出 P99/TTFT/TPS 全套指标 | 支撑大促高峰流量平稳度过 |
5.1 规模化运营成绩单
自平台全量上线以来,已全面覆盖公司核心智能体的评测与质量管控需求,形成了 “ 规模纳管 → 多维评测 → 缺陷拦截 → 基础设施支撑 “ 的全链路闭环,实现了 AI 应用质量从”凭感觉上线”到”看数据迭代”的根本性转变。
| 维度 | 关键指标 | 数据 | 价值解读 |
|---|---|---|---|
| 规模纳管 | 接入智能体数 | 114 个 | 全面覆盖公司核心 AI 业务与专项场景,统一纳管 |
| 黄金评测集沉淀 | 16,337 个 | 高质量标准资产库,奠定高效回归与基准度量基础 | |
| 核心 AI 应用发布管控 | 100% | 公司核心 AI 平台发布关键节点全覆盖 | |
| 质量保障 | 功能评测执行 | 11,063 次 | 常态化自动回归,保障高频迭代下模型效果不退化 |
| 前置拦截缺陷数 | 669 个 | 前置拦截问题,保障上线零故障 | |
| 安全合规 | 安全注入触发 | 45 次 | 安全对抗与注入,有效拦截安全合规风险 |
| 性能韧性 | 压测次数 | 307 次 | 并发验证,保障高峰期业务高可用 |
| 故障注入演练 | 1 次 | 演练线上自愈与降级能力,提升系统容灾韧性 |
5.2 缺陷拦截:从”上线救火”到”前置防线”
平台前置拦截的缺陷中,覆盖了智能体全链路的六大类问题:
| 问题大类 | 典型场景 | 占比 |
|---|---|---|
| 意图与指令理解 | 意图识别错误、指令忽略/漂移、语义理解偏差 | 33.84% |
| 智能体与工具执行 | 工具调用幻觉、执行死循环、状态记忆不同步 | 31.12% |
| 回答准确性 | 事实性幻觉、检索漏召回、逻辑推理断层 | 25.38% |
| 性能与响应体验 | 首 Token 超时、全量超时、输出抖动 | 5.44% |
| 格式与输出规范 | 格式规约破坏、生成重复死循环、流式解析报错 | 2.72% |
| 安全合规 | 提示词注入/越狱、敏感信息泄露、过度拒答 | 0.91% |
| 其他 | 误操作、重复提交 | 0.59% |
核心洞察:
- 意图理解 + 工具执行 占比超 65%,是 Agent 质量问题的主战场——这也正是传统”单点打分式评测”最容易漏掉的部分(传统评测只看最终答案对不对,不关心中间链路是否正确)
- 随着接入规模扩大,前置拦截 Bug 数呈持续上升趋势,防线关口效应持续放大
5.3 业务实战:AI 邀约的效能跃迁
以 AI 邀约业务 为例,接入评测平台后,在需求吞吐量翻倍(+80%)的背景下,实现了线上质量与研发效能的双重提升:
| 核心指标 | 灰度前 | 灰度后 | 变化 |
|---|---|---|---|
| 月均需求吞吐 | 2.2 个 | 4.0 个 | 需求量增加+80%,支撑业务迭代节奏显著加快 |
| 月均发布次数 | 33 次 | 14 次 | 单次发布质量大幅提升
(发布下降57% ),杜绝盲目反复发布 |
| 月均质检 Badcase | 439 个 | 351 个 | 上线质量提升,线上体验明显改善(减少20%) |
| 算法投入人力 | – | 释放 41.5 人天/月 | 降本提效 |
一句话总结:在交付效率提速、线上质量守住的前提下,业务指标不降反升 —— 这才是质量平台真正的价值:不是拖慢迭代,而是让快迭代更有底气。
5.4 全场景覆盖:从高频回归到深度探隐患
平台已全面打通自研工作流平台、大模型、自定义 Agent 协议等多元异构入口,以功能、性能、安全及自动化流水线等多维评测能力,覆盖了公司不同类型的智能体场景。
从护航模式来看,形成了两类典型范式:
- 高频防退化型(代表:AI 促增长)—— 迭代频繁、回归量大,平台承担”高强度自动回归”角色,确保核心主流程稳定不退化
- 深度探隐患型(代表:降外投 / AI 邀约)—— 场景复杂、工具链深,平台凭借丰富的场景用例和多模裁判能力,深度挖掘复杂工具调用中的隐蔽异常
头部 3 个重点项目(AI 促增长、降外投、AI 邀约)贡献了近 85% 的评测量,并成功拦截了 60% 的核心质量缺陷——验证了平台既能扛住海量高频回归的吞吐压力,又具备针对复杂 Agent 的深度探测能力。
六、未来演进与思考
业务 Agent 评测依然处于快速发展的技术前沿,随着 Agent 走向更深度的自主协同,评测平台将在以下三个方向持续演进:
- 从“静态用例”走向“Agent 对抗评测(Agent-vs-Agent Evals)”
利用对抗生成网络思想,由专门的“红队进攻 Agent”动态生成刁钻、对抗性的边缘用例与多轮对话陷阱,持续对业务 Agent 进行自动化压力对抗。
- 多 Agent 协同系统(Multi-Agent System)链路评测
当业务架构从单 Agent 演变为“协调者 + 多个专业子 Agent”时,评测重点将从单体输出质量扩展至:Agent 间通信效率、协作死锁检测、任务分解合理性及全局状态一致性。
-
评测驱动的自适应优化(Eval-Driven Auto-Tuning)
将评测结果直接连接到 Prompt 自动调优器与模型微调数据飞轮,实现当评测分数低于阈值时,系统自动提炼失败样本、优化 Prompt/Few-shot,实现真正的“自我迭代与自愈”。
结语
在 AI 原生应用的研发范式中, “没有度量,就没有改进;没有评测,就没有交付。”
模型赋予了 Agent 思考的火花,而评测平台与 Harness 工程则为 Agent 构筑了通向生产的轨道与缰绳。货拉拉将持续深化在 AI 质量工程领域的探索,让每一个业务 Agent 都经得起生产检验,交付扎实、可信的业务价值!
本文作者@货拉拉技术。原文链接:https://mp.weixin.qq.com/s/KnPWPfb6YEKmbGNgLniAMg?nwr_flag=1