昨天下午,腾讯云宣布元宝搜索正式对外开放。
看到标题我愣了一下:腾讯又要做搜索?
搜索算是腾讯的老伤疤了。2010年谷歌退出中国,外界普遍觉得腾讯能捡个大便宜,腾讯也确实挖来几位谷歌高管,两年往搜索里砸了约20亿元,最后没做起来。2013年搜搜并进了搜狗,2021年腾讯干脆把搜狗整个买了下来。这么多年,百度的位置一直没动过。
不过这次的元宝搜索没有搜索框,压根不是给人用的。它卖给开发者,让大模型和Agent去调:发一个检索词过去,拿回一段JSON,里面是排好序的结果、摘要和相关性得分,模型拿到就能用。
官方数据是千亿级索引,日均调用几亿次,腾讯内部已经有WorkBuddy、ima、腾讯视频、腾讯金融科技等50多个业务在用。腾讯管它叫给AI用的”搜索水电煤”。
腾讯这回卖的搜索,客户是AI Agent。
01、Agent不看广告
过去二十多年,搜索引擎基本只有一种赚钱方式:用户免费搜,广告主买排名,用户点一下就有钱进账。
前提是看结果的是人。Agent不点广告,也不在意结果页长什么样,拿到信息就接着干活,广告在它这儿没用。
所以元宝搜索按调用次数收钱,付钱的是开发者和企业。
微软去年8月关掉了公共的Bing Search API,让开发者改用Azure里给Agent准备的联网能力,走的也是这个方向。
调用量是另一个原因。腾讯给的说法是,Agent的一次提问通常会拆成3到5个子问题,中间还可能调10多个外部服务。一个人一天也许搜十几次,Agent干一个活就要搜好几轮。WorkBuddy、TRAE、Qoder这类工具用的人越多,搜索调用涨得越快。
02 、元宝搜索做了哪些事
我是做产品出身的,更好奇的是:用户换成Agent以后,搜索这个产品要改哪些地方。
腾讯的判断是,大模型有三个短板靠自己补不上:会编造,不知道训练截止之后的事,不懂行业黑话,只能靠搜索来补。他们对搜索提了四个要求:准确、权威、时效、高速。
准确,说的是听懂问题。”苹果”是水果还是手机,”北京机场”是首都还是大兴,元宝搜索用大模型去理解口语、错别字和指代不清的说法。像”明天北京飞上海的航班”这种问题,它会把城市名转成航班接口要的机场代码。
权威这块我觉得最要紧。人看到一个网站,大概能判断靠不靠谱、是不是软文,Agent判断不了,很容易把垃圾内容当事实讲出来。腾讯的原话是,低质内容会喂出幻觉。
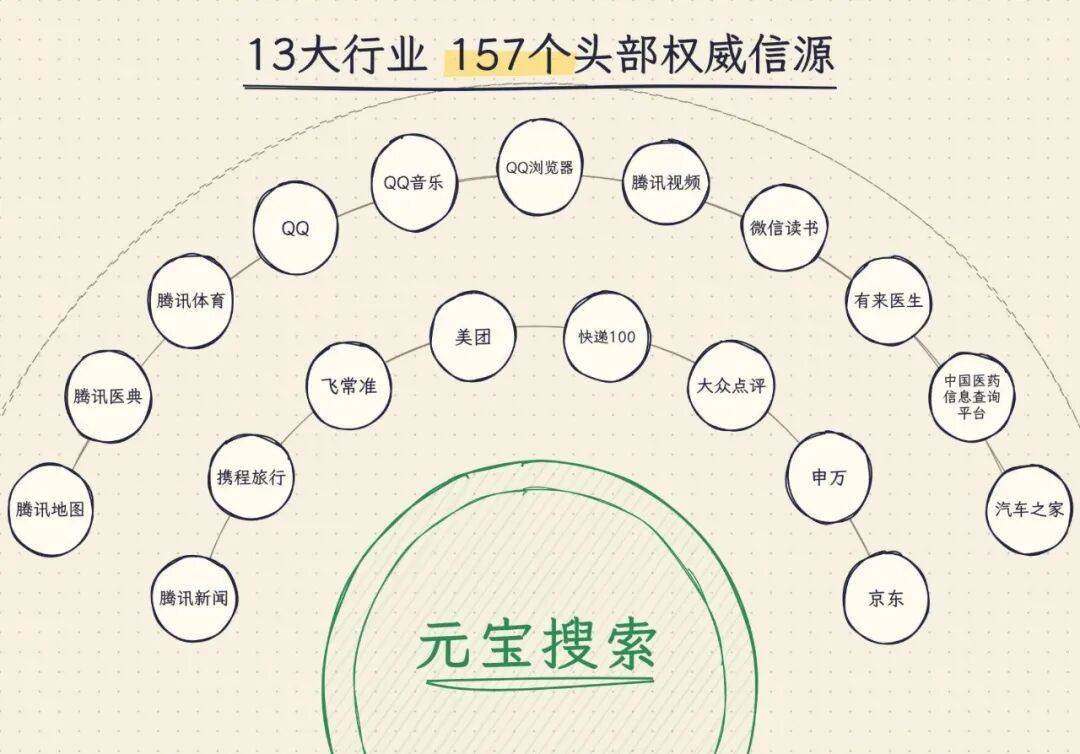
他们的办法是在入库时就把关:先用大模型解析网页、保留原始结构,再按站点、账号、页面三层打质量分。另外接了13个行业的157个头部信源,自家的有腾讯医典、腾讯地图,外部的有京东、美团、携程、申万宏源、飞常准。A股、港股、美股、日股、韩股的财报收录覆盖率在99%以上。
时效和权威是绑在一起的。财报、赛程这种东西,晚一小时就是错的,所以新闻、行情做到了分钟级更新。排序时还会看问题类型:问热点,时效的权重高;问知识、政策,权威的权重高。旗舰版会直接给每条结果标一个权威度等级。以前的搜索引擎没必要给这个字段,人自己会判断,模型不行。
速度的压力来自 Agent 的工作流。 人的搜索是一次性的,但 Agent 的一次提问通常会拆成 3 到 5 个子问题。哪一步慢了,整个任务都得等,用户体验就会极度卡顿。为了压低延迟,元宝搜索在底层索引架构上做了大量融合优化,把平均检索耗时压到了 8 毫秒。
还有 PM 最关心的商业化成本(ROI)。 排序模型读全文最准,但全文又长又贵(Token 消耗大)。元宝搜索用了一个很巧的产品策略——Gist Token 压缩:提前把每篇长文档压成 100 个 token 存起来,排序时直接拿来用。整套推理框架优化下来,单位推理成本降了 90%。成本降下来了,对外售卖的 API 定价才能有竞争力。
03 、没有点击数据以后
这次分享里,对做产品的人最有启发的,是搜索引擎怎么判断自己搜得好不好。
以前靠点击。用户点了哪条、停了多久、有没有回来重搜,搜索引擎靠这些数据调了二十年。Agent不点击,读完结果就直接写答案。
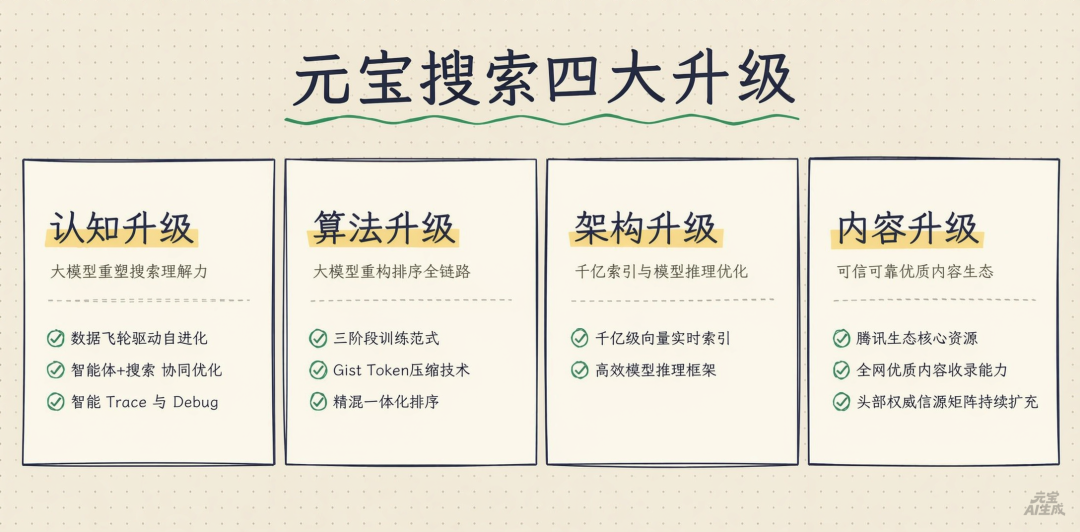
元宝搜索的做法叫Agent Co-design,腾讯叫它”智能体协同进化”。搜索这边把权威等级、发布时间、满意度这些信号交给Agent,帮它挑引用;Agent那边把引用了哪些文档、思考过程、最终答案好不好回传给搜索,排序模型再照着调。优化的目标,从”人会不会点”换成了”模型会不会引用、答案有没有变好”。
迭代也跟着快了。以前人工标注、手工调参,一个月评估一次;现在机器造样本、大模型教小模型、模型给模型打分,周期从月缩到周,再到天。线上出了问题,AI会沿着检索、生成、排序自己找原因、热修复,以前排查要几个小时,现在几分钟。
参数别人能追,这一套评估和迭代流程得从头搭,我觉得这部分更难抄。
04 、在腾讯内部先跑了一年
元宝搜索在腾讯内部已经跑了一年,每天扛几亿次调用。腾讯有句话我挺认同:选大模型是短期的事,搜索要做好得磨很多年。
它也不算新产品。腾讯云的”联网搜索API”早就有了,这次升级后挂上”元宝”的名字正式开放。挂这个名字挺聪明,企业买AI能力最怕演示好看、上线拉胯,”元宝在用的搜索”比什么宣传都直接。
内部在用的产品一长串,元宝、WorkBuddy、ima、QQ浏览器、QQ音乐、搜狗输入法、腾讯视频、腾讯医典、腾讯游戏、腾讯客服都在里面。公开了效果的有这么几个。
WorkBuddy接入后意图理解更准,完成任务需要的工具调用和模型轮次更少,团队也不用再自己维护信源和抓取链路。
ima做了公网信息加私域知识库的混合问答,有效信源召回量提升了大约10%。
腾讯视频的AI搜索补上了全网信源,信息覆盖度扩了20%,次留和人均搜索次数都在涨。腾讯金融科技只用一周,就搭出了一套金融搜索。
50多个业务的需求差别很大,等于先替外部客户踩了一遍坑。亚马逊当年也是先在自家电商里把基础设施用顺了,才有了AWS。
05 、商业化算账:别只看单价,要看任务 ROI
很多人挑搜索API,先看千次单价。放在Agent上这么比不太准,因为钱是按任务花的。
结果不准,Agent就得换关键词再搜、多抓几个网页、多跑几轮推理,每一轮都花钱,用户也在干等。WorkBuddy说的”工具调用和模型轮次更少”,省下来的就是这部分。
具体怎样,还得拿自己的问题去测。元宝搜索每月有2000次免费额度,使用评论区的福利激活码,可以提升到6000次/月。付费刊例价从极速版的14元/千次到旗舰版的26元/千次,旗舰版多了权威度等级,只对企业开放。
接入有三种方式。Skill是一句提示词,适合WorkBuddy这种Agent工作台,官方说10分钟能跑通第一个联网Agent;MCP是一段JSON,TRAE、Qoder这类AI编程工具配一下就能用;API是一个请求,适合在自研产品里深度集成。
06、做AI产品的 PM,以后拼什么?
以前做 AI 产品,PM 得求着研发去搞爬虫、做索引、调排序,天天跟反爬机制斗智斗勇。现在接个元宝搜索的 API 就行了。
脏活累活大厂包了,难的部分就全挪到了产品设计上: 哪些场景该触发搜索?一个复杂意图怎么拆解成多个检索词?哪类信源在你的业务里更可信?引用来源怎么在 UI 上展示,用户才会产生信任感?
以后 AI 产品体验的差距,不再是底层大模型智商的差距,而是 PM 在这些业务逻辑和信任阶梯设计上的差距。
做内容的人可能要想得更多一点。我做了十几年产品经理社区,看完元宝搜索的排序特征,第一个念头是:以后读我们内容的,会有越来越多的模型。
它看的东西挺具体:质量上抓作弊、低质、文不对题;权威上看作者领域、互动、站点PR;另外还看页面结构和更新时间。腾讯举了个光明网的例子,模型会读这个账号的发文量、认证主体和域名,判断出”权威等级:高”,还写出理由。判断信源靠不靠谱,现在已经是模型在做了。
所以站点和账号长期攒下的信誉,会比偶尔一篇爆款更值钱。结构清楚、信息密度高的内容更容易被读懂;注水的内容压成100个token,可能剩不下什么有用的。
腾讯讲权威信源时还明确说了,不要虚假捏造,更不要AIGC生成的内容。拿AI批量洗稿、堆数量的号,在AI搜索里大概率最先被筛掉。
以前大家抢首页排名,以后要争的是进入AI愿意引用的那批信源。
07 、做个总结
人类搜索的仗打在搜索框上:用户习惯、浏览器默认引擎、手机上的入口。
Agent没有使用习惯,只看开发者在配置文件里写了谁。这回腾讯手里有自家内容、157个权威信源、50多个业务一年的磨合。它也不只想给Agent送资料,在金融、医疗、出行、电商这些领域,还想把信息一路连到决策和下单。
能不能成,要看开发者在自己的场景里用下来准不准。在做Agent产品的朋友,可以趁10月、11月的免费额度,拿业务里最难搜的20个问题试一试。
本文由作者@人人都是产品经理,授权发布于平台,未经许可禁止转载。