
业务 Skill 的一次修复,往往从一个失败 Case 开始:看执行过程、找到遗漏的规则、修改 SKILL.md,再跑一遍评测。随着业务场景增加,这种方式会遇到两个问题:修好一个场景时可能破坏另一个场景;连续多次修改后,很难判断哪个版本更好,以及收益来自哪条规则。
我们尝试把这个过程组织为可追溯的搜索闭环:用黄金评测集、Ground Truth 和执行轨迹生成反馈,让模型提出受控修改,再通过全量评测决定是否保留。模型负责提出候选,确定性程序负责边界校验、版本比较和状态维护,人负责业务边界与最终交付。
本文结合业务 Skill 工作台的 Skill 自进化设计,依次介绍方法选择、全局流程、候选池、Module 划分和归因变异提示词。文中的算法与配置保留到可讨论、可实现的粒度,同时说明当前实现与完整设计之间的边界。
方法选择:为什么采用 GEPA 的反思搜索思路
我们选取四篇 Agent/Skill 自进化相关论文,结合已有黄金集、Trace 和 rubric 链路做横向对比。对比的重点是优化信号、编辑范围、候选验证和工程适配;各论文的实验收益不能直接当作本项目的业务收益。
| 论文 | arXiv 链接 |
GEPA |
https://arxiv.org/abs/2507.19457 |
SkillOpt |
https://arxiv.org/abs/2605.23904 |
EvoSkill |
https://arxiv.org/abs/2603.02766 |
Trace2Skill |
https://arxiv.org/abs/2603.25158 |
| GEPA ✅ | SkillOpt | EvoSkill | ||
Trace2Skill 方法 |
基于执行轨迹与自然语言反馈反思并提出候选,搜索和利用具有互补能力的版本;本项目进一步采用逐 Case 比较与全局候选池 | 以受控的增删替换编辑更新 Skill,使用文本学习率预算、拒绝编辑记录和独立验证分数约束优化 | Executor、Proposer、Skill-Builder 三个角色分工:执行任务、诊断失败、生成或修改 Skill,再通过验证选择候选 | 批量收集执行轨迹,分别分析失败与成功经验,提出局部补丁,再分层合并为一致的 Skill 更新 |
优势 |
轨迹反思与现有 Ground Truth、rubric、Trace 链路适配;可以搜索不同 Case 上的互补优势。本项目 MVP 先收敛到 SKILL.md | 改动受控,不容易把 SKILL.md 越改越长、越改越差 | 角色职责清楚,支持生成结构化 Skill 文件夹及辅助脚本,修改可追溯 | 批量分析与补丁合并便于利用大量已有轨迹,适合沉淀初版 Skill 或做批量增强;实际速度取决于并发与数据量 |
劣势 |
每个新版本都要在验证 case 上重新评测,耗时较长 | 需要额外维护编辑预算、训练与验证组织、拒绝历史及慢更新机制;是否值得引入要结合本项目预算测量 | 多角色编排和 Skill 文件夹生成增加工程复杂度;论文实验使用 Claude Code,但框架并不只限定该环境 | 核心是批量轨迹分析与合并,并非本文的候选评分搜索循环;若要多代搜索,需要增加候选验证与选择编排 |
选择 GEPA 思路,主要因为我们已经具备黄金评测集、标准答案、完整执行轨迹和结构化评分,可以复用这些资产建立反思与验证闭环。同时,候选池能够保留不同 Case 上的局部优势,避免搜索过早收敛到单一版本。
需要区分论文方法与项目实现:本文的单 Module 修改、每个候选全量评测、直接父子入池规则和确定性贪心覆盖,是结合业务约束形成的 GEPA-style 工程设计,不全部等同于原论文的固定规则。
技术设计:从一次修改到多代搜索
2.1 全局流程
整体流程沿用 GEPA 的核心思想:以黄金评测集上的评测结果和执行轨迹为原始信号,先生成逐 Case 反思反馈,再由反思、归因并产生变异,通过多轮“选择—反馈生成—反思变异—全量评测—择优保留”持续搜索更优的 Skill 版本。进化期间冻结黄金集、Ground Truth、rubric 身份、模型和执行配置,让各版本尽可能在同一口径下比较。服务端动态数据与模型随机性仍需通过运行证据和复测披露,不能仅凭配置冻结就认为所有波动已经消失。
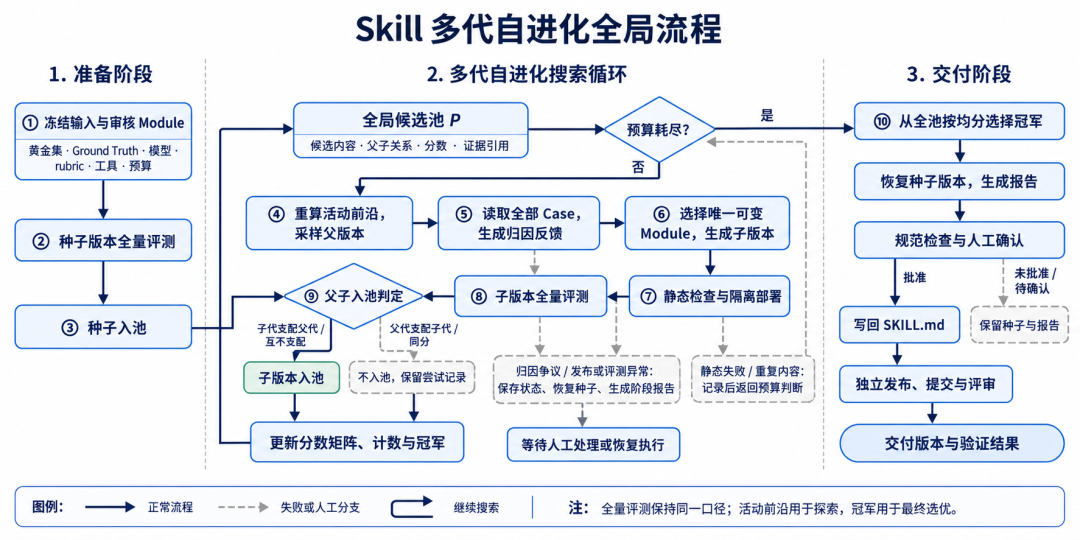
整体流程分为以下步骤:
- 进化准备:确定本轮要优化的 Skill,冻结黄金评测集、评测标准、执行模型、工具与运行环境,并设置最大生成轮次与子候选评测预算,完成 Module 人工审核。基线评测与模型反思成本应另行记录。
- 初始版本全量评测:使用当前 Skill 并发运行全部黄金 case,记录每个 case 的执行轨迹和结构化评测结果,包括总分、逐维度得分、原子问题答案及判分证据,形成版本比较的基线。评测阶段本身不生成面向 Skill 优化的反思反馈。
- 选择父版本:从当前已经保留的版本中选择一个父版本,作为本轮继续探索的起点。父版本已有的全量评测产物直接复用,无需重复运行。
- 生成反思反馈:读取父版本的逐 case 执行轨迹和结构化评测结果,并结合黄金评测期望,生成供反思 LM 使用的逐 case 反思反馈。该反馈是自进化流程根据评测产物生成的派生数据,不是现有评测系统直接保存的字段。
- 反思与生成子版本:基于逐 case 反思反馈进行归因,生成一个新的子 Skill 版本。本步骤只负责提出一次定向变异。
- 有效性校验与隔离部署:确认子版本结构完整、能够被正确加载和执行,然后部署到隔离的评测环境,避免影响当前正式版本。
- 子版本全量评测:对新子版本并发运行全部黄金 case,得到与父版本口径完全一致的逐 case 分数、执行轨迹和结构化判分结果。评测完成后不立即额外生成反馈;该版本后续被选为父版本时,再进入反馈生成步骤。
- 父子入池判定:比较子版本与直接父版本的逐 Case 分数,不比较全量平均分。若父版本在所有 Case 上均不差于子版本,并且至少在一个 Case 上严格优于子版本,则父版本严格支配子版本,子版本不进入候选池;若子版本支配父版本,或二者互不支配,则子版本进入候选池。父子逐 Case 分数完全相同时,视为无有效提升,子版本不入池。无论是否入池,都记录本轮变异、父子关系、评测结果和判定原因,保证过程可追溯。
- 更新并继续迭代:子版本通过父子入池判定后,加入全局候选池。若预算尚未耗尽,则在下一轮开始时基于全局候选池重新计算逐 Case 领先候选的活动前沿,并从活跃前沿中选择新的父版本;否则结束搜索。候选即使已经入池,后续被其他候选严格支配时,也不会进入活跃前沿和父版本采样范围,但其版本及评测记录仍保留在候选池中。
- 最终版本确认与发布:搜索结束后,从全部已保留版本中选出黄金评测集平均得分最高的版本,完成规范检查并输出版本差异和进化报告。搜索结束先恢复评测空间种子版本,报告进入最终评审。经人工确认与规范检查后写回目标 SKILL.md,发布、提交和代码评审按独立流程执行。
2.2 候选池设计
候选池采用“全局保存、动态选优”的设计:
| 数据集合 | 含义 | 是否参与父代采样 |
| 全局候选池 | 种子版本及所有通过入池判定的子版本 | 只有进入活动前沿后才参与 |
| 活动前沿 | 当前在不同 case 上具有领先能力的候选 | 参与 |
| 失败尝试集 | 校验失败、评测失败或未通过入池判定的子版本 | 不参与 |
| 当前冠军 | 全局候选池中全量平均分最高的候选 | 仅用于最终选优 |
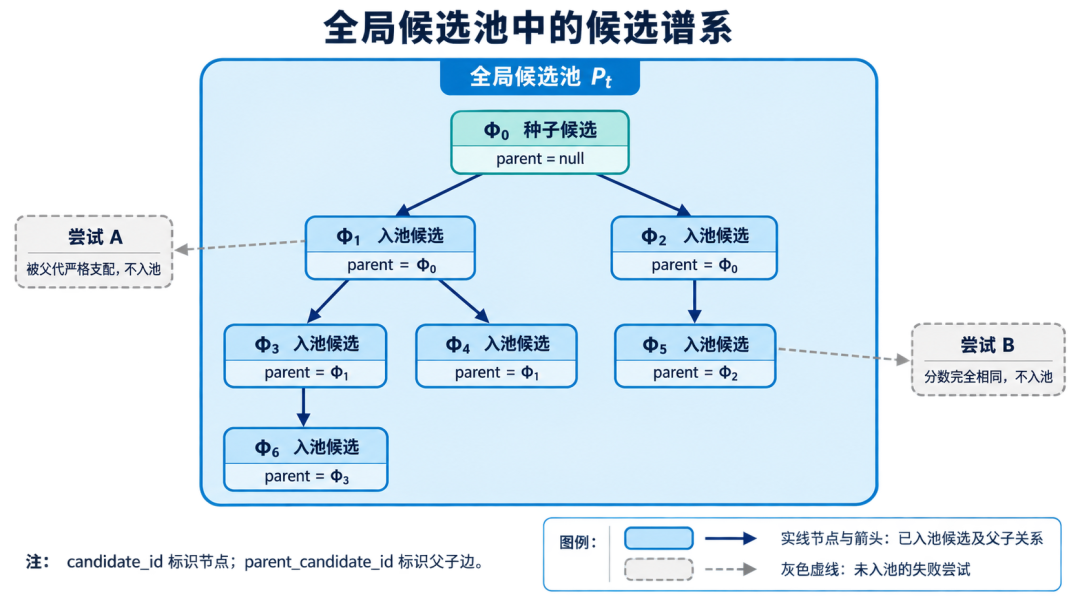
其中,t 表示当前迭代轮次。活动前沿是从全局候选池计算得到的临时结果,用于探索而不直接代表上线资格。候选即使没有进入本轮活动前沿,也不会从全局候选池中删除。
- 候选数据结构
每个入池候选至少记录以下信息:
| 字段 | 含义 |
candidate_id |
候选唯一标识 |
parent_candidate_id |
直接父版本标识 |
artifact_ref |
候选 SKILL.md 的位置;与冻结的完整 Skill 目录组合还原制品 |
content_hash |
候选内容摘要,用于身份校验和去重 |
case_scores |
全部黄金 case 的逐 case 分数 |
mean_score |
全部黄金 case 的平均分 |
evaluation_manifest_ref |
对应评测 manifest,由它定位 Trace、结构化判分和报告 |
feedback_ref |
生成该子版本所使用的反思反馈 |
diff_ref |
子版本相对父版本的修改内容 |
admission |
入池结果、比较对象和判定原因 |
deploy_receipt_ref |
部署回执,记录空间、Skill 版本及制品 hash |
target_module |
本轮修改的唯一目标 Module |
一次进化任务需要冻结黄金 Case、rubric、执行模型与执行配置,并记录 Judge 和服务端运行身份。候选身份要贯穿部署与真实执行证据。当前实现固定了 rubricId 与 contentMd5,但不能把它等同于所有在线依赖都已被冻结。
- 入池规则
子版本完成全量评测后,只与它的直接父版本比较,不与全局候选池中的其他版本做入池判定。这样既能解释一次变异的效果,也能保留互补能力;后续父代采样再由全局候选池的活动前沿决定。
设:
:黄金 case 总数;
:黄金 case 的序号;
:父版本;
:子版本;
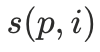 :父版本在第 个 case 上的分数;
:子版本在第 个 case 上的分数。
父版本严格支配子版本的条件为:
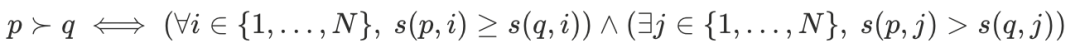
字符含义:
| 字符 | 含义 |
| ≻ | 左侧候选严格支配右侧候选 |
| ∀ | 对所有 case 都成立 |
| ∃ | 至少存在一个 case |
| ∈ | 属于某个集合 |
| ≥ | 大于或等于,即不差于 |
| > | 严格大于 |
| ∧ | 左右两个条件同时成立 |
| {1,…,N} | 全部黄金 case 的序号集合 |
实际连续分数比较使用 epsilon=1e-6:不差于允许 epsilon 容差,严格更优需超过 epsilon;全部差异在容差内视为同分。下表给出入池结果:
父子关系 |
处理结果 |
| 父版本严格支配子版本 | 子版本不入池 |
| 子版本严格支配父版本 | 子版本入池 |
| 父子互不支配,各自有更优 case | 子版本入池 |
| 父子所有 case 分数完全相同 | 视为无有效提升,子版本不入池 |
| 子版本内容与已有候选完全相同 | 根据 content_hash 去重,不重复评测和入池 |
因此,入池规则保留两类版本:整体优于父代的版本,以及虽然没有整体提升、但在部分 Case 上产生新优势的版本。后者可能包含局部回退,最终交付必须披露这些回退,不能把入池当成无回归保证。
- 活动前沿计算
每轮开始时,基于全局候选池 重新计算活动前沿。
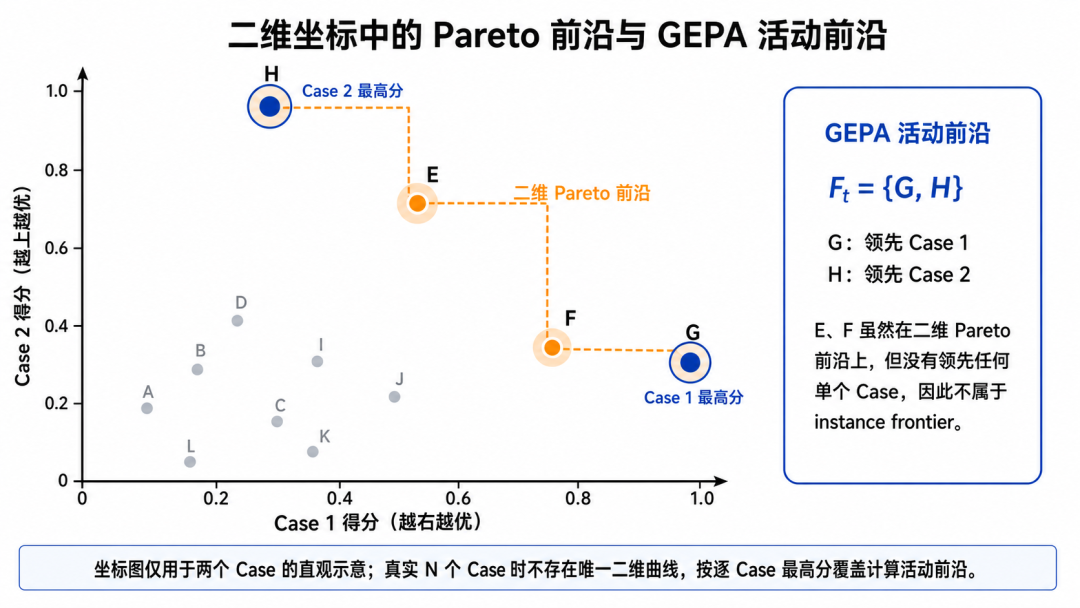
符号说明
| 字符 | 含义 |
| 第 轮开始时的全局候选池 | |
| c | 全局候选池中的任意候选 |
| i | 某一个黄金 case |
|
|
候选 c 在 case i 上的分数 |
| case i 在全局候选池中的最高分 | |
| case i 的领先候选集合 | |
| 候选 c 所领先的 case 集合 | |
| 第 轮的活动前沿
Pt |
|
| 候选 c 的采样权重 | |
| 候选 c 被选为父代的概率 |

第一步:找出每个 case 的最高分
对于每个 case ,在全局候选池中找到最高分:
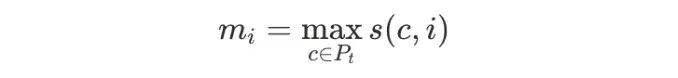
第二步:找出每个 case 的领先候选
所有在 case 上达到最高分的候选组成集合 :
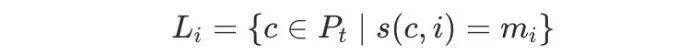
允许多个候选并列第一。
第三步:用确定性贪心覆盖收敛候选集合
定义候选 c 所领先的 case 集合:
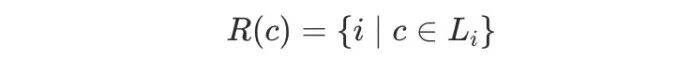
候选没有领先任何 Case 时,不进入活动前沿。对于存在重叠覆盖的候选,需要定义确定性处理顺序,避免同样的分数矩阵产生不同结果:
- 初始化未覆盖集合为全部 Case。
- 选择覆盖最多未覆盖 Case 的候选。
- 覆盖数并列时,依次优先均分更高、最差 Case 分更高、创建更早和 ID 字典序更小的候选。
- 从未覆盖集合中移除已覆盖 Case,重复直到全部 Case 都被覆盖。
这个过程保留了逐 Case 领先能力,避免冗余候选都参与采样。它是贪心覆盖,不保证候选数最少,也不等于完整 Pareto 非支配集。
第四步:加权采样父代
完成覆盖选择后,入选候选构成活动前沿 。候选的采样权重等于其领先的 case 数量:
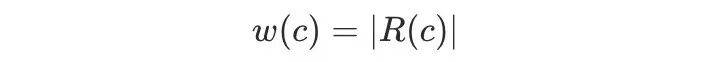
父代采样概率为:
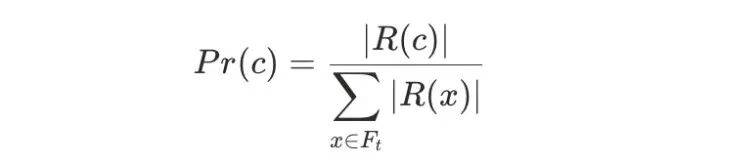
采样权重使用候选在全局池中的全部领先 Case 数,不只统计贪心选择时新覆盖的 Case。随机种子与随机步数保存到任务 manifest,便于恢复时复现选择。
其中, 表示活动前沿中的任意候选。一个候选领先的 case 越多,被选为下一轮父代的概率越高。
- 计算示例
假设全局候选池包含 A、B、C、D 四个候选,黄金评测集包含三个 case:
| 候选 | Case 1 | Case 2 | Case 3 | 平均分 |
| A | 1.0 | 0.6 | 0.3 | 0.63 |
| B | 0.7 | 1.0 | 0.4 | 0.70 |
| C | 1.0 | 1.0 | 0.5 | 0.83 |
| D | 0.8 | 0.7 | 0.9 | 0.80 |
对于 Case 1:
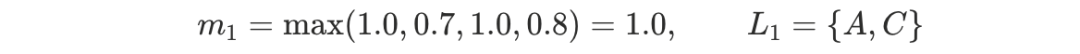
对于 Case 2:

对于 Case 3:
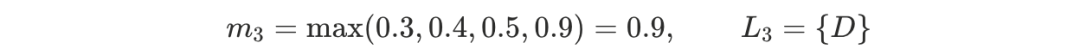
因此,每个候选领先的 case 为:
| 候选 | 领先的 case |
| A | Case 1 |
| B | Case 2 |
| C | Case 1、Case 2 |
| D | Case 3 |
A 领先的 Case 1 已经可以由 C 覆盖,B 领先的 Case 2 也可以由 C 覆盖,因此 A、B 本轮不进入活动前沿。最终活动前沿为:
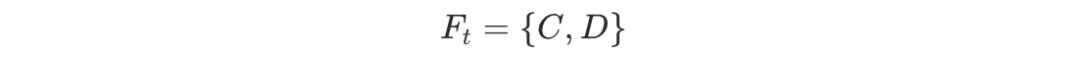
候选 C 领先两个 case,候选 D 领先一个 case:
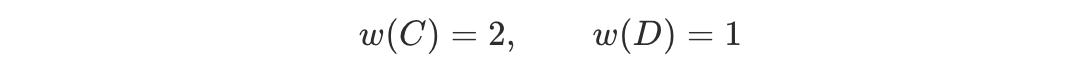
因此:
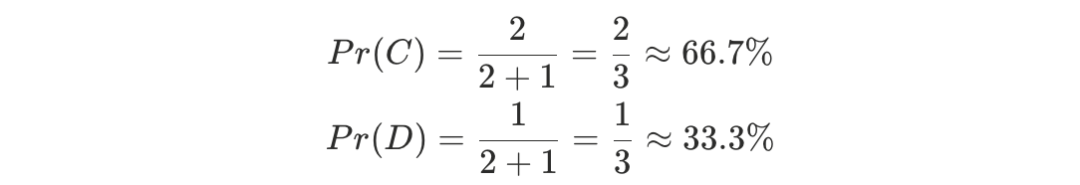
D 的平均分虽然低于 C,但它在 Case 3 上具有独立优势,因此仍然保留继续进化的机会。
- 数据维护
- 全局候选池只追加,不修改或删除已入池候选;
- 新候选入池后,更新逐 case 分数矩阵;
- 每轮开始时,根据最新分数矩阵重新计算活动前沿;
- 当前冠军从全局候选池重新计算,不限定在活动前沿中;
- 执行轨迹、结构化判分结果和 Skill 快照只保存引用,避免重复存储。
被父代占优的子版本不进入全局候选池,但保留一条失败尝试记录,包括父版本、内容摘要、修改差异、逐 case 分数、淘汰原因和评测产物引用。这些记录用于避免重复修改、分析退化原因和排查评测异常,但不会参与后续父代采样。运行状态还需保存预算计数、随机步数和待完成轮次;只保存候选列表不足以支持可靠恢复。
- 最终版本选择
活动前沿只用于选择下一轮父代。搜索结束后,最终版本仍从全局候选池中按照全量平均分选择。
候选 c 的全量平均分为:
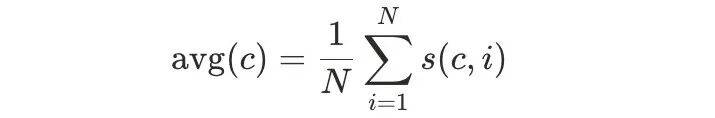
最终版本为:
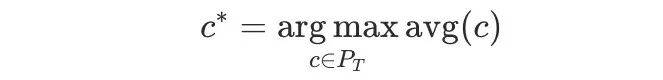
其中,表示搜索结束时的全局候选池,arg max 表示使平均分取得最大值的候选。父代选择强调不同 Case 上的能力多样性,最终选优则选择整体平均表现最好的版本。
实现对均分使用 epsilon 量化排序,再按最差 Case、通过 Case 数、修改行数和创建顺序等规则确定唯一结果。最终报告应统一修改量口径:当前代码统计相对直接父代的行数,而相对种子的累计差异更适合评估最终交付影响,这一口径尚需对齐。
同一黄金集用于反思和选冠军时,均分提高首先说明搜索集上的改进。独立保留集应不进入反思与变异输入,用于最终验证泛化能力。
2.3 Skill Module的设计
借鉴 GEPA 的模块化优化思想,我们将候选 SKILL.md 拆分为多个可独立优化的业务 Module,每轮只选择其中一个 Module 进行反思和变异,其余内容保持不变。
- Module 划分方法对比
整体作为单一 Module |
按文档固定章节划分 |
按 Skill 内部业务能力划分✅ | |
划分方式 |
整份 SKILL.md 作为一个 Module | 按输入、流程、约束、输出等章节划分 | 每个可由一类用户意图独立触发、具有独立执行流程和输出规则的业务能力作为 Module,公共规则单独划分 |
优点 |
实现简单,不需要额外配置 | 边界清晰,适合结构统一的 Skill | 与评测 case 和失败归因更容易对应,变异范围较完整 |
缺点 |
每次改动范围过大,容易修复一个场景却破坏其他场景 | 依赖统一的章节结构;Skill 的章节组织并不完全一致,而且同一业务能力可能分散在多个章节中,通常仍需逐个 Skill 配置。 | 需要为每个 Skill 建立一次 Module 配置 |
- Module 结构
一份 SKILL.md 按实际内容划分成下列 Module,不要求包含全部类型:
Module 类型 |
默认是否允许自动进化 |
使用说明 |
| routing | 是 | 路由遗漏或错误分流时修改 |
capability.<name> |
是 | 主要进化对象;评测 case 应尽量映射到一个具体 capability(具体业务能力) |
| shared.response | 是 | 输出时共用的规则/模板 |
| shared.boundaries | 是 | 失败归因指向边界判断时修改 |
| shared.guardrails | 否 | 权限、安全、合规和不可逆操作确认等硬性保护规则 |
以 query-object-ranking 为例,它包含 TOP 排名和指定对象查询两个可以独立归因、独立修改的业务能力:
routing
capability.object_ranking
capability.object_detail
shared.response
shared.boundaries
Module |
对应 SKILL.md 内容 |
职责 |
典型失败 |
| routing | frontmatter 的 description、触发条件和 Step 0 | 识别排名查询或指定对象查询,并选择对应模式 | 排名请求未触发,或对象查询被分到排名模式 |
capability.object_ranking |
Step 1.2,以及 Step 2~Step 4 中 TOP 排名模式的规则和输出 | 选择分析任务,查询并输出对象 TOP 排名 | 多任务时未让用户选择,或排名结果输出错误 |
capability.object_detail |
Step 1.1,以及 Step 2~Step 4 中单对象模式的规则和输出 | 按名称或编号查询指定对象,并合并多个数据分组的数据 | 单对象查询被输出成 TOP 榜单,或多个数据分组未合并 |
| shared.response | 两种模式共同遵守的 Markdown、表格和数值展示规则 | 保证公共输出格式一致 | 表格格式错误或公共字段遗漏 |
| shared.boundaries | 不适用场景、对象名称与类别混淆处理及共用异常规则 | 区分对象查询与类别、分组、目标、归因等其他维度 | 类别或分组查询错误进入本 Skill |
从能力划分看,“哪些对象的待处理记录最多”对应 capability.object_ranking;“查一下示例对象 A 的示例指标”对应 capability.object_detail。该 Skill 不包含权限、安全或不可逆操作,因此不需要强行增加 shared.guardrails。该示例用于说明业务边界;是否能启动自动进化,还需单独检查 Case 真值和评测就绪条件。
- 不同类型 Skill 的划分建议
| Skill 类型 | 建议划分方式 |
| 单一处理路径 | 一个 capability.runtime,必要时增加 shared.boundaries 和 shared.guardrails |
| 多处理路径 | 每个可独立归因和修改的处理路径建立一个 capability.<name> |
| 包含公共输出规范 | 能力 Module 之外增加 shared.response |
| 包含公共业务边界 | 将适用条件、业务阈值、异常输入和降级规则划入可进化的 shared.boundaries |
| 包含权限或高风险操作 | 将权限、安全、合规和不可逆操作确认划入只读的 shared.guardrails |
| 以能力识别和分流为主 | 单独建立可进化的 routing;修改 Skill 触发范围时须有路由评测 case 覆盖 |
Module 数量不宜过多。只有当两部分内容对应不同能力或处理路径、能够独立归因,并且可以独立修改时,才应拆分为不同 Module。
- Module 边界定义方式对比
在 SKILL.md 中加分隔符 |
外部 module_spec ✅ |
每轮由模型动态识别 | |
| 实现⽅式 | 直接在正⽂中标记Module起⽌位置 | 在独⽴配置中记录 Module与 SKILL.md 内容范围的映射 |
反思时由模型临时判断Module边界 |
| 优点 | 定位准确 | 不修改现有 Skill,可进⾏⼈⼯审核和版本管理 | ⽆须预先配置 |
| 缺点 | 需要修改全部现有 Skill,并在业务⽂档中引⼊进化标记 | Skill 结构变化后需要同步更新配置 | 边界不稳定,不同轮次可能识别出不同结果 |
- Module 配置与使⽤约束
module_spec 在 Skill ⾸次进⼊进化流程时⽣成,配置⽣成和使⽤规则如下:
| 阶段 | 处理规则 |
| ⾸次配置 | 当前⼯具按标题和关键词⽣成草稿;⼈⼯按业务能⼒合并或拆分 span,并确认只读规则 |
| 进化启动 | 重新计算 SKILL.md 的内容摘要;若与 source_hash 不⼀致,则暂停进化并重新确认 Module 边界 |
| Module选择 | 根据失败 case 的归因结果,选择最相关的可修改 Module,不按固定顺序轮询 |
| 单轮变异 | 反思模型读取完整⽗版本作为上下⽂,但默认每轮只修改⼀个⽬标 Module,其他内容保持不变 |
| 变异校验 | 检查实际差异是否全部位于⽬标 Module,并确认只读 Module 未发⽣变化 |
| 复杂归因 | 单 Case涉及多个 Module、指向只读规则或⽆法可靠定位时,交由⼈⼯确认,不⾃动执⾏跨 Module 修改 |
Module变异完成后的⼦版本全量评测、⽗⼦⼊池判定及候选池更新,统⼀按照 2.1全局流程执⾏,本节不再重复说明。
2.4 归因变异提示词设计
归因与变异使用两个独立提示词:归因提示词按 Case 执行,变异提示词在选定目标 Module 后执行。
-
归因提示词输入
| 输入项 | 内容 |
| 当前 Skill | 父候选对应的完整 SKILL.md 内容 |
| 用户问题与 Ground Truth | 当前 Case 输入和按维度组织的可信标准答案,用于判断期望行为 |
| Module 配置 | module_spec,包括 Module ID、对应内容范围及是否允许修改 |
| 执行轨迹 | Zelda 执行轨迹接口 返回的结构化 messages,包括用户输入、助手回复、工具调用和工具结果 |
| 评测结果 | Zelda 统一评测链路产出的最终结构化结果,语义上对应 评分接口 的判分数据:总分、各维度分数、原子问题判定、评分依据和原因;不传无关 ID 与 debugInfo 等调试字段 |
全部黄金 Case 都执行归因。失败 Case 用于定位问题,成功 Case 用于识别变异时需要保留的正确行为。统一评测系统负责产生 Trace 和评分,自进化流程负责把这些产物编译成反思反馈。
归因输出需要表达分类、责任 Module、证据引用、失败原子问题、期望行为、需要保持的行为和置信度。只有可信 SKILL_ISSUE 驱动变异;RUBRIC_ISSUE、CASE_ISSUE、ENVIRONMENT_ISSUE 和 UNCERTAIN 分别进入指标、Case、环境处理或人工澄清。证据非空不等于证据真实,引用应能在对应执行记录中校验。
选择目标 Module 时,当前实现聚合 (1 - case_score) × confidence。最高信号并列或责任范围无法收敛时暂停;零信号和低置信度的确定性门禁仍需补齐。
- 变异提示词输入
| 输入项 | 内容 |
| 当前 Skill | 父候选对应的完整 SKILL.md 内容 |
| 用户问题与 Ground Truth | 当前 Case 输入和按维度组织的可信标准答案,用于判断期望行为 |
| Module 配置 | module_spec,用于确定各 Module 的内容范围和修改权限 |
| 目标 Module | 根据归因结果选出的本轮唯一可修改 Module,以及该 Module 的当前内容 |
| 执行轨迹 | 全部黄金 Case 的 执行轨迹接口 结果,供模型核对实际执行行为 |
| 评测结果 | 全部黄金 Case 的 评分接口 最终结果,供模型同时识别失败问题和需要保留的成功行为 |
| 归因反馈 | 归因提示词生成的 Case 级问题原因、责任 Module、证据和期望行为 |
| 历史变异 | 目标 Module 最近被淘汰的修改内容及淘汰原因;没有历史记录时不传 |
| 修改约束 | 仅允许修改目标 Module,不得修改只读 Module、硬编码评测 Case 或虚构不存在的工具能力 |
变异提示词只生成目标 Module 的替换内容,再由系统与父候选中的其他内容合并,形成完整子候选。模型不能修改只读 Module、写死评测答案或虚构工具能力;Trace、用户文本和工具输出作为不可信证据输入,不能变成新的执行指令。
上表描述完整设计输入。当前实现传入父 Skill、Module、分数、归因摘要和简略失败记录,尚未完整传入全部原始 Trace、判分及历史 diff。已有评测引用、diff.patch 和 mutation.json 可以复用,后续主要补齐证据消费链路,避免新增第二套存储或评分流程。
实践中的关键取舍
这套设计保留了三组取舍:通过全量评测换取候选可比性,通过单 Module 修改换取边界可解释性,通过全局候选池保留局部优势而不立即只追逐均分。
更完整的搜索系统也意味着额外成本:需要可信真值、首次 Module 审核、候选评测预算,以及对版本、异常和人工决策的状态管理。它适合业务边界较清楚、评测资产较完整、需要持续优化的 Skill;缺少可信真值或环境不稳定时,应先建设这些基础条件。
Skill 自进化最终要让每次修改都能回答三个问题:依据是什么,范围在哪里,收益如何验证。黄金集与 Trace 提供依据,Module 收住范围,全量评测和独立保留集检验效果,状态与报告保留可追溯过程。人工在首次边界和最终交付中作出业务判断,模型在这个范围内探索更好的版本。
本文作者@大淘宝技术。原文链接:https://mp.weixin.qq.com/s/_QaPvXBKy56EScrY9j_50A?nwr_flag=1