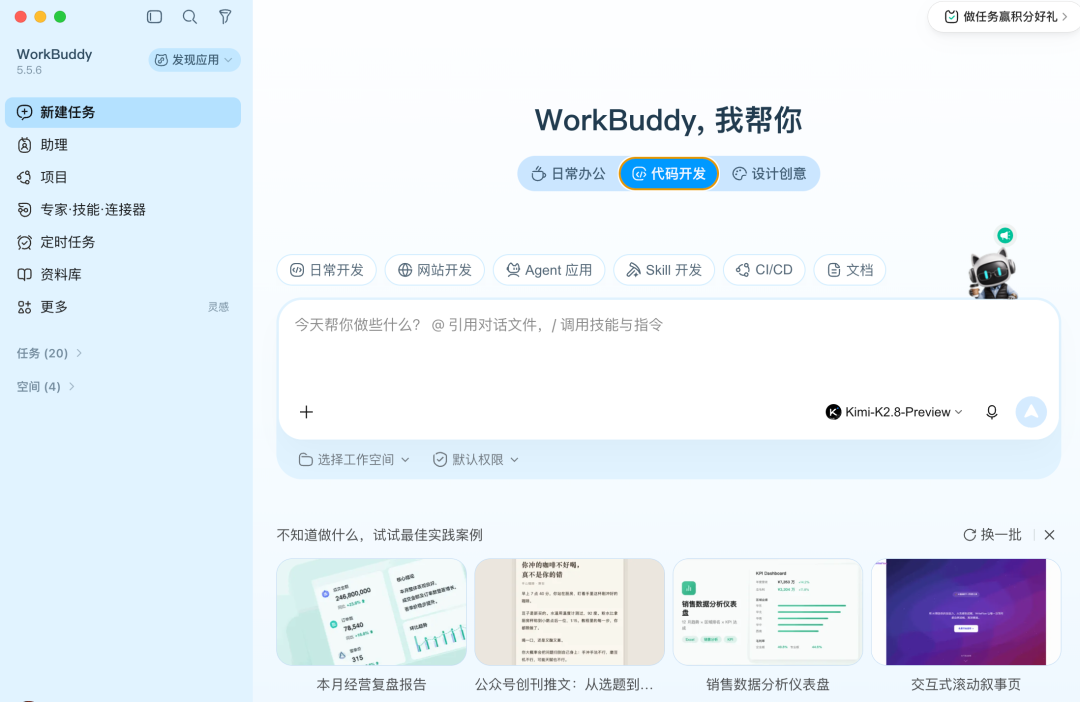
最近我一直在用WorkBuddy和豆包工作,已经是铁粉级别了。
但如果现在让我判断国内AI办公这条赛道谁跑得更快,我大概率还是会投 WorkBuddy 一票。
而且按照现在这个趋势继续下去,我甚至觉得 WorkBuddy 和其他产品之间的差距还有可能继续扩大。
原因其实一点都不复杂。
不是因为它多了某个特别惊艳的功能,也不是因为腾讯突然做出了一个遥遥领先的大模型。
真正拉开差距的,就两件事:
模型够多,额度够大。
这两件事看起来很普通,但放到今天的中国 AI 市场里,杀伤力可能比多做十个功能还大。
今天,我就以产品人的视角来yy一下,做个分析,有不对的地方,大家轻点喷。
WorkBuddy 最厉害的,其实是把自己做成了“模型超市”
现在打开 WorkBuddy 的模型列表,会发现它已经越来越不像一个只服务腾讯自家模型的产品。
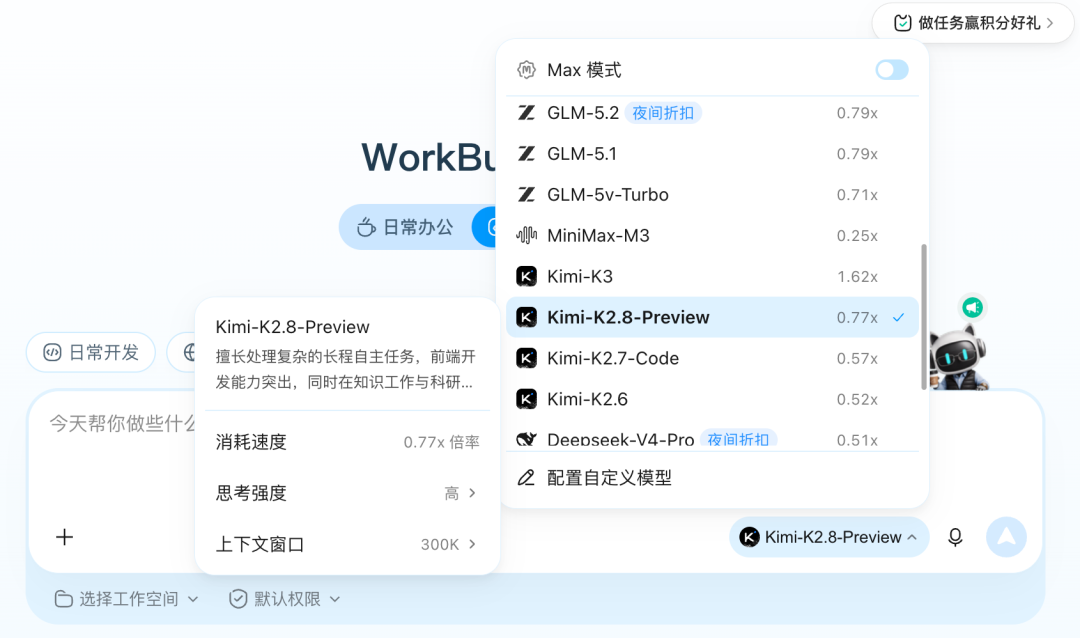
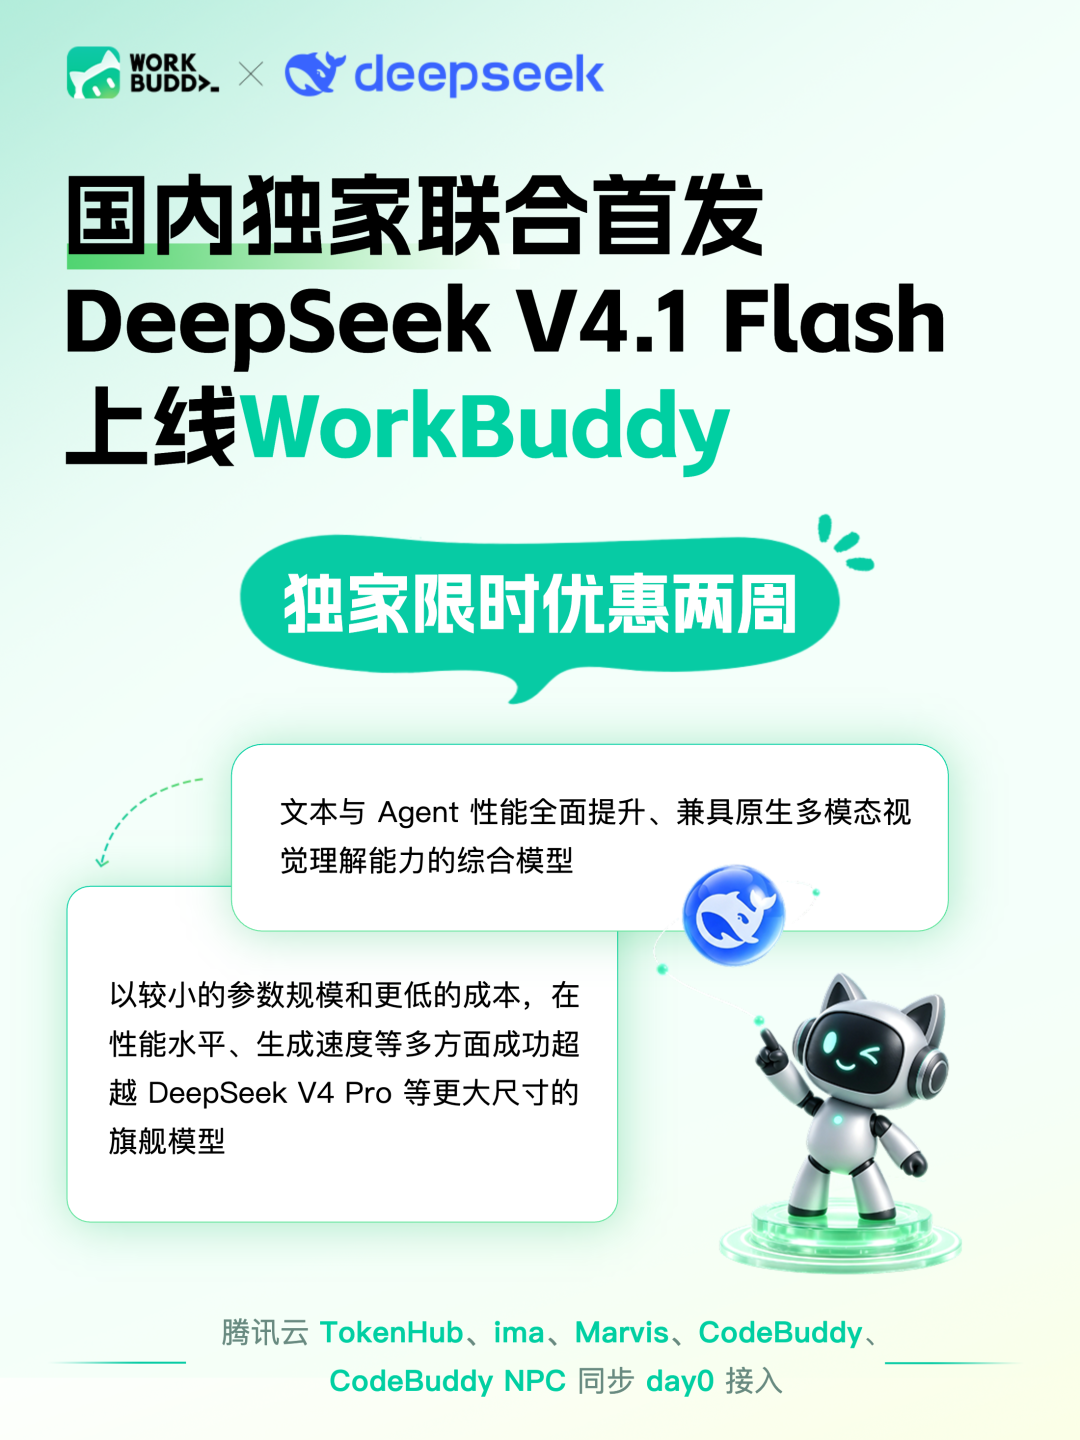
除了自己的 Hy 系列,DeepSeek、Kimi、GLM、MiniMax 等国内主流模型基本都在往里面塞。
这件事情的价值,可能比表面上看到的更大。
以前 DeepSeek 更新了,你去 DeepSeek。
Kimi 发新模型了,你打开 Kimi。
智谱又出了新版本,你再去找 GLM。
每家厂商都有自己的产品、账号体系和使用入口。
但 WorkBuddy 做的事情,相当于把这些入口慢慢收到了一个地方。
今天 DeepSeek 更新,我在 WorkBuddy 试。
明天 Kimi 更新,我还是在 WorkBuddy 试。
后天 GLM 又出了新版本,我继续切一下就行。
对于重度 AI 用户来说,这个体验非常有诱惑力。
因为用户真正想要的,从来不是忠诚于某一家模型。
而是:
谁现在最好用,我就想用谁。
所以 WorkBuddy 一个很聪明的地方就在这里:
它根本不需要证明 Hy 永远是中国最强模型。
只需要保证——
中国热门的模型,我这里尽量都有。
谁赢,它都不输。
更关键的是,别人的模型还在源源不断给 WorkBuddy 带流量
我觉得这一点反而很容易被忽略。
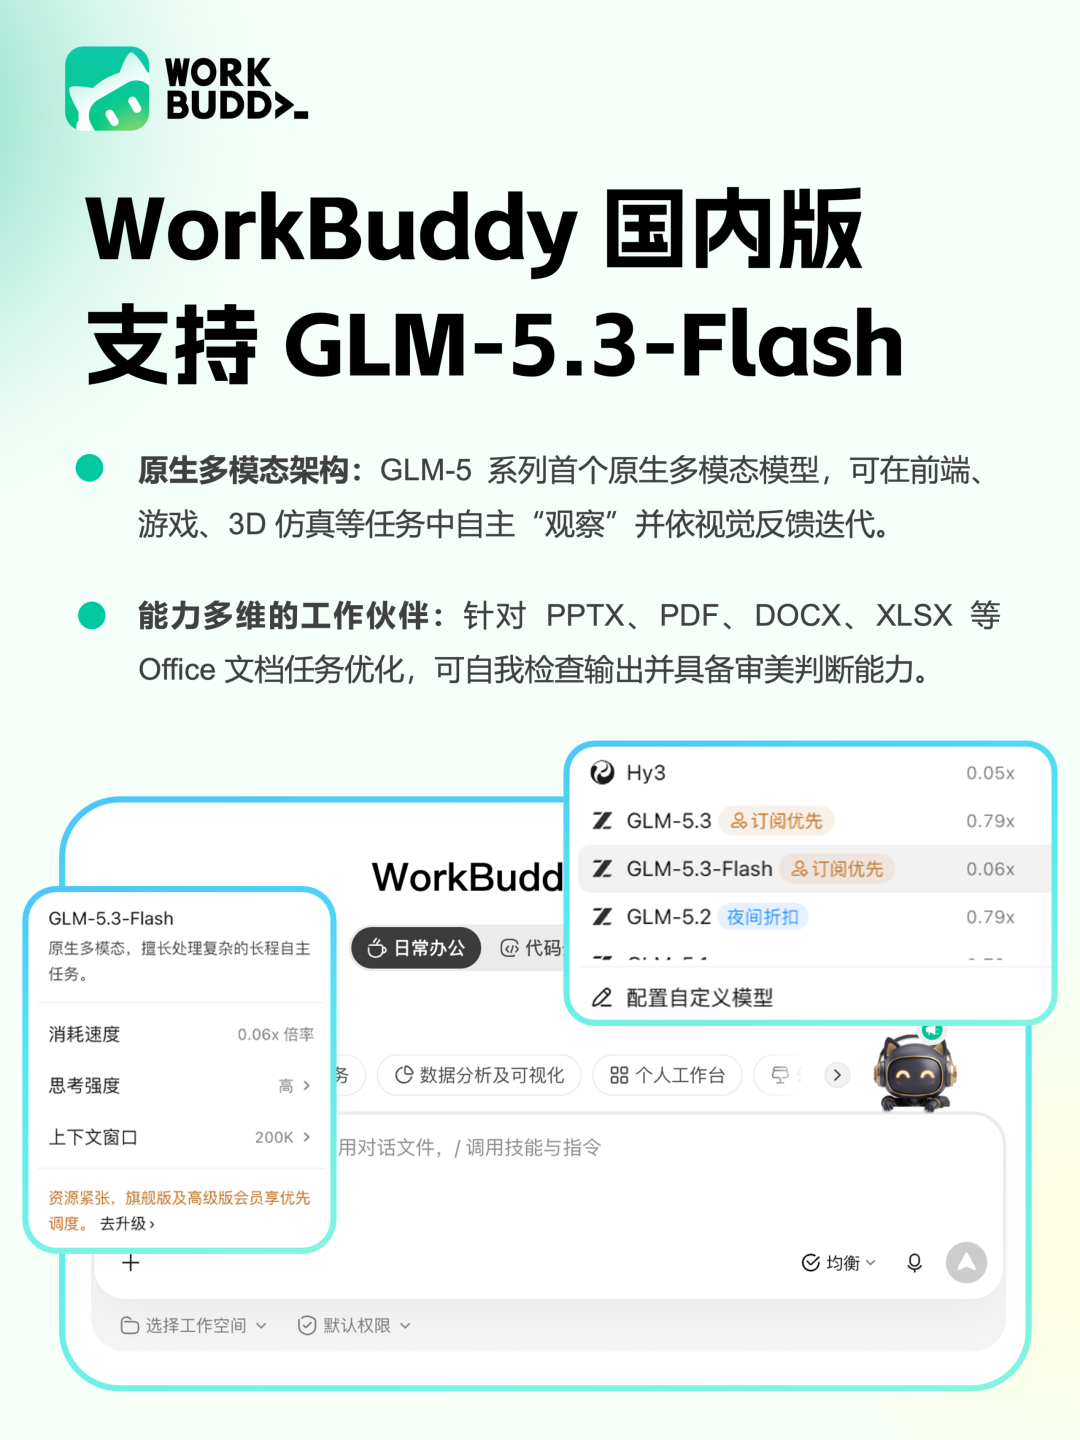
WorkBuddy 接第三方模型,得到的不只是“模型数量变多”。
它其实还顺便拿走了各家模型厂商自己制造出来的热度。
DeepSeek 每次发布新模型,都会有媒体报道、博主测评、社交平台讨论。
Kimi 更新,也会产生一波关注。
GLM、MiniMax 同样如此。
这些模型厂商花大量资源研发新品、做市场传播,最后都会制造一个非常明确的需求:
“这个新模型到底怎么样?我想试试。”
如果 WorkBuddy 能快速接入,那么这部分需求自然会有一部分流向 WorkBuddy。
也就是说:
DeepSeek 在帮 WorkBuddy 拉新。
Kimi 在帮 WorkBuddy 拉新。
GLM、MiniMax 每次更新,也可能顺便帮 WorkBuddy 激活一批老用户。
这其实已经不只是产品策略了。
而是一个非常漂亮的增长策略。
模型越多,能承接的行业热点越多;热点越多,用户回来的次数越多。
久而久之,用户甚至可能形成一种新的习惯:
不是“DeepSeek 更新了,我去哪里用?”
而是:
“最近哪个模型更新了?去 WorkBuddy 看看。”
一旦这个心智形成,WorkBuddy 就不只是一个 AI 办公软件了。
它还有机会变成一个国产大模型的分发入口。
甚至连“免费”,可能都是一笔划算的生意
很多人看到 WorkBuddy 给这么多积分、一些模型免费或者低倍率使用,第一个反应可能是:
这么搞不亏吗?
但换一个互联网产品经理的视角看,这笔账可能不是这么算的。
任何互联网产品都要付获客成本。
投广告要钱。
做信息流要钱。
买关键词要钱。
找达人推广同样要钱。
而且你花几十块甚至几百块拉来的一个用户,不一定真的有 AI 办公需求。
但 WorkBuddy 如果花一些模型调用成本,让用户可以低成本体验一个刚刚爆火的新模型呢?
这笔钱其实也可以理解成市场费用。
比如一个用户就是因为 DeepSeek 新模型来到 WorkBuddy。
结果进来以后发现:
原来这里不只有 DeepSeek。
Kimi 也有。
GLM 也有。
MiniMax 也有。
Hy 还能免费用。
于是本来只是来尝鲜一次的人,最后把 WorkBuddy 留在了电脑里。
从这个角度看,WorkBuddy 补贴出去的一部分模型成本,实际上有可能抵消它原本需要支付的广告获客成本。
甚至可能更划算。
因为这些因为新模型而来的用户,本身就是最精准的 AI 用户。
于是整个逻辑就闭环了:
接更多模型 → 承接更多模型热点 → 获得更多新用户 → 提高留存 → 更有能力补贴模型 → 使用成本更低 → 吸引更多用户。
这可能才是 WorkBuddy 现在真正难追的地方。
不是哪一个功能。
而是这个飞轮已经开始转起来了。
WorkBuddy 的第二个杀手锏:中国用户真的太吃“免费”这一套了
中国 AI 市场还有一个非常特殊的地方。
用户已经被免费产品教育得太久了。
很多人每天可以用几十次 AI,但真让他一个月付一两百块钱,立刻就会开始算账。
尤其 AI 办公 Agent 和普通聊天还不一样。
你问 AI 一个问题,消耗可能还不算大。
但你让 Agent 帮你做一份 PPT、分析几十份文件、搜索资料、做 Excel,再来回修改几轮,背后消耗的模型调用量完全不是一个级别。
所以用户最担心的不是:
“这个会员一个月多少钱?”
而是:
“我这么用,会不会没几天额度就烧完了?”
WorkBuddy 现在给我的一个明显感受就是,它很努力地降低这种心理负担。
积分给得相对多,一些模型消耗又非常低,自家的部分模型甚至可以阶段性免费。
最后用户形成的感觉就是两个字:
敢用。
而我一直觉得,“敢用”才是 AI Agent 真正普及最重要的一步。
因为只有当用户不再心疼每一次点击,他才可能慢慢养成:
有活先扔给 AI。
这个习惯一旦形成,产品才真正进入工作流。
反过来看,豆包工作的问题也非常清楚
所以豆包工作现在最大的短板,其实也不用想得太复杂。
一个是模型。
一个是额度。
目前豆包工作还是以自家模型为主。
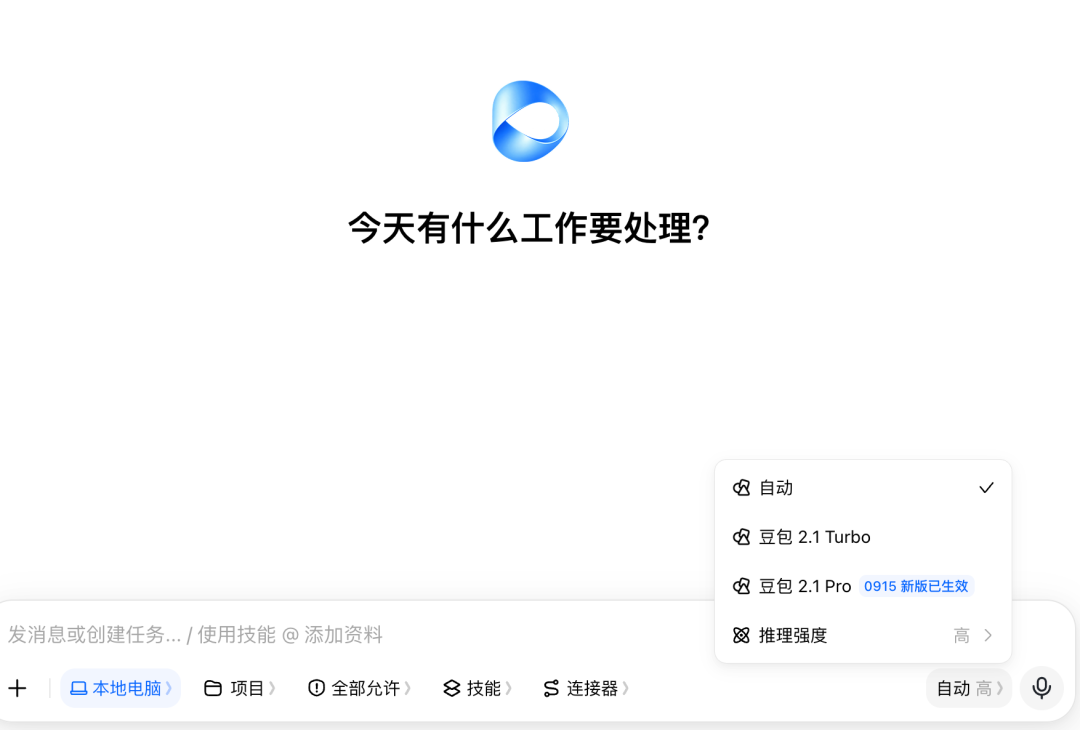
这当然可以理解。
字节自己花那么多钱训练模型,肯定希望优先使用自己的能力。
但从用户角度看,就会出现一个非常现实的问题:
为什么隔壁可以让我用 DeepSeek、Kimi、GLM、MiniMax,你这里只有豆包?
这里讨论的甚至不是谁的模型能力更强。
而是选择权。
尤其对于 AI 重度用户来说,新模型本身就是一个需求。
DeepSeek 发布新品的时候,他就是想试 DeepSeek。
你告诉他豆包模型也很好,并不能完全替代这种需求。
更麻烦的是,豆包工作如果不接这些模型,也意味着它很难承接这些模型带来的市场热度。
DeepSeek 爆一次,WorkBuddy 可以吃一次流量。
Kimi 爆一次,又可以吃一次。
而豆包工作只能等自己的模型更新。
这么长期跑下去,双方获得自然流量的效率都会不一样。
所以豆包工作要追,其实第一招:开放模型
我甚至觉得,豆包完全没有必要像 WorkBuddy 一样一次塞十几个模型。
把几个最重要的先接进来就够了。
DeepSeek。
Kimi。
GLM。
再加上自己的豆包系列。
产品体验立刻就会发生变化。
而且我一直觉得,大厂在这件事情上应该换一个思路。
接入竞争对手的模型,不等于给竞争对手导流。
恰恰相反。
你是在把竞争对手制造出来的模型热度,变成自己的用户流量。
DeepSeek 花钱训练模型,制造热点。
用户因为 DeepSeek 来到豆包工作。
最后却留下来用了豆包工作。
到底是谁在给谁导流?
一旦从这个角度看,逻辑就完全反过来了。
第二招更简单:把免费额度狠狠干上去
这一点我觉得豆包反而比很多产品更有条件做。
因为豆包本身已经有非常强的品牌认知。
这其实是一个被低估的优势。
WorkBuddy 这个名字,目前更多还是 AI 圈、职场科技圈的人比较熟悉。
但“豆包”已经是一个大众品牌了。
名字简单,好记,好传播。
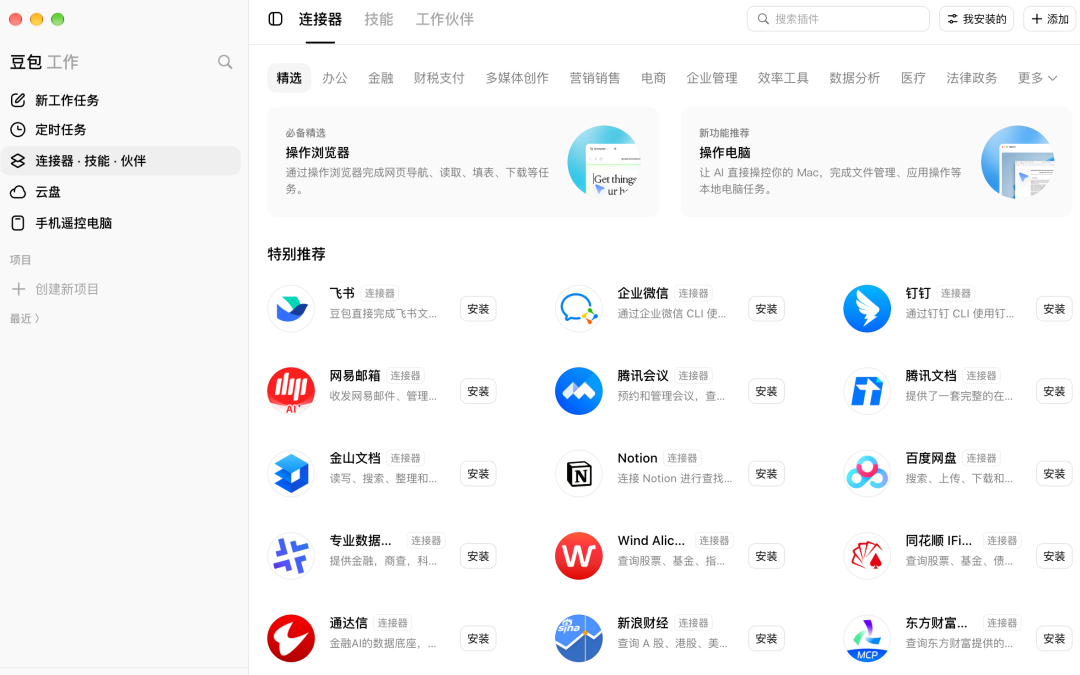
而且字节还有一整套非常成熟的产品增长能力。
所以我一直觉得,豆包工作真正缺的不是品牌。
而是:
怎么把豆包已经拥有的品牌势能,转化成 AI 办公用户。
最简单的办法,就是让大家敢用。
比如把自家成本比较低的模型直接做成高额度甚至阶段性免费。
普通任务不用算额度。
真正昂贵的高阶模型、复杂推理、大型 Agent 任务再收费。
这样用户才可能从:
“听说豆包也能办公了,我试试。”
变成:
“有事情直接扔给豆包吧。”
这两个状态,差别非常大。
前者是尝鲜。
后者才是习惯。
所以我并不觉得 WorkBuddy 会永远领先
如果今天让我二选一,我依然觉得 WorkBuddy 的产品策略更漂亮。
模型多。
额度大。
消耗低。
还能不断吃到整个国产大模型行业的新品红利。
这个飞轮一旦继续转下去,确实会越来越舒服。
但反过来看,它现在的优势也并不是无法复制的技术壁垒。
豆包不能接 DeepSeek 吗?
当然可以。
不能接 Kimi、GLM 吗?
显然也不是技术问题。
豆包不能把自己的低成本模型拿出来免费吗?
一样可以。
所以豆包工作真正要解决的,可能根本不是产品能力问题。
而是一个战略选择:
愿不愿意从“我只推自己的模型”,变成“我先抢AI办公入口”。
如果哪一天豆包工作突然宣布:
DeepSeek、Kimi、GLM 全部接入。
再把自己的部分模型免费额度大幅提高。
那么 WorkBuddy 今天最明显的两个优势,很可能瞬间就会被削掉一大截。
到了那个时候,双方才真正进入第二阶段:
拼产品体验。
拼 Agent 能力。
拼谁更懂普通用户。
拼谁迭代更快。
而这恰恰又是字节过去很多年非常擅长的事情。
所以现阶段我依然看好 WorkBuddy。
但如果让我看一年以后,我还真不敢那么早下结论。
WorkBuddy 现在确实领先。
但豆包工作想追上它,答案其实已经摆在桌面上了:
把模型打开,把免费额度拉上去。
剩下的,就看字节愿不愿意这么干了。
本文由作者@怪哥,授权发布于平台,未经许可禁止转载。