CLAUDE.md 的问题从来不是写不出来,是写出来之后没人管。三个月前记下的构建命令,现在跑不通;目录结构换过两轮,文件里还指着已经拆掉的 src/lib。Claude 每次进这个仓库都把它当真理读,读一次错一次。
这类文件的失效方式特别阴。代码写错会红,测试挂会有栈,CLAUDE.md 写错不会有任何提示。模型照着过期路径去找文件,找不到就自己猜,猜偏了你只觉得它今天有点笨,很少会想到去翻那个几百行的记忆文件。
claude-md-improver 是 Anthropic 官方插件市场里的一个 Skill,挂在 claude-md-management 插件下面,作者是 Isabella He,Apache 2.0。它的职责窄得有点无聊:把仓库里所有 CLAUDE.md 翻出来,按六个维度打分,出一份体检报告,等你点头再动笔改。
真正值得拆的不是它能改文档。是它把两件本来很虚的事做具体了:让“这份文档好不好”变成一张可以逐项打分的表,让“改文档”变成一道必须人类签字的闸门。一句话概括它的设计:审计在前,写入在后,判断权留给你,执行力交给模型。
架构解析
全部家当一个 SKILL.md,5.9 KB,181 行。外加两个 references,一份 quality-criteria.md 装打分细则,一份 templates.md 装按项目类型分的模板库。没有脚本,没有状态机,没有外部服务,装完就是一个纯指令文件。
工具清单短得反常,只有 Read Glob Grep Bash Edit 五个。这里少了一个 Write,而这一条恰恰是整套设计里最硬的约束。有 Write 就等于允许整份重写,模型可以顺手把不懂的部分删掉、把语气统一成自己的、把结构调成它喜欢的样子。只给 Edit,能力层面就把“我给你重构一版”这条路堵死了,只能在原文上做定点替换。
五个阶段串成一条单向链:发现 → 评估 → 出报告 → 提改动 → 落盘。前三段只读不写,第四段产出 diff 供你审,第五段才是真正的 Edit。中间那道审批不是礼貌性的询问,是流程上唯一允许写入的入口。
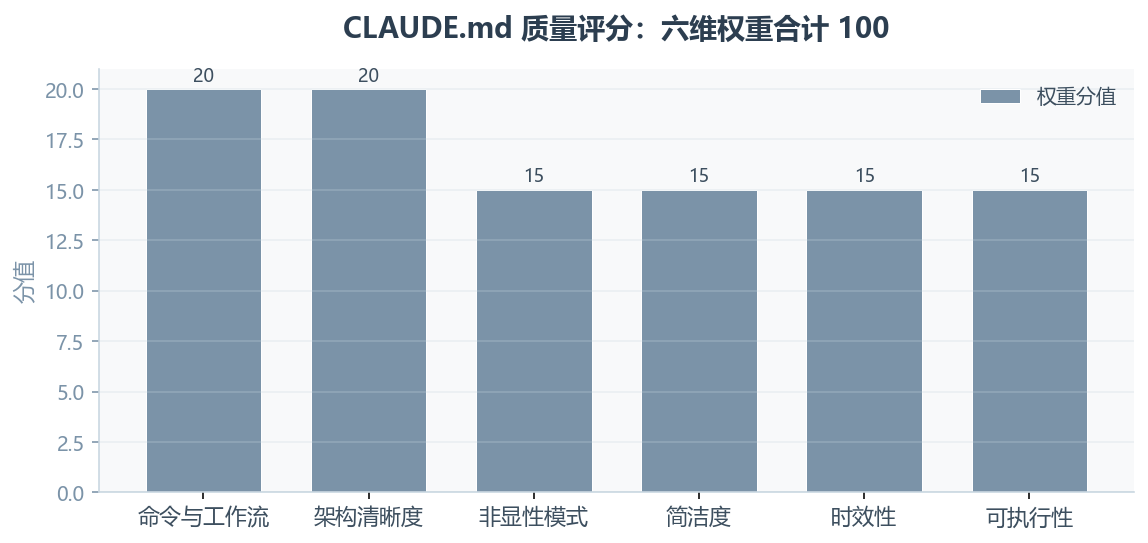
六个维度平分一百,权重的分配比分数本身更有意思:
| 评估维度 | 权重 | 判什么 |
|---|---|---|
| 命令与工作流 | 20 | 构建、测试、部署、lint 是否都在,上下文够不够 |
| 架构清晰度 | 20 | 目录职责、模块关系、入口点、数据流讲没讲清 |
| 非显性模式 | 15 | 坑、绕法、边界情况、为什么这么写的解释 |
| 简洁度 | 15 | 有没有废话、有没有和代码注释重复、有没有正确的废话 |
| 时效性 | 15 | 命令还能不能跑、引用的文件还在不在 |
| 可执行性 | 15 | 命令能不能直接粘、路径是不是真的 |
档位按总分切:A 是 90 到 100,B 到 70,C 到 50,D 到 30,F 是 0 到 29。这套分数不是拿来比美的,是拿来排序的。一个 monorepo 翻出七八份 CLAUDE.md,你不可能全改,分数的作用是告诉你先动哪一份。
工作流分析
第一步是发现,一条 find 命令铺开:
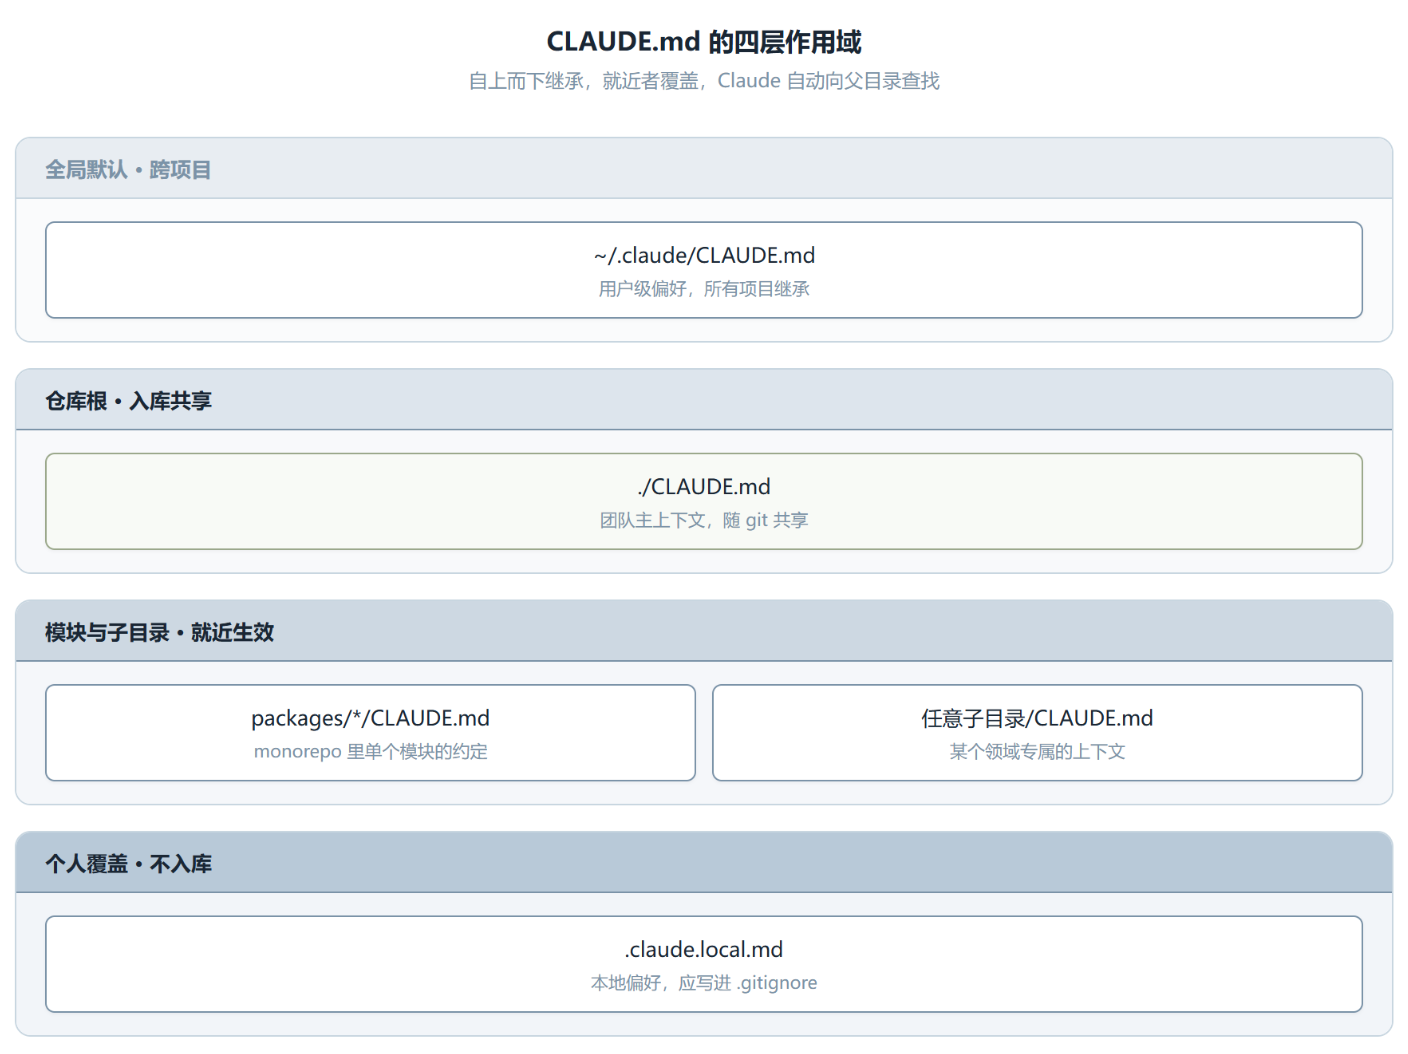
find . -name "CLAUDE.md" -o -name ".claude.md" -o -name ".claude.local.md" 2>/dev/null | head -50扫出来的文件按位置分五种身份,各自职责不同。仓库根的 CLAUDE.md 是主上下文,入库共享;.claude.local.md 是个人覆盖,应该进 .gitignore;~/.claude/CLAUDE.md 是跨项目的全局默认;packages/*/CLAUDE.md 管 monorepo 里的单个模块;更深层的子目录文件管某个具体领域。Claude 会自动往父目录找,所以 monorepo 不用手工串联。
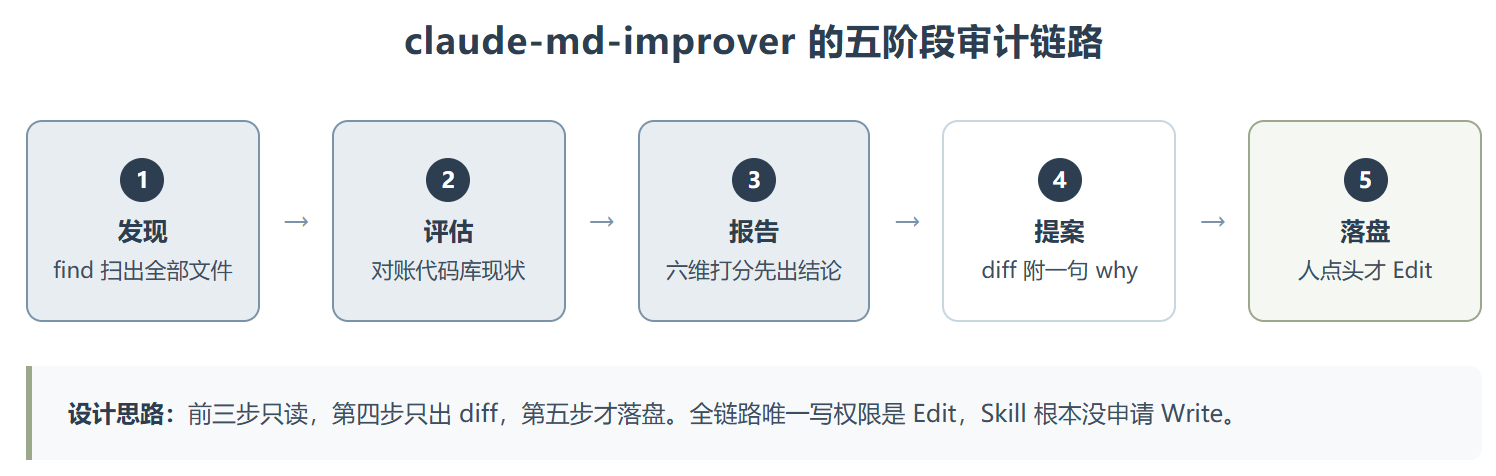
第二阶段的评估是整个 Skill 里唯一需要真干活的地方。打分细则要求它拿文档里的内容去跟实际代码库对账:文档里写的命令,要么在脑子里推一遍依赖是否齐备,要么真跑一次;文档里引用的文件路径,逐个确认还存在;架构描述,对着实际目录核一遍。这一步做完,六维分数才有依据,不然全是照着文风给印象分。
这个对账动作决定了它跟“让 Claude 自己看看这份文档写得怎么样”有本质区别。后者只能读出语气和结构,读不出 npm run build 里那个脚本早被删了。
第三阶段出报告,格式是钉死的:先一段 summary 报三个数(找到几份、平均几分、几份需要改),再逐文件展开打分表,每项写清得分和理由,最后分两栏列 issues 和 recommended additions。报告必须先出,这是硬要求,写的是 ALWAYS output the quality report BEFORE making any updates。
第四阶段提改动,输出格式是 diff 而不是成品。每一条都得带上改哪份文件、加什么内容、为什么这样对后续会话有帮助。示例里给的理由很具体:构建命令缺失,导致每次都不知道怎么跑起来。对比一下常见写法“补充构建说明,提升文档完整性”,差别一眼能看出来。
第五阶段才动手,用 Edit 落盘,并且明确要求保留原有结构。这条约束看起来平淡,实际是防止模型把一份团队维护了两年的文档改成自己的排版习惯。
使用场景
最典型的场景是接手一个别人维护的仓库。你打开项目,第一部想知道的是这东西怎么跑起来,CLAUDE.md 里写的命令是半年前的。跑一次审计,报告会直接告诉你哪几条命令已经死了、哪几个目录在文档里根本不存在、哪套环境变量漏了。
monorepo 是它的强项。根目录一份总纲,下面七八个包各有一份,时间一长必然互相矛盾,A 包里说用 pnpm,B 包里还写着 yarn。逐份打分之后,平均分和需要改的文件数一目了然,你不用凭感觉猜哪份最烂。
会话结束时的补救走另一条路。同一个插件里还有个 /revise-claude-md 命令,干的是把这次会话里踩到的东西写进 CLAUDE.md,收集范围就四类:
- 这次走通的命令
- 跟着写的代码风格
- 试出来的测试路径
- 撞上的环境怪癖
它不查全仓库,只抓刚刚发生的这一小时。
不该用的情况也清楚。仓库里压根没有 CLAUDE.md,它扫不出东西,你得先手动建一个;团队根本不靠这个文件传递上下文,那这套审计就是空转;只想让它顺手把文档翻译成英文或者调格式,也别用,它的目标是让 Claude 少犯错,不是让文档好看。
洞察与反思
简洁度只占 15 分,这是整张表里最反直觉的一处。你把六个维度的权重排一下就能看出来,命令和架构各占 20,剩下四项一律 15,简洁度跟时效性、可执行性平起平坐。
我一开始觉得这分配不对。CLAUDE.md 是塞进 prompt 的东西,越长越贵,越啰嗦越容易盖住关键约束,简洁度怎么也该排第一。翻完细则改了看法:简洁的 0 分定义是“大部分是废话或者在复述显而易见的代码”,这是个否决项,不是加分项。真正在做减法的是“非显性模式”那一栏,它逼你去记那些不写下来模型一定会踩的坑,而这恰恰是最占篇幅又最值钱的内容。权重这么排,等于承认一份 200 行但全是硬货的文件,比 60 行正确的废话强。
第二个发现是它只会加,不会删。更新守则里钉了四条 avoid:
- 别复述代码里一眼可见的东西
- 别写放之四海皆准的最佳实践
- 别记一次性的偶发修复
- 别为了说清一句话写三段
这四条管的是“加得克制”,但整个流程里没有一个环节在检查“哪些内容该滚出去”。时效性那一栏能发现死掉的命令,却抓不住那些还活着但已经没用的段落。跑几轮之后文档大概率是变长而不是变精,这是结构性的,不是执行不到位。
第三个是分数的可信度。六个维度里有四项是可验证的,命令跑一遍、路径查一次、目录对一次就能核实。非显性模式和简洁度没有这种落点,基本靠模型读一遍给印象分。所以同一份文件跑两次,分数可能差个五六分,别把它当精确指标用,当趋势看就够了。真要盯,盯 issues 清单比盯总分有用。
插件里两条入口的分工值得单独摆一下:
| 维度 | claude-md-improver(Skill) | /revise-claude-md(命令) |
|---|---|---|
| 触发时机 | 定期维护、代码库有大改动 | 一次会话结束时 |
| 扫描范围 | 全仓库所有 CLAUDE.md | 当前仓库,最多 20 个 |
| 核心动作 | 六维打分加出报告 | 提取本次会话学到的东西 |
| 工具权限 | Read、Glob、Grep、Bash、Edit | Read、Edit、Glob |
| 是否先出报告 | 强制先出 | 先出 diff 再问 |
| 适合谁 | 接手项目、做技术债清理 | 每天都在同一个仓库干活的人 |
两条路的分界线是时间尺度。命令管增量,一小时一收;Skill 管存量,一季度一清。只有前者,文档会越堆越乱但每一条都新鲜;只有后者,你永远在补历史欠账。
最后提一句入口的变化。这个 Skill 在 Smithery 上有页面,但 Smithery 从十月底起已经砍掉了 MCP 代理和托管身份,只剩一个公共目录。也就是说它现在只能当索引看,要装还是走 Claude Code 自己的插件市场。
/plugin install claude-md-management@claude-plugins-official市场没预置的话先加一次源:/plugin marketplace add anthropics/claude-plugins-official。装完直接说“审一下我的 CLAUDE.md”就能触发,不用记命令。
资源地址
| 资源 | 链接 |
|---|---|
| 插件仓库 | https://github.com/anthropics/claude-plugins-official |
| Skill 源码 | https://github.com/anthropics/claude-plugins-official/tree/main/plugins/claude-md-management/skills/claude-md-improver |
| Smithery 页面 | https://smithery.ai/skills/anthropics/claude-md-improver |
| 安装命令 | /plugin install claude-md-management@claude-plugins-official |
| 同插件命令 | /revise-claude-md |
| 开源协议 | Apache 2.0 |
总结
如果你手上有一个跑了半年以上的仓库,CLAUDE.md 是某个人某天下午一口气写完再没动过的,装它。跑一次的成本是几分钟,拿到的是一份带分数和 issues 的清单,哪条命令死了、哪个目录没了、哪些坑没写,比你从头读一遍快得多。
别指望它把文档变短。它的全部逻辑是往里补有价值的东西,减法得你自己做。也别指望分数精确,六项里有两项是印象分,看趋势不看小数点。
真正值得抄的是那个结构:先出一份可核对的报告,再让人类签字,最后才允许 Edit 落盘,而且只给 Edit 不给 Write。这套东西套在任何“让模型改你的重要文件”的场景上都成立,包括你的 README、你的部署脚本、你的规范文档。判断权在谁手里,比模型有多聪明重要得多。