部署类任务里,Agent 最贵的失败模式不是敲错命令,是在前提根本不成立的时候一路往下跑。它不知道你的仓库有没有 Git remote,不知道你要的是单服务还是带数据库的一整套,也不知道 Render 的 MCP 有没有配好,就开始生成配置或者调 API。跑到一半才发现前面少了个东西,前面所有产出全部作废。
OpenAI 在 openai/skills 仓库的 .curated/render-deploy 目录下放了一份 SKILL.md,17KB,配 11 份 references 文档和 6 份现成的 render.yaml 模板。Smithery 上归在 DevOps 分类。它对外的一句话简介写得很淡:分析代码库、生成 render.yaml Blueprint、给出 Dashboard 深链。
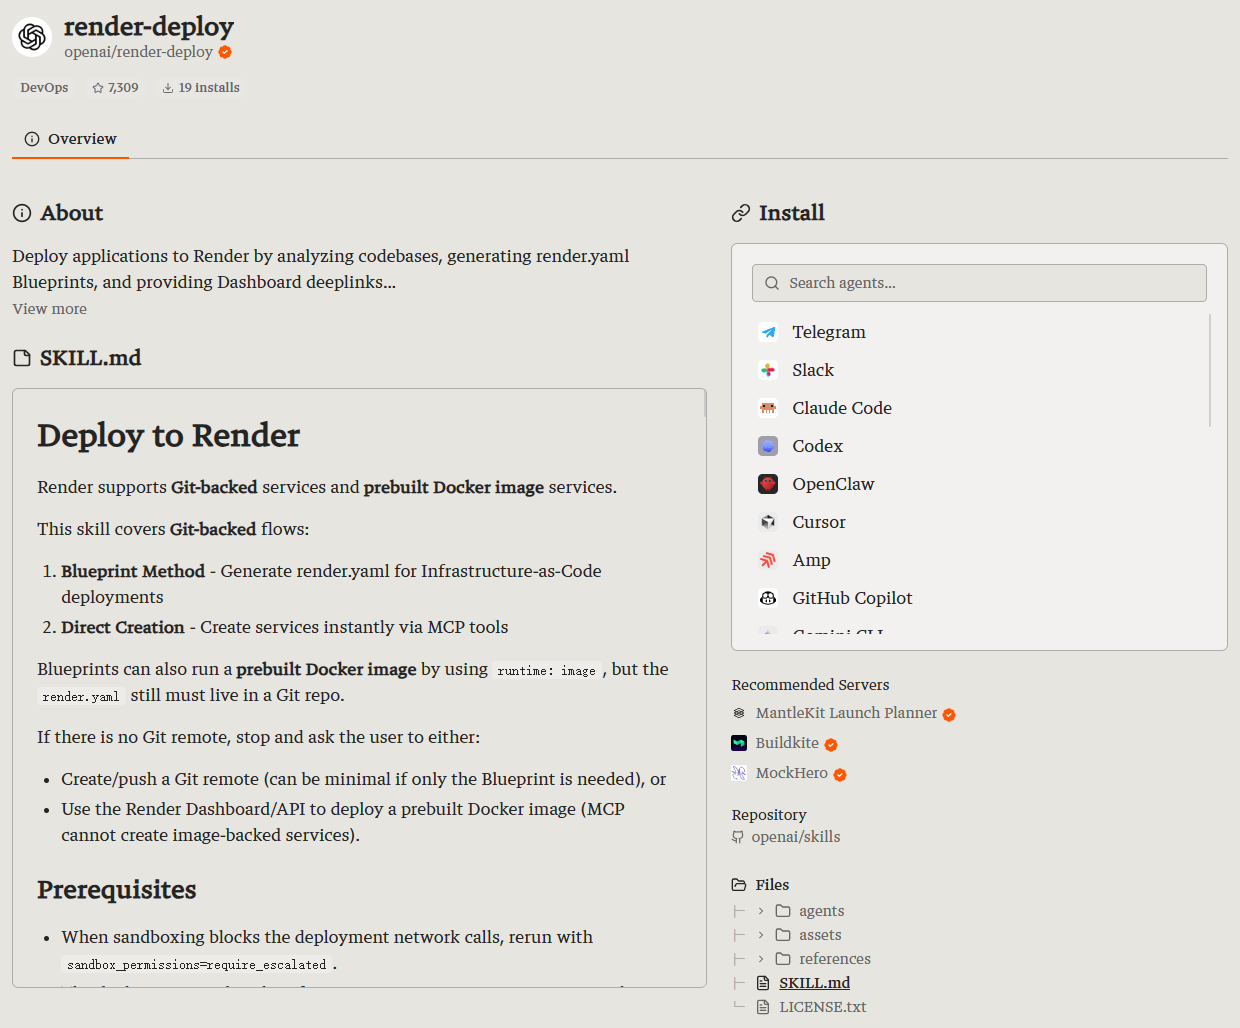
第一遍扫过去,这份文档的排版像一份 Render 平台的 API 手册,命令密密麻麻。真读进去会发现它的重心压根不在 API 上。整份 SKILL.md 里篇幅最密的是三件事:怎么用一个硬决策树先把请求分流,怎么在每条分支上设绕不过去的前置门禁,以及它明确宣布自己做不到哪些事。
这篇按架构分析的路子拆它。看四块:前置门禁怎么设,方法路由怎么定,Blueprint 的七步工作流怎么走,还有那条被写死在文档里的能力边界值不值得抄。
架构解析:闸门、路由与执行面
这份 Skill 的架构不是组件图,是一条决策流水线。它把一次部署请求拆成四段:先拿代码库事实,再验前置条件,再按分类规则选方法,最后落到具体执行面。任何一段没过,后面全部不启动。
排在最前面的是源路径确认,而且写成了硬停条件。文档原话是如果没有 Git remote,就停下来,让用户在两条路里二选一:创建一个 Git remote 并推上去,或者改用 Render 的 Dashboard 与 API 去部署预构建的 Docker 镜像。中间没有第三种可能。
git remote -v这条命令存在的意义不是获取信息,是制造一个可以判定真假的闸门。Blueprint 和 Direct Creation 两条路径都要求仓库已经推到 GitHub、GitLab 或 Bitbucket,因为 Render 要克隆你的仓库才能构建。没有 remote,后面所有生成动作都是白做。
接下来两道闸门验的是工具链是否就位。文档给了三条命令,顺序不能颠倒,MCP 优先,CLI 兜底。
list_services()              # MCP 是否可用,最优先
render --version             # CLI 是否安装,蓝图层校验要用
render whoami -o json        # CLI 是否已登录,不会自动弹窗
这里有个容易被忽略的写法:文档专门注明 render whoami 不会总是自动触发登录提示,所以要求 Agent 显式提醒用户去认证。把一条工具的行为缺陷直接写进指令里,比指望 Agent 自己撞上墙再回头要有用得多。
三道闸门之后是路由层,也就是这份文档决策密度最高的地方。它没有让模型自由判断,而是给了一条互斥的判定规则:Direct Creation 必须四个条件同时成立才允许走,Blueprint 只要命中任意一条就切过去。
Direct Creation 的准入是一条合取条件,四项必须同时成立:
- 单个服务,一个 web 应用或一个静态站
- 没有独立的 worker 或 cron
- 没有挂数据库或 Key Value
- 环境变量简单,且没有共享环境组
Blueprint 的触发是一条析取条件,命中任意一条就切过去:
- 多服务并存,比如 API 加前端
- 需要数据库或 Redis
- 有 cron 任务或后台 worker
- 想要一份可复现、能提交进仓库的 IaC 配置
- 单体仓库或多环境并存,需要统一配置来源
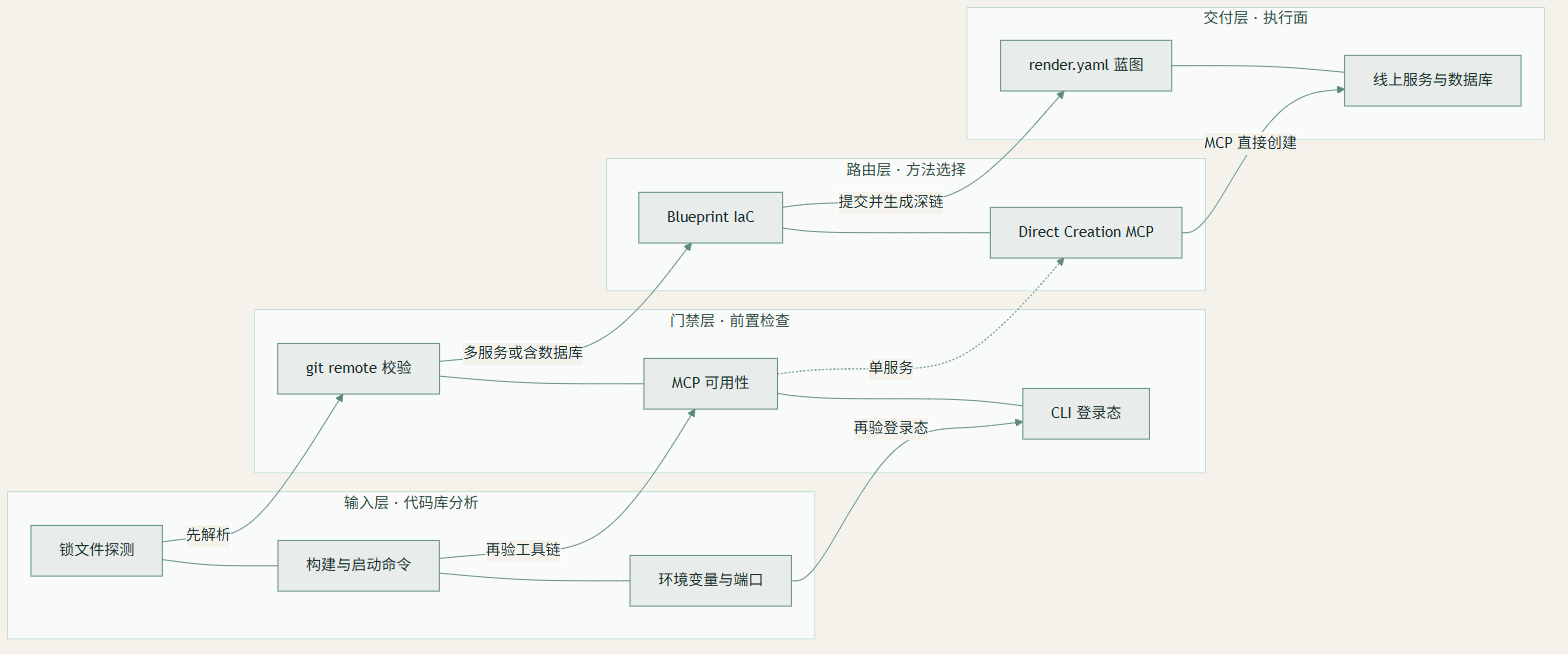
这条规则的设计意图很清楚:单服务走 MCP 最快,直接调 create_web_service 就能起一个实例,不需要在仓库里留任何配置。但只要项目里出现第二个服务或者一个数据库,手写的单次调用就会迅速失控,变量互相引用、连接串要来回传,这时换成声明式的 render.yaml 才是省事的那条路。文档在结尾还补了一句兜底:拿不准就问一句,默认往 Blueprint 那边倒。
真正诚实的一笔写在 Docker 那一段。文档明说 MCP 无法创建 image-backed service,预构建镜像的部署只能走 Dashboard 或 API。Blueprint 虽然支持 runtime: image,但 render.yaml 本身仍然必须待在 Git 仓库里。所以选 Docker 镜像的路径,实际是把用户交还给 Render 自己的控制台,Skill 只负责解释为什么。
工作流分析:七步、一份清单、三段验证
Blueprint 路径是这份 Skill 的主体,文档把它切成七个步骤,顺序固定。第一步是分析代码库,要摸清的东西列得很具体:
- 框架与运行时
- 构建命令与启动命令
- 应用读取的环境变量
- 依赖的数据存储
- 端口绑定方式
具体怎么摸,文档放在 references/codebase-analysis.md 里,按语言和包管理器给了一张对照表。判断依据不是模型的理解力,是锁文件是否存在。
| 锁文件 | 对应构建命令 |
|---|---|
bun.lockb |
bun install --frozen-lockfile |
pnpm-lock.yaml |
pnpm install --frozen-lockfile |
yarn.lock |
yarn install --frozen-lockfile |
package-lock.json |
npm ci |
uv.lock |
uv sync |
poetry.lock |
poetry install --no-dev |
requirements.txt |
pip install -r requirements.txt |
第二步生成 render.yaml。文档在这一步钉了四条硬要求:
- 除非用户另有说明,一律
plan: free - 把应用需要的环境变量全部列进去
- 密钥用
sync: false标记,让用户在控制台里自己填 - 服务类型从 web、worker、cron、static、pserv 里选对
services:
  - type: web
    name: nextjs-app
    runtime: node
    plan: free
    buildCommand: npm ci && npm run build
    startCommand: npm start
    healthCheckPath: /api/health
    envVars:
      - key: DATABASE_URL
        fromDatabase:
          name: postgres
          property: connectionString
      - key: NEXTAUTH_SECRET
        sync: false        # 密钥,用户自己在控制台填
      - key: JWT_SECRET
        generateValue: true  # 平台自动生成
第二步和第三步之间还夹着一个小节,编号写作 2.5,标题叫 Immediate Next Steps。它要求每次生成完 render.yaml 之后,都必须给用户一份短清单,能跑的命令立刻跑掉:
- 认证,跑
render whoami -o json - 校验,跑
render blueprints validate - 提交推送,把 render.yaml 推到远端
- 打开蓝图深链
- 填
sync: false的密钥 - 点 Apply 部署
这条规定的价值在于它把校验从“建议”变成了“默认动作”。
第三步是校验配置,第四步是提交推送,第五步生成深链,第六步把用户引导进控制台。深链的格式是固定的,https://dashboard.render.com/blueprint/new?repo= 后面拼仓库的 HTTPS 地址。
render blueprints validate                                  # 先校验
git add render.yaml && git commit -m "Add Render deployment configuration" && git push origin main
git remote get-url origin                                   # 取地址,SSH 需转 HTTPS
# git@github.com:user/repo.git  ->  https://github.com/user/repo
深链那一步藏着整个流程里最要命的前置依赖。文档用加粗写着:用户必须先把 render.yaml 合并进仓库,再点深链。原因是 Dashboard 打开深链时会去仓库里读这份文件,文件没推上去,Render 找不到配置,部署会直接失败。所以文档要求 Agent 在给链接之前先确认文件在远端。
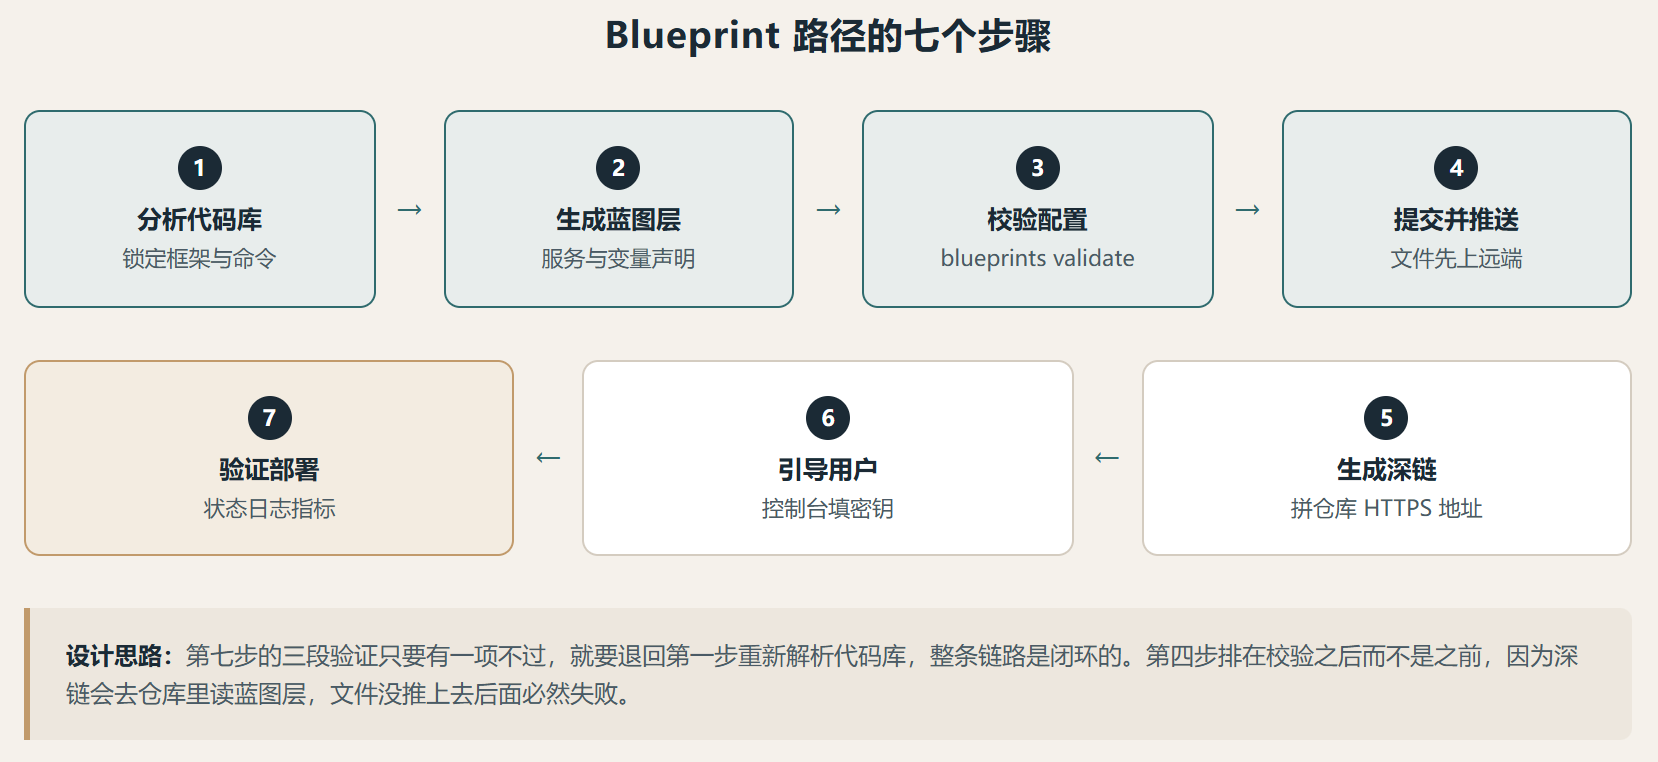
第七步验证是三段检查,全部通过 MCP 完成。先查部署状态要看到 live,再扫错误日志,最后拉一次指标。如果出错,文档要求跳到 troubleshooting 或 error-patterns 两份参考里去对症状。
| 日志特征 | 大概率原因 | 对应动作 |
|---|---|---|
| KeyError / missing environment | 环境变量缺失 | 补变量后重新部署 |
| EADDRINUSE | 端口绑定冲突 | 改绑 0.0.0.0:$PORT |
| ECONNREFUSED | 数据库连不上 | 核对 DATABASE_URL 与库状态 |
| exit 137 / out of memory | 内存超限 | 降内存占用或升配置 |
| Health check timeout | 健康检查无响应 | 补健康检查端点并核对端口 |
这张表的价值不在内容本身,在于它把“看日志猜原因”这一步从模型的自由发挥变成了查表。日志特征、原因、动作三列一一对应,模型不需要理解,只需要匹配。
Direct Creation 路径就是另一套了。它跳过了整个文件生成和提交环节,直接调 MCP 的创建接口。文档里列出的动作一共六个:
create_web_service          # 单个 web 服务
create_static_site          # 静态站点
create_cron_job             # 定时任务
create_postgres             # PostgreSQL 数据库
create_key_value            # Redis 兼容的 Key Value
update_environment_variables  # 创建后补环境变量
创建完之后补环境变量,然后复用同一套三段验证。
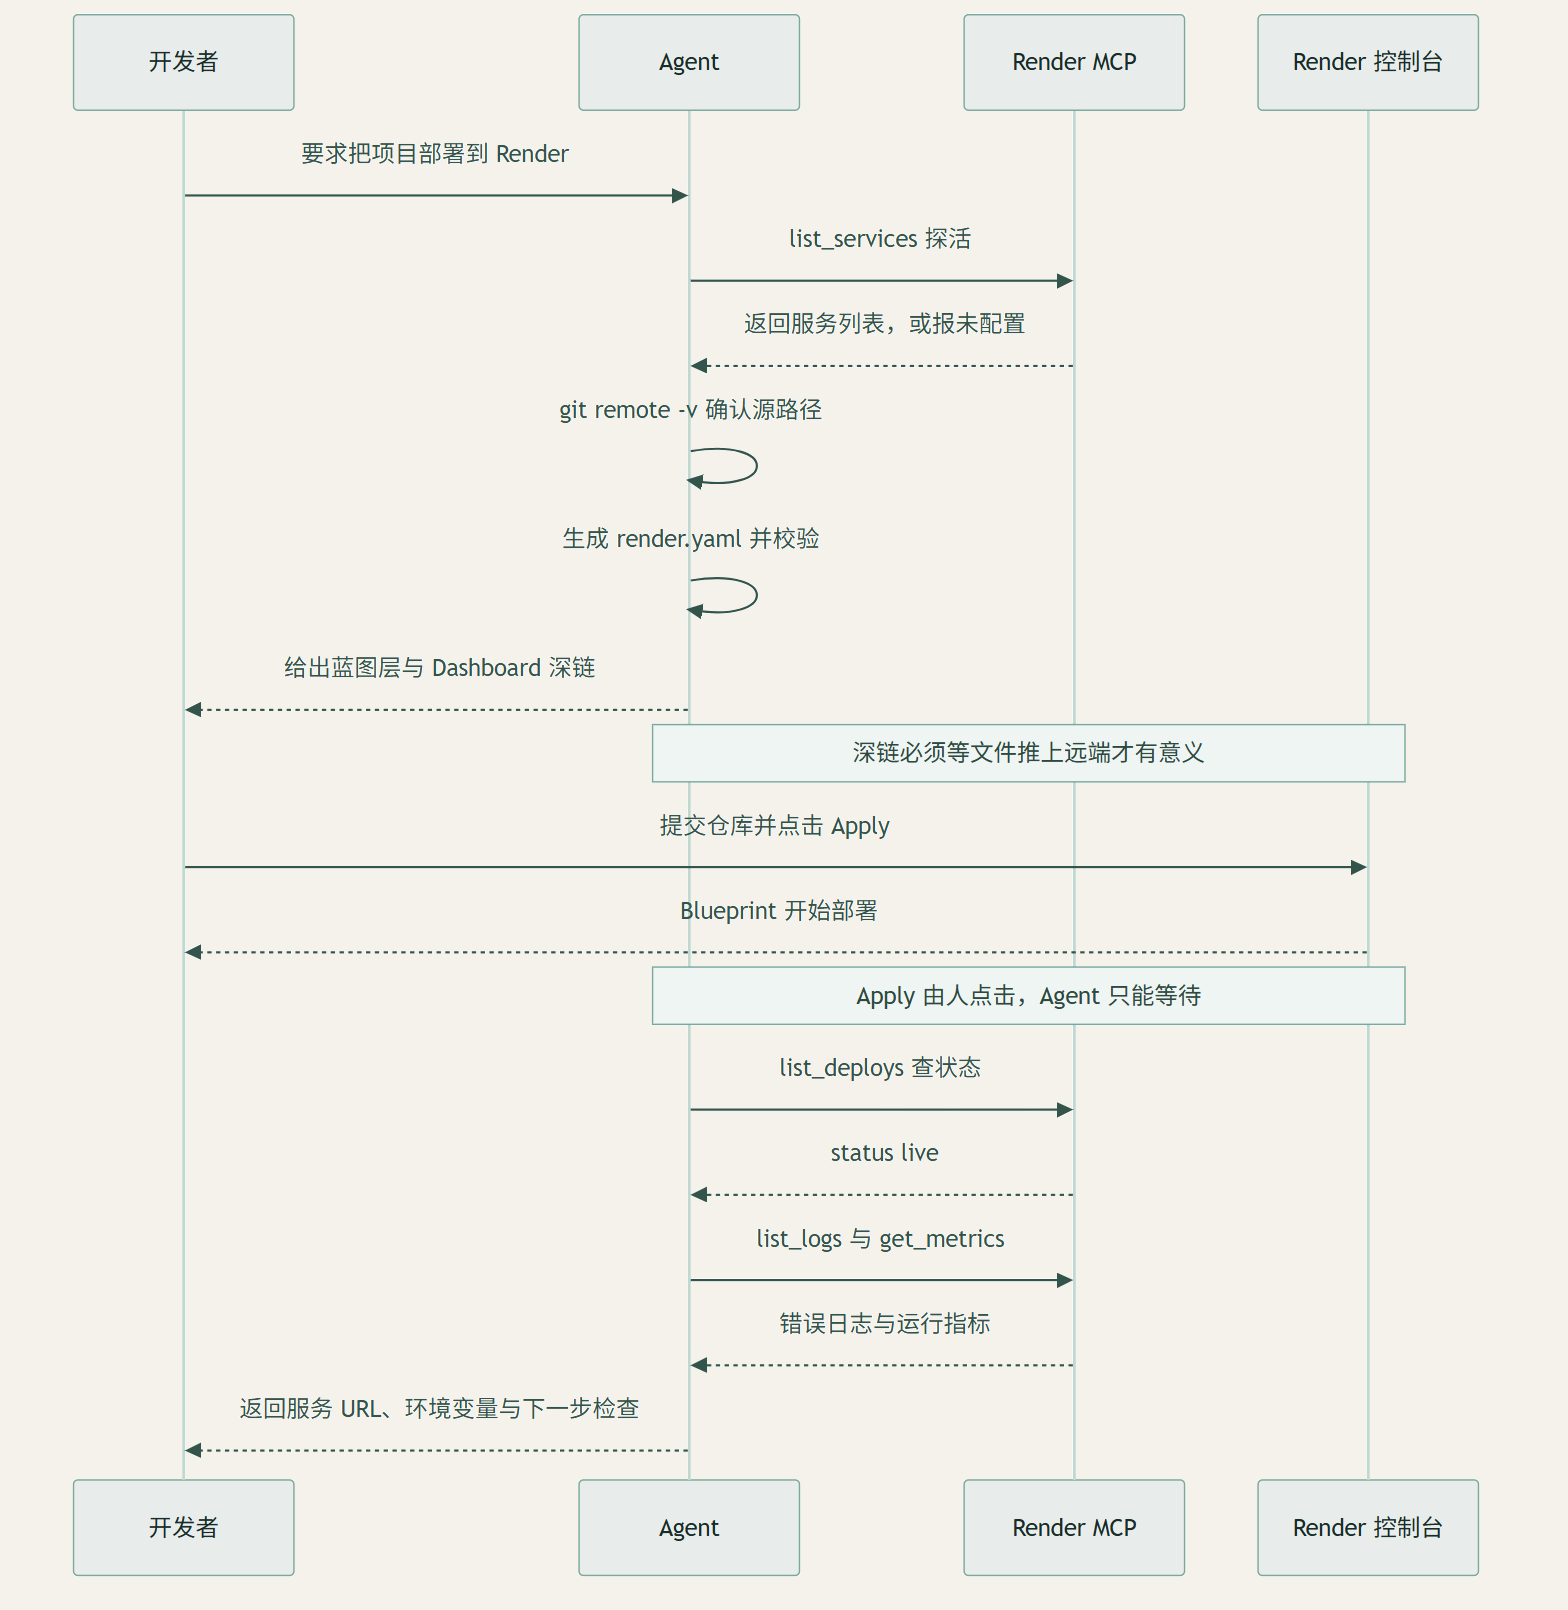
时序图上有一个很关键的断点。第 6 步到第 7 步之间,控制权交给了人。Agent 生成链接之后能做的事情就结束了,真正的 Apply 是用户在浏览器里点的,Agent 只能等,等完再来查状态。这不是能力不足,是 Blueprint 这个产品的形态决定的。
使用场景与边界
最能体现这套设计价值的场景是单服务快速上线。一个 Node 的 API 或者一个静态站,没有数据库,环境变量只有两三个。这时候路由规则会把它送进 Direct Creation。Agent 先探活 MCP,再创建服务,补上环境变量,最后验证状态。整个链路里没有任何文件需要落到仓库里,用户拿到的是一条 https://xxx.onrender.com 的地址。
另一个场景是全栈项目,Next.js 加 PostgreSQL 那种。路由规则会因为“存在数据库”直接跳到 Blueprint,Agent 生成一份带 fromDatabase 引用的 render.yaml,把密钥标成 sync: false,校验通过之后交给用户推代码、填密钥、点 Apply。这条路径多了几步人工,但换来的是配置进了 Git 历史,下次改环境可以直接 diff。
真正被拒掉的场景同样重要。没有 Git remote 的裸目录,Docker 镜像直推,这两个请求连第一步都过不去。文档的处理方式是停下来解释原因,并且给出替代路径,而不是硬着头皮试。从文档写法来推断,这条硬停是有意设计的:宁可让用户多走一步去建仓库,也不要让 Agent 生成一份根本推不上去的配置。
洞察与反思
这份文档里最值得学的写法是显式声明做不到的事。这类负向信息在文档里散落得到处都是:Docker 镜像部署走不通 MCP 这条路,MCP 缺失时该怎么降级,CLI 没装时给哪条安装命令,还有 render whoami 并不会自动弹窗。大多数 Prompt 只写正向能力清单,读完不知道边界在哪。把“什么情况下我会停下来”写清楚,Agent 的失败模式立刻从“做错”变成“早停”,后者的代价小一个数量级。
第二个细节是渐进式披露的切分方式。主文档 17KB,只保留决策和流程,所有需要查证的细节推到 11 份 references 里,用一句话指路,比如“用 references/codebase-analysis.md 里的详细检查表”。这样主文档保持可读,细节又不会丢。代价是模型得愿意顺着引用再读一层,而这一步在实际执行里并不总是会发生。
局限也清楚。整条链路假设 Agent 有 MCP 或者 CLI 中的至少一样,两样都没有的时候,流程会退化成“教用户配环境”。MCP 配置说明按 Cursor、Claude Code、Codex 三家分别写了一遍,其他工具一律指去官方文档,这等于把配置成本转嫁给了用户。
另一处硬伤是 sandbox_permissions=require_escalated 这个提权提示。它是某个特定宿主环境的参数写法,Claude Code 和 Cursor 里并没有对应机制。文档在触发条件里也没有给出可判定的标准,只说“当沙箱阻断网络时”,具体是超时、DNS 失败还是连接重置,全靠模型自己归类。
还有一点是 references 里的枚举会漂。计划档位从 free 一路列到 pro_ultra,部署区域也一口气写了五个。Render 一旦调价或加区,这批文档就过期了,而 Skill 本身没有任何校验机制能发现这件事。
资源地址
| 资源 | 地址 |
|---|---|
| Smithery 页面 | https://smithery.ai/skills/openai/render-deploy |
| 仓库根目录 | https://github.com/openai/skills |
| Skill 源码 | https://github.com/openai/skills/tree/main/skills/.curated/render-deploy |
| render.yaml 规范 | https://github.com/openai/skills/blob/main/skills/.curated/render-deploy/references/blueprint-spec.md |
| Render MCP 服务端 | https://mcp.render.com/mcp |
| Render 控制台 | https://dashboard.render.com |
总结
render-deploy 是一份把部署流程从“帮我想想怎么做”改造成“按规则走”的工程样本。它的核心特征可以归成四条:用硬停条件确认源路径,用互斥规则选执行方法,用固定顺序的工作流保证可复现,用显式的负向声明控制失败半径。
适合它的场景很明确:
- 代码已经在 Git 仓库里
- 目标平台就是 Render
- 项目形态落在单服务和多服务之间
不适合的情况也清楚:
- 完全没有版本控制
- 坚持要用预构建镜像直推
- 宿主环境既不提供 MCP 也不提供 CLI
如果要抄,抄这四个动作,而不是抄 Render 的命令:前置检查做成硬停而不是提示,方法分流写成互斥规则而不是建议,把“必然失败的依赖”写进流程的加粗位置,以及把做不到的事情列成清单放在显眼处。Render 是这些动作的载体,换到 Vercel、Fly.io 或者任何一套基于 IaC 的平台,这套骨架照样成立。