你让 Agent 部署一下,它回你一个链接。这句指令里藏了一堆没说出口的前提。人有账号,人清楚自己在哪个仓库,人默认部署出来的东西挂在预览环境而不是线上。Agent 一个都不知道,它手上只有一句指令和一堆工具。
vercel-deploy 是 openai/skills 仓库 curated 目录下的一个 Skill,在 Smithery 上归到 DevOps 分类,页面显示 7,309 星、17 次安装。安装量小得可以忽略。它出自 OpenAI 官方维护的 Codex 技能目录,那个仓库 2025 年 11 月建,现在 27,993 星、1,918 fork,README 顶部已经挂了弃用横幅,指向新的 openai/plugins。
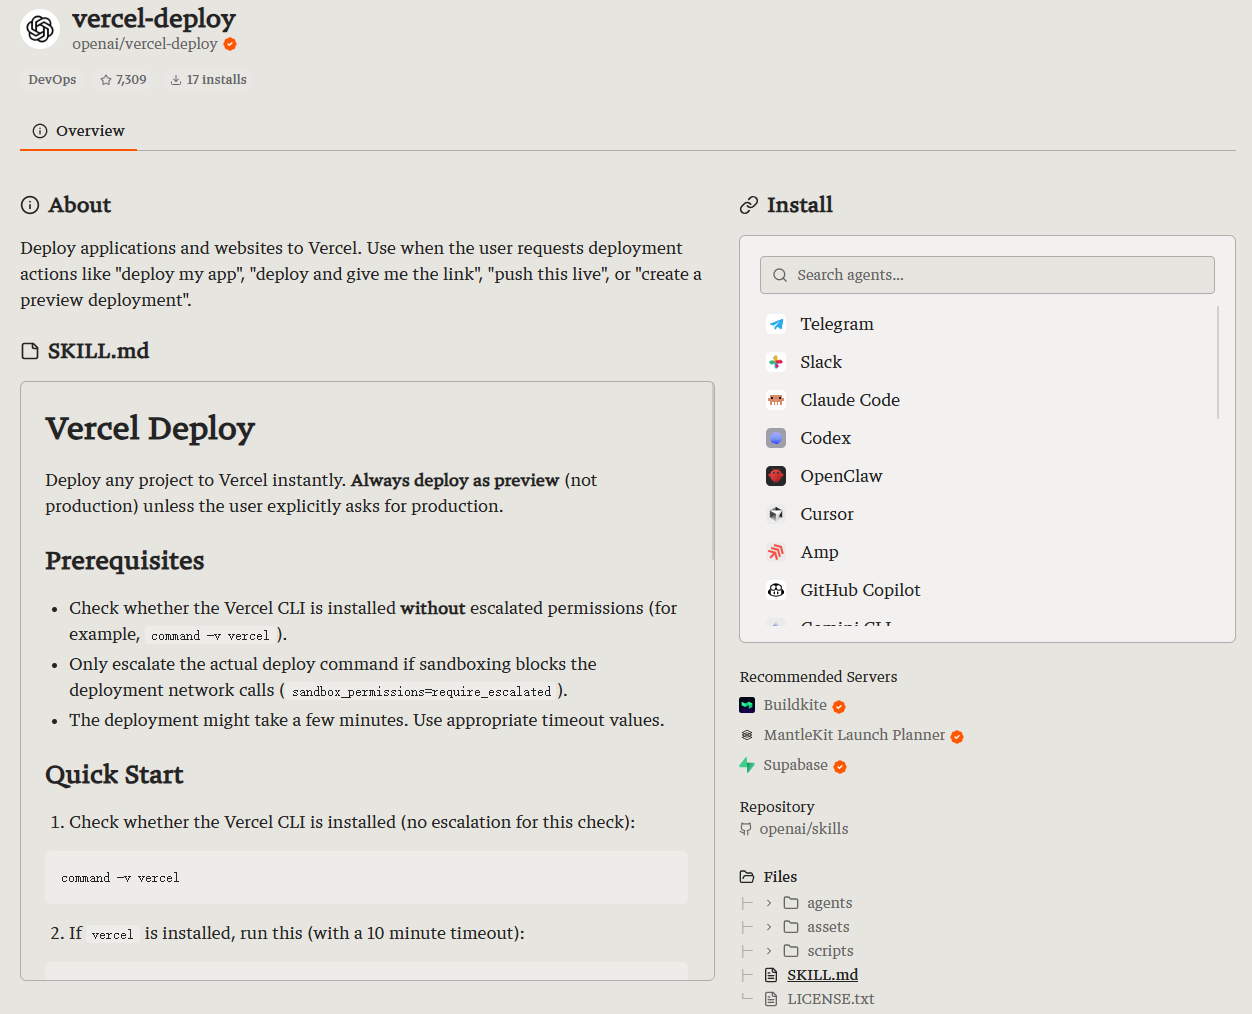
扫一眼 SKILL.md,2653 字节,一个命令加一段回退说明,看起来就是个薄壳。真正让我停下来的是 scripts 目录里那个 8877 字节的 deploy.sh,体积是 SKILL.md 的三倍多。一个部署 Skill 把大半体量放在 shell 脚本里,这件事本身就说明设计重心不在提示词上。
我的判断很直接:这是 openai/skills 里设计最完整的 Skill 之一。它没用任何新东西,工具全是最普通的那些,vercel CLI、bash 外加 curl。但组合方式解决了一个真问题。一个没有账号、也没有沙箱网络权限的 Agent,怎么完成一次部署,并且留下一个可以认领的凭据。
使用场景
部署请求在 Agent 手里分三种成色,Skill 对这三类的处理差别很大。最常见的是“给我个预览链接”,这类请求要的是看到东西,不在乎域名、不在乎挂多久。第二类是“推到线上”,危险得多,但触发词往往同样随意。第三类是“让它长期跑着”,vercel-deploy 基本不管,它给的是不可变部署,不是可持续托管。
SKILL.md 开篇第一句就把规则立住了:除非用户明确要求生产环境,否则永远部署成预览。这句话有分量,因为 Vercel CLI 的默认行为恰好跟它对齐。vercel deploy 不带 --prod 时本来就产出预览部署,所以策略不需要额外参数去兑现,用默认值就够了。让策略落在默认路径上,比事后补校验可靠得多。
不过默认值对齐只保证了方向,没保证没人绕过去。生产部署那条路在 SKILL.md 里只占两行。
vercel deploy [path] --prod -y没有前置校验,没有分支确认,没有二次询问。唯一的护栏是上面那句散文式的 Only if user explicitly asks。拿它跟预览部署那段一比,落差很明显:预览那一路写死了超时、写死了权限约束,生产这一路几乎是裸的。这是个真实的软肋,后面还会回到它。
真正花心思的是第二条路径:CLI 万一不能用怎么办。Skill 给了一道明确的探测题,而且对这道题本身做了权限约束。
command -v vercel这条检查必须在没有提权的前提下跑,文档里专门写了一句,只有真正的部署命令才允许申请提权。这个区分不是洁癖,是安全边界。判断一个二进制存不存在是纯本地读操作,不该顺带获得出网权限。把探测和执法的权限分开,这是整个 Skill 里我最欣赏的一处设计。
探测通过就走第一通道,vercel deploy [path] -y,超时给到 10 分钟,因为构建可能要跑很久。如果命令不存在,或者命令回来一句 No existing credentials found,就切第二通道,调用 deploy.sh。
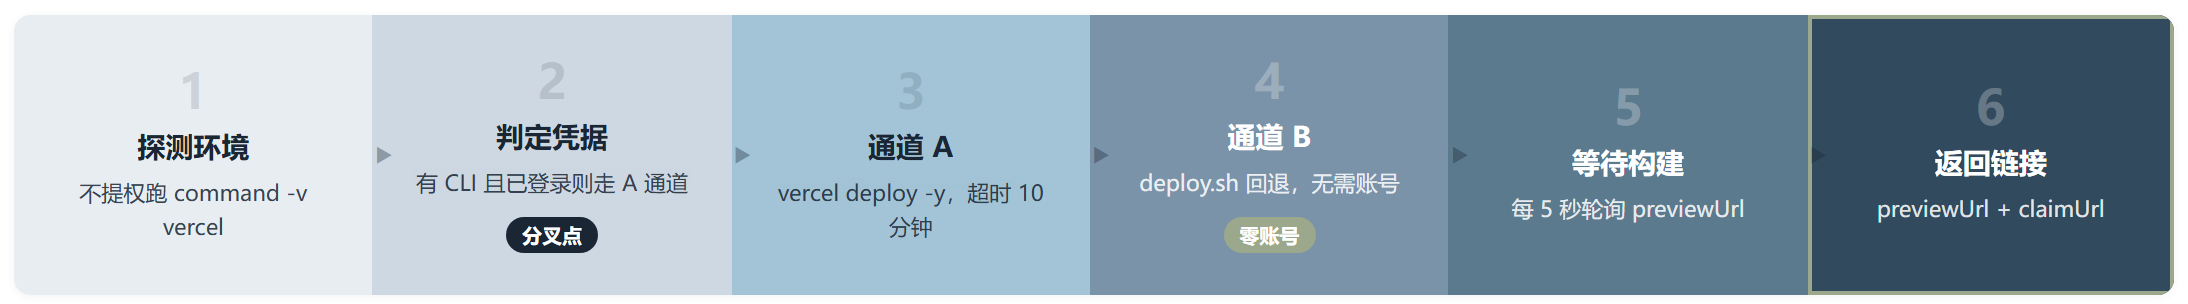
回退路径的调用方式很朴素,三种输入形态摆在一起:
skill_dir="<path-to-skill>"

# 部署当前目录
bash "$skill_dir/scripts/deploy.sh"

# 部署指定项目
bash "$skill_dir/scripts/deploy.sh" /path/to/project

# 部署已有 tarball
bash "$skill_dir/scripts/deploy.sh" /path/to/project.tgz
三条命令的差别只在参数,脚本内部会自己判断拿到的是目录还是压缩包。这个接口设计得比大多数 CLI 工具克制,没有子命令、没有 flag 矩阵,两种输入、一条路径。
技术架构与设计决策
deploy.sh 全文 8877 字节,只做四件事,探测框架、打包、上传和轮询,每一件都值得拆开看。
框架探测是一张手写的 if 链,按具体程度排序,覆盖大约四十个框架。顺序是这里的关键,越具体的越靠前。Blitz 和 Next.js 排在 Gatsby 前面,Remix 排在 React Router 前面,Vite 被压到最末,因为几乎每个现代前端项目都会在 devDependencies 里写上 vite。
has_dep_exact()  { echo "$content" | grep -q "\"$1\""; }
has_dep_prefix() { echo "$content" | grep -q "\"$1"; }

if has_dep_exact "next";        then echo "nextjs";   return; fi
if has_dep_exact "gatsby";      then echo "gatsby";   return; fi
if has_dep_prefix "@remix-run/"; then echo "remix";   return; fi
# ……约 40 条,从具体到宽泛
if has_dep_exact "vite";        then echo "vite";     return; fi
这里有一处刻意设计。作用域包族走前缀匹配,比如 @remix-run/、@redwoodjs/、@storybook/;其余走精确匹配。原因不难想:精确匹配会漏掉同一个 scope 下的兄弟包,前缀匹配又会把整个 scope 的任意包都算成命中。两者各有代价,分开处理是唯一合理的折中。
打包环节有一段我觉得写得比多数 CI 脚本讲究。它先把项目复制进一个临时 staging 目录,再打包 staging,而不是直接打包源目录。
tar -C "$PROJECT_PATH" \
    --exclude='node_modules' \
    --exclude='.git' \
    --exclude='.env' \
    --exclude='.env.*' \
    -cf - . | tar -C "$STAGING_DIR" -xf -
多这一层 staging 是为了不污染源树。静态 HTML 项目还有个细节:如果根目录只有一个 HTML 文件而且不叫 index.html,脚本会把它改名成 index.html。这个改名动作如果直接作用于源目录,用户的文件就被悄悄动过了。走 staging 之后,改名只发生在上传副本里,本地一个字节没变。
第三件事是一次 multipart POST,终点是 https://codex-deploy-skills.vercel.sh/api/deploy,带上打包好的 tgz 和探测出来的框架名。响应里有两个 URL,previewUrl 和 claimUrl。零账号部署就是靠这个实现的:先给你一个匿名可访问的部署,再给一个认领链接,让你事后决定要不要把它挂到自己账号下。
第四件事是轮询,脚本对 previewUrl 每 5 秒打一次,最多 60 次,合计 5 分钟。
if   [ "$HTTP_STATUS" -eq 200 ];                          then ready
elif [ "$HTTP_STATUS" -ge 500 ];                          then sleep 5   # 平台还在构建
elif [ "$HTTP_STATUS" -ge 400 ] && [ "$HTTP_STATUS" -lt 500 ]; then ready
fi
最后这条 4xx 判定容易被当成随手写的,其实它是刻意的。部署本身如果成功了,应用自己返回 404 是完全正常的,把 4xx 也算成“还在构建”会让脚本白等五分钟。区分平台没准备好和应用自己说找不到,这种判断只有真跑过才会写进去。
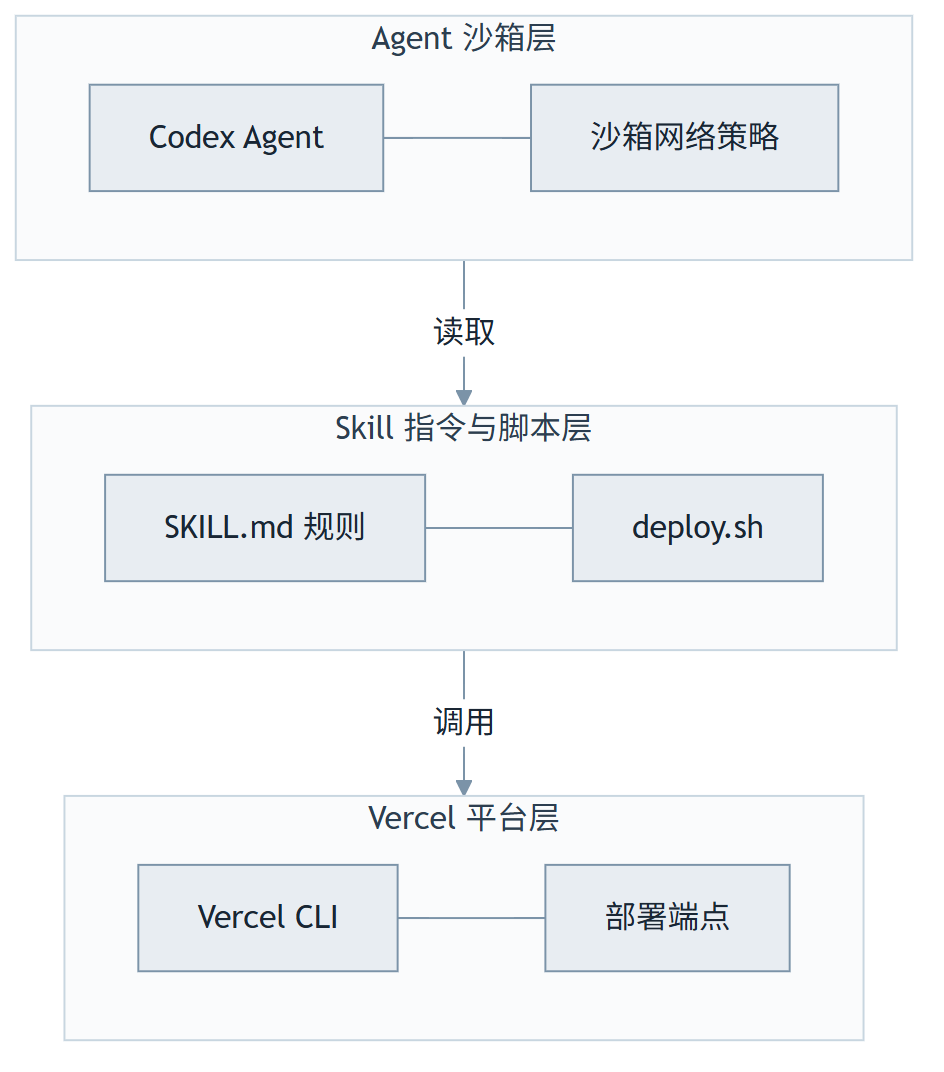
整个链路摊开是一张三层图,值得把边界单独标出来。
洞察与反思
我最认可的一处设计在权限分层上。探测不提权,部署才提权,文档还专门强调不要把 command -v 也升上去。这条规则看着像琐碎的工程细节,实际是给 Agent 划了一条最小权限线。它把一个抽象的“要谨慎”变成了具体到命令行级别的动作,可执行性比任何措辞都强。
第二条通道的整个存在意义,是把“没有账号”从阻塞变成延迟。常规流程的入口就是登录,没账号的人根本进不来。claimable 模式把这个顺序翻过来了,先给一个能访问的部署,再让你事后决定要不要认领。对 Agent 场景来说这个顺序更合理,因为 Agent 从来就不该替你登录。
但这里有个我认为被低估的问题:那个 tgz 里装的是你项目的全部内容。脚本排除了 node_modules 和 .git,也排除了 .env 系列,这一层覆盖得不错。可它不排除下面这几类东西:
.npmrc,里面常带私有源 token.vercel,项目与团队的绑定信息service-account.json之类的服务账号凭据- 私钥、证书(
.pem、.p12) - 任何自定义命名的密钥文件
也就是说,走第二通道的时候,项目里所有非 .env 命名的凭据都会被打包送到第三方端点。这不是理论风险,是打包规则的直接结果。
还有一条反常指令,第一次读的时候我以为是笔误。
Do not curl or fetch the deployed URL to verify it works. Just return the link.
明令禁止 Agent 复查部署结果。放在一般语境里这很难理解,验证部署能不能用难道不是好事。结合脚本看就说得通了:deploy.sh 自己已经在轮询 previewUrl 并等到 200,重复检查是纯粹的浪费。走 CLI 通道时,vercel CLI 本身也会等到构建结束才返回。这条禁令省下的是一次多余的网络往返和一段没必要的 token。
代价也很清楚。轮询只能证明域名有响应,证明不了页面内容正确。部署成功但首页是白屏或者一页错误提示,这个 Skill 不会告诉你。它把“部署发起成功”当成了终点,而不是“部署结果可用”。要个链接给人看,这样够用;要接进 CI 做门禁,不够。
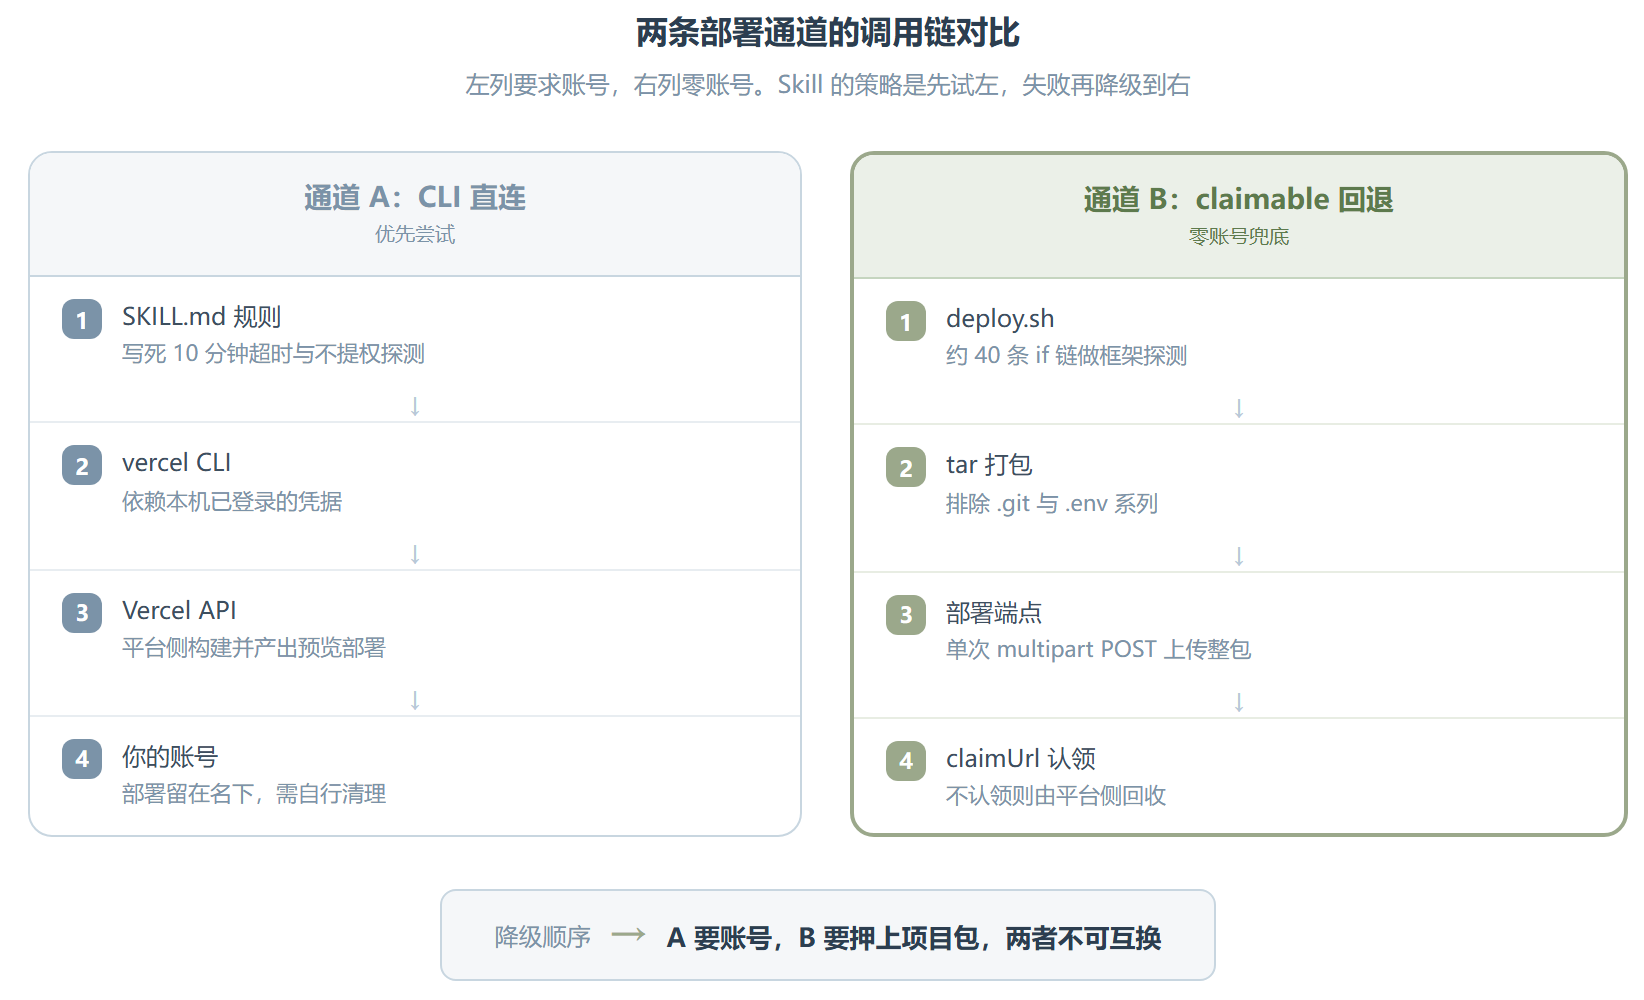
两条通道放在一起看,定位差异比表面大得多。
| 维度 | CLI 直连通道 | claimable 回退通道 |
|---|---|---|
| 认证前提 | 需要 vercel 已登录 | 零账号 |
| 网络依赖 | Vercel API + CLI | 单个 POST 端点 |
| 框架判定 | CLI 自行识别 | 脚本内约 40 条 if 链 |
| 产物归属 | 直接进你的账号 | 靠 claimUrl 事后认领 |
| 典型失败 | 凭据失效、构建报错 | 端点不可用、包超限 |
| 清理成本 | 部署堆在你账号里 | 未认领由平台回收 |
左边那一列是“能力更强但前提更重”,右边那一列是“前提为零但能力受限”。Skill 的选择是先要能力,拿不到再降级,而不是直接走最保险的路径。这个优先级跟人类的判断顺序一致,值得抄。
还有个收尾问题:没有清理。SKILL.md 里找不到 vercel rm,也找不到任何关于部署堆积的讨论。每次调用都产生一个新部署。走 claimable 通道的部署在未认领时由平台侧回收,这条链路是干净的;走 CLI 通道的部署会落在你自己账号里,然后一直躺在那儿。Skill 不提这件事,等于把这个运维成本默认转给了用户。
最后说一句生产部署那条路。我在前面标了它是软肋,理由在这里补完。这个 Skill 对预览部署的每一条路径都做了机制化约束,唯独对生产部署只留了一句自然语言。而这恰恰是唯一会直接影响真实用户的动作。规则写成了提示,就不再是规则。
资源地址
| 资源 | 链接 |
|---|---|
| Smithery 页面 | https://smithery.ai/skills/openai/vercel-deploy |
| 源码仓库 | https://github.com/openai/skills |
| 技能目录 | https://github.com/openai/skills/tree/main/skills/.curated/vercel-deploy |
| 后续仓库(官方推荐) | https://github.com/openai/plugins |
| 部署端点 | https://codex-deploy-skills.vercel.sh/api/deploy |
| Vercel CLI 文档 | https://vercel.com/docs/cli/deploy |
总结
你要是经常让 Agent 干“部署一下给我个链接”这种活,这个 Skill 值得装。它的价值不在命令本身,那些人都会,而在两条通道的降级顺序和权限分层。沙箱里没有登录态、网络还被限制的环境下,它至少能给你一个能访问的链接,这一步在很多同类 Skill 里是直接失败的。
反过来,如果你要的是持续托管、自定义域名、CI 流水线接入,它一次都不该用。它给的是不可变部署和一次性链接,不是托管方案。还有一件事得提前想清楚:走回退通道意味着你的项目包会被送到第三方端点,装之前先确认工作区里没有非 .env 命名的凭据文件。
时效性也得提一句。endpoint 域名里带的是 codex,而 Codex 的仓库结构已经从 openai/skills 迁到 openai/plugins,这个端点跟不跟着迁、还能活多久,文档里没有答案。另外那个约四十条的框架探测链是手写维护的,新一代框架(Bun 系、各种 React Server 框架)加进来之前,它只能返回 null,把判定权交回给 Vercel 自己。用之前先跑一遍自己的项目,比相信任何 Skill 描述都靠谱。
说到底,这个小东西真正值得学的是一句话:约束要写成机制,不要写成提示。它能管住预览部署,是因为每一步都对应一条会失败的命令;它管不住生产部署,是因为那一步只写了一句希望。