AI 成本优化这个赛道,过去两年的标准答案是在 HTTP 边界上架一个网关。请求进来,路由器看看 prompt 长短,决定转发给哪个模型,转发完记一笔账。LiteLLM、OpenRouter、Portkey 都是这个思路。cascadeflow 的 README 第一段就把这个思路掀了,它说自己在 external proxies can’t 的地方工作,基于 Agent 的实时状态做每一步的模型决策。
表面上看又是一个模型路由器,但翻完文档我发现它其实在做另一件事:一个跑在 Agent 进程里的运行时治理层。项目 2025 年 10 月 24 日上线,MIT 协议,背后是纽约和苏黎世的 Lemony Inc.,拿过 True Ventures 的投资。上线差不多一年,截至 2026 年 10 月拿到 3944 个 Stars、885 个 Fork。
官方基准很唬人:MT-Bench 省 69%,GSM8K 省 93%,MMLU 省 52%,TruthfulQA 省 80%,同时号称保留 GPT-5 96% 的质量。粗算就是整体成本砍掉四到八成,响应快 2 到 10 倍,10B 以下的小模型扛下六到七成查询。CEO 在发布时说了句大实话,回答 2 加 2 等于几,不需要旗舰模型出手。
数字谁都会写。这篇文章想弄清楚三件事:它宣称的循环内决策到底是不是新东西,那套级联机制在工程上成不成立,以及最关键的,你现在该不该把它接进自己的项目?
它到底智能在哪
我最看重的是 inside-the-loop 这个切入点。外部网关看到的是一个个孤立的 HTTP 请求,cascadeflow 看到的是 Agent 的完整执行态:这一步在干什么、上次工具调用结果如何、预算还剩多少。基于这些上下文,它每一步可以发出四种动作,allow、switch_model、deny_tool、stop。给工具调用设预算闸门、在子 Agent 交接时切模型,这种请求级工具根本碰不到的操作,它天然就能做。
第二层是推测执行。小模型先乐观作答,质量引擎用可配置阈值验证完整性、置信度、正确性,不达标才升级到旗舰模型。跑得多的查询还会沉淀成模式,反过来优化后续的领域路由。这套思路本身不新,但它把质量验证做成了引擎,而不是丢给用户自己写的回调函数。
更有意思的是六维评分。成本、延迟、质量、预算、合规、能源,每个 Agent 步骤都在这六个维度上被打分,然后决定执行哪个动作。合规维度可以直接声明 gdpr,KPI 权重也能运行时注入,业务意图终于不用硬编码在一堆 if-else 里。这是我在文档里翻到的最像企业需求的设计。
三层接入路径也显出工程品味。Tier 1 是 observe 模式,一行代码不改就能观测所有 OpenAI 和 Anthropic SDK 调用;Tier 2 用 with 语句包一个带预算的作用域,出来直接拿成本、延迟、能耗和完整决策轨迹;Tier 3 才轮到装饰器上策略。先观察再接管,灰度发布的成本几乎为零,这种节奏感很多框架一辈子学不会。
生态中立也是真的。17 家以上 provider,LangChain、OpenAI Agents SDK、CrewAI、PydanticAI、Google ADK、n8n、Vercel AI SDK、Hermes Agent 都有集成入口,Python 和 TypeScript 双语言 API 基本对齐。不想被绑死的团队,这一点很实在。
把路由、级联、验证、provider 这几层拼起来看,它的运行时结构大致是这样的,一图胜千言。
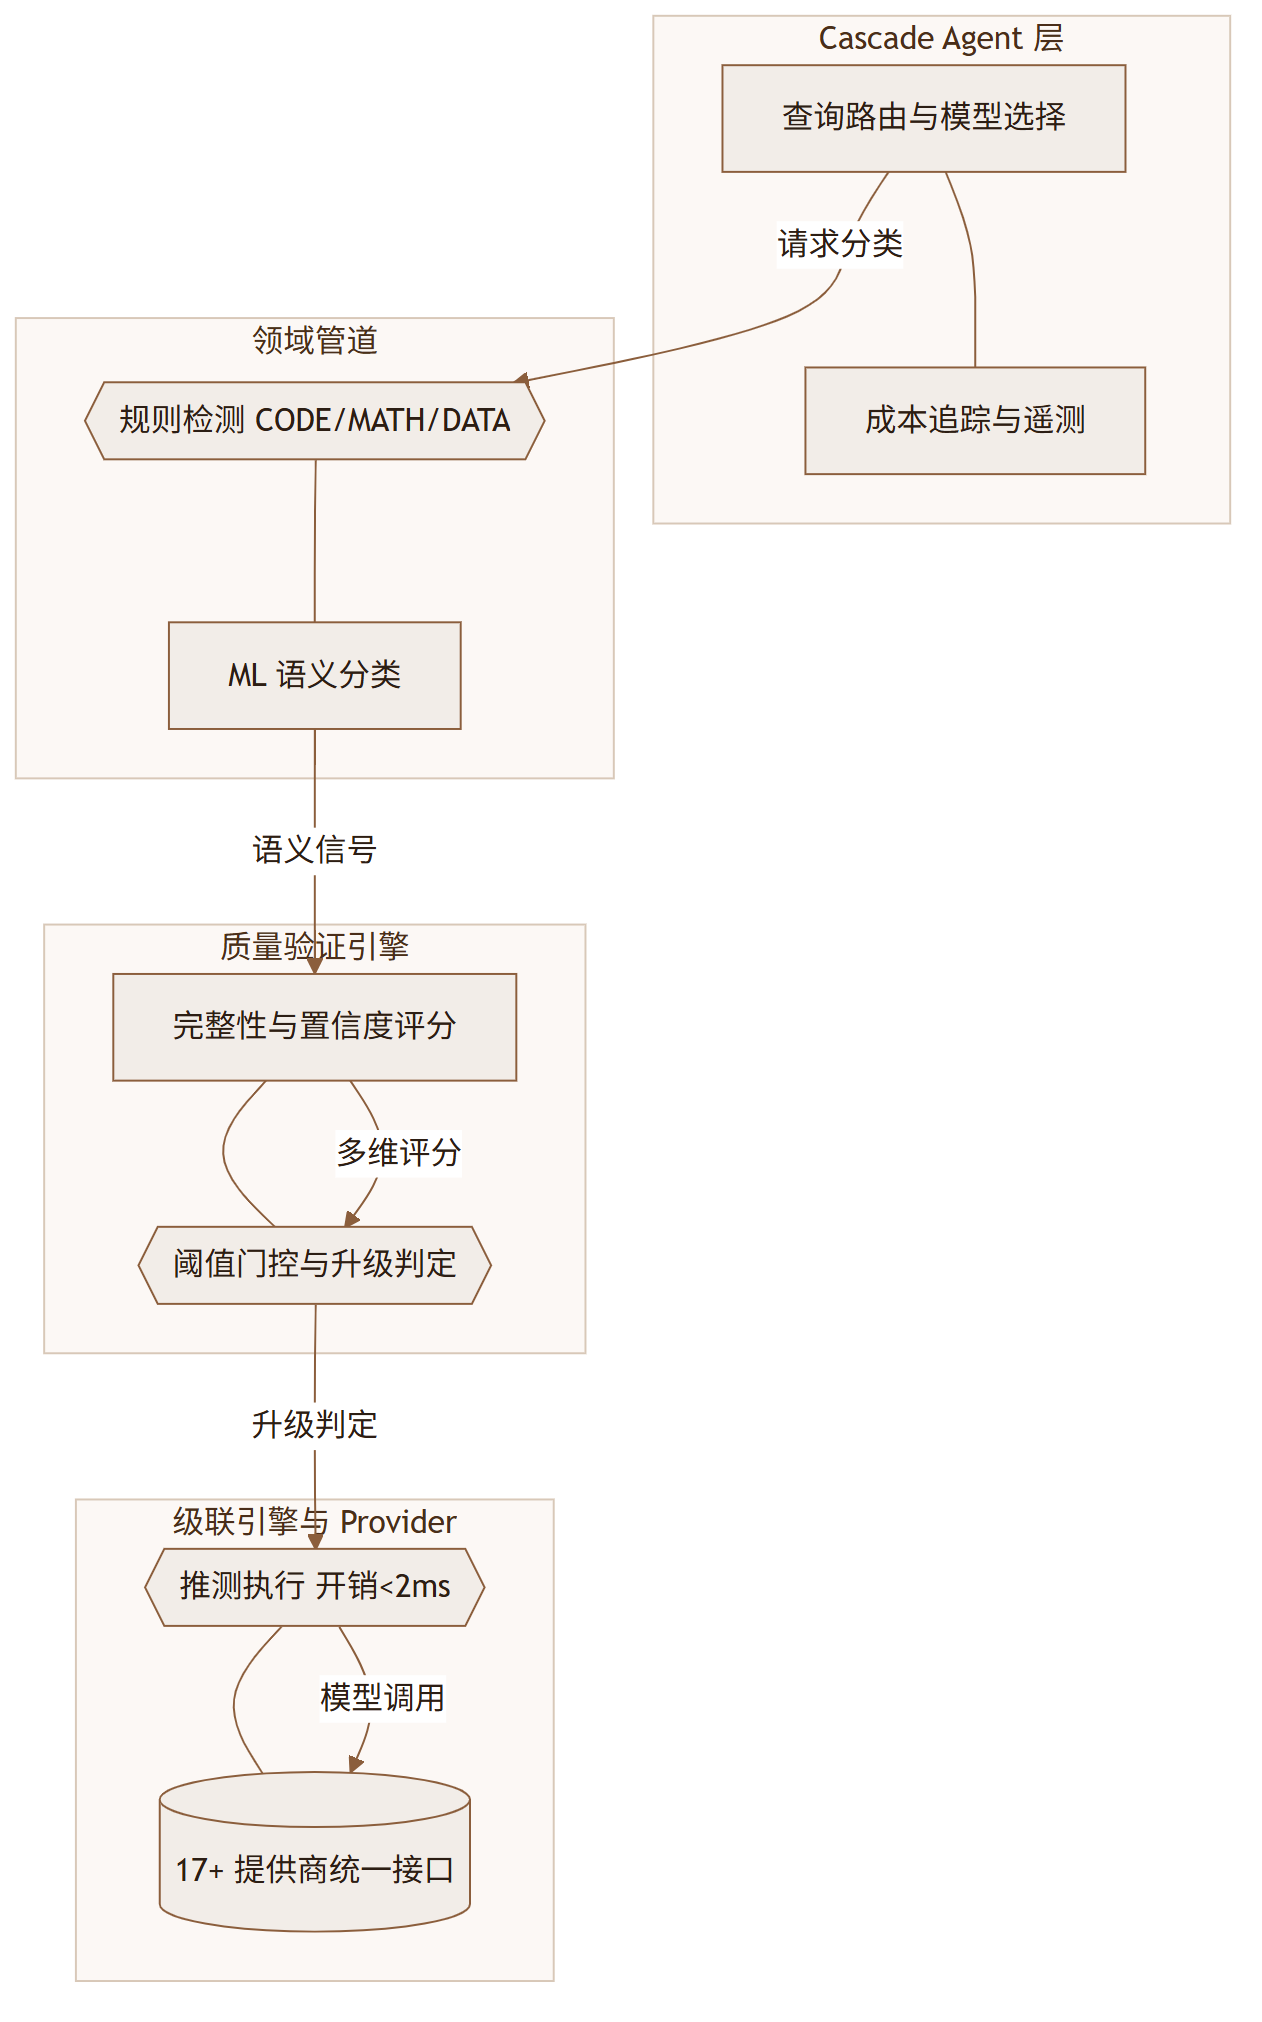
图上是一条清晰的自上而下链路:Agent 层做路由决策,领域管道和质量引擎提供判定信号,级联引擎以不到 2 毫秒的开销完成先便宜后升级,最底层的 Provider 抽象把 17 家以上的模型接口统一掉。问题也随之而来,这套结构里最脆的是哪一环?往下看。
跑起来看看
安装环节没有任何花样,Python 侧一条命令,TypeScript 侧同样一条命令,装完直接就能 import 使用。
pip install cascadeflow最小可运行示例也简单到离谱:两个 ModelConfig,一个便宜当草稿,一个贵当验证,CascadeAgent 自己会路由。
from cascadeflow import CascadeAgent, ModelConfig

agent = CascadeAgent(models=[
    ModelConfig(name="nous/hermes-flash", provider="openai", cost=0.000375),
    ModelConfig(name="gpt-5", provider="openai", cost=0.00562),
])

result = await agent.run("What's the capital of France?")
print(f"Answer: {result.content}")
print(f"Model used: {result.model_used}")
print(f"Cost: ${result.total_cost:.6f}")
不想改代码也能先看起来。observe 模式把现有 SDK 调用全部纳管,纯旁观,不影响任何现有逻辑。
import cascadeflow
cascadeflow.init(mode="observe")
要正式上策略就进 Tier 3,预算、合规、KPI 权重一个装饰器全部带走,不用散落到业务代码各处。
@cascadeflow.agent(budget=0.20, compliance="gdpr", kpi_weights={"quality": 0.6, "cost": 0.3, "latency": 0.1})
async def my_agent(query: str):
    return await llm.complete(query)
它最核心的推测执行加质量验证机制,可以拆成五步来看,每一步都有明确的职责边界。
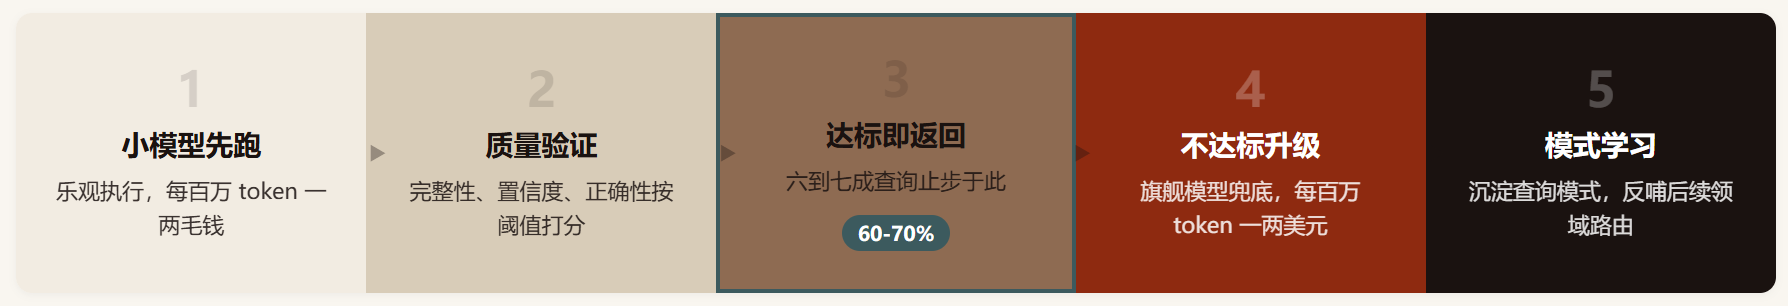
第一步小模型以每百万 token 一两毛钱的成本乐观执行,第二步质量引擎按阈值打分,第三步六到七成的查询在这里就返回了,只有第四步不达标才升级到每百万 token 一两美元的旗舰模型,第五步跑出来的模式反哺后续路由。README 里还有个直白的迁移对照:同样的活儿全量走 gpt-4o 是 113 微美元、850 毫秒,级联之后是 7 微美元、234 毫秒,成本降 94%,速度快 3.6 倍。官方口径,但账算到了明处。
官方首页还给了个 CLI 形态的运行样例,评分、动作、节省比例一目了然,很适合理解它的工作节奏。
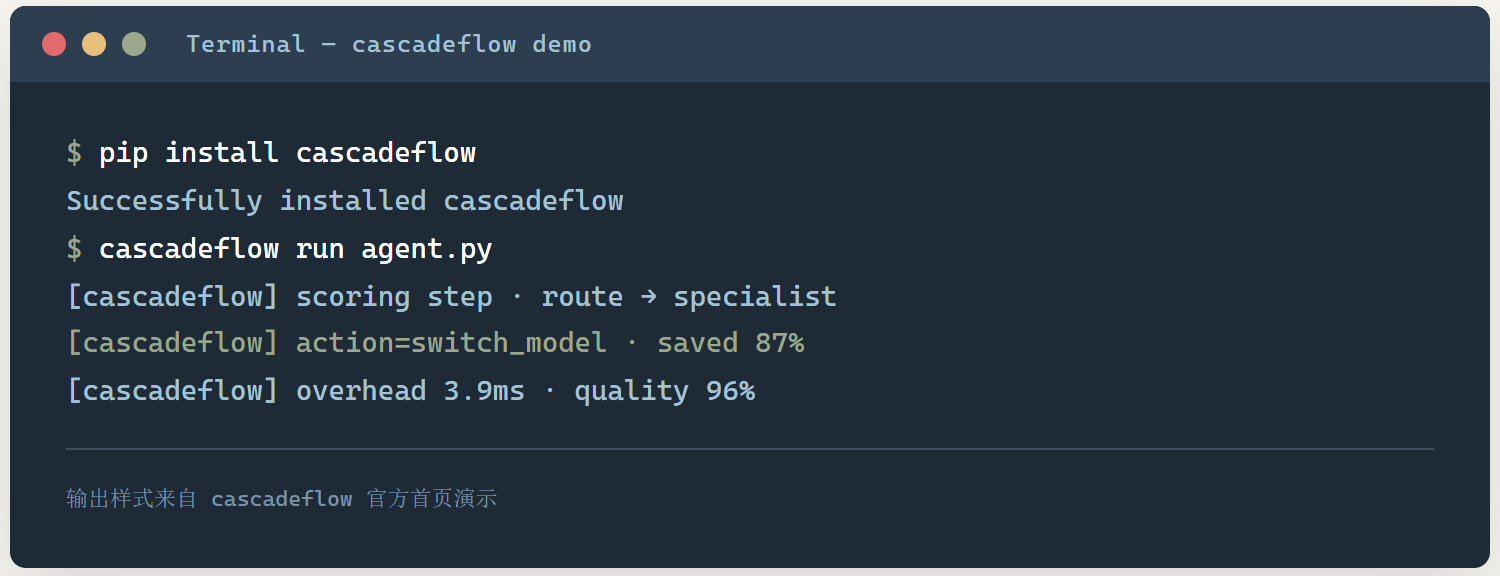
三行输出把它的工作节奏说全了:先给当前步骤打分并路由到 specialist,再执行 switch_model 动作并报告省了 87%,最后交代 3.9 毫秒开销和 96% 的质量保持。跑起来顺,不代表哪里都能用,它的边界在哪?
什么时候用,什么时候别用
按 README 的定位和实际机制,我把它的适用面拆成四类,大家对号入座就行,不用逐条背。
| 场景 | 典型用户 | 优势 | 局限 |
|---|---|---|---|
| 多步 Agent 工作流控成本 | Agent 应用团队 | 按步骤选模型,预算闸门 | 需要改造接入方式 |
| 边缘与本地优先部署 | 隐私敏感场景 | 本地模型扛大部分流量 | 语义验证要下 80MB 模型 |
| 成本审计与合规 | 企业平台团队 | 六维评分加决策轨迹 | 自述基准未经独立复核 |
| 单次简单问答 | 脚本用户 | 大材小用 | 引一层依赖不划算 |
局限要数清楚四条。第一,质量验证是启发式的,长度、置信度、格式、语义对齐,没有一项能真正证明答案正确,它降低的是期望不是风险。第二,加权门控有已知 bug,Issue #199 指出 schema 不合法甚至工具不存在的调用,在默认阈值下仍可能被判有效,那份报告有源码有表格,写得非常扎实,至今没合。第三,所有基准都是项目自述,公开渠道找不到独立复核。第四,语义验证要拉一个约 80MB 的 FastEmbed 模型,冷启动有感知。
还有一个结构性的顾虑,这是 open-core 项目。Studio 是商业托管版,提供可视化 Policy Builder 和自定义评分维度,自优化这个最诱人的能力放在收费版里。核心功能留在开源侧不假,但用开源版的团队,阈值得自己调,对预算敏感的团队这一点直接影响选型。
话说回来,这些坑都建立在一个前提上:项目本身得活着,社区得靠得住。看看社区。
社区怎么样了
社区健康度我们先看一张速览表,所有数据均截至 2026 年 10 月,全文口径保持统一。
| 指标 | 数值 |
|---|---|
| Stars | 3944 |
| Forks | 885 |
| Issue 总数 | 4,其中 3 个未关闭 |
| 贡献者 | 6 人 |
| 最近 Release | v1.2.0,2026 年 4 月 2 日 |
| 最近提交 | 2026 年 9 月 25 日 |
| 协议 | MIT |
Bus Factor 这块基本没有悬念。6 个贡献者里,主维护者 saschabuehrle 一个人提交了 488 次,其余 5 人合计 13 次。这就是一个单人项目套了层社区外壳。好处是决策快、品味一致,坏处是人一撤项目就停摆。
Release 节奏更值得玩味。v1.0.0 在今年 2 月,v1.1.0 在 3 月,v1.2.0 在 4 月,之后 5 个月只有 commit 没有版本号,9 月 25 日最后三条提交全是 npm publish 修复。工程节奏明显在放缓,要么在憋大的,要么精力挪去了别处。对采用者来说,这意味着新功能交付的节奏不可预测。
社区声音要诚实地说。我翻了媒体报道、HN 和 Reddit,没找到有代表性的技术讨论串,中文和英文报道基本是 2025 年 11 月那波新闻稿的多语言转发。Issue 区唯一的亮点是 #199 那份加权门控 bug 报告,分析得比很多商业项目的工单都专业。整体属于:文档和 CI 很光鲜,真实用户声音稀薄。
数据都看完了,好坏都摆在了台面上,接下来的判断全写在下面这一章里头。
我的真实看法
先定位。同类工具里,LiteLLM 和 OpenRouter 在 HTTP 边界做统一网关,RouteLLM 是学术界的路由训练框架,NotDiamond 和 Martian 走商业路由 API。cascadeflow 的独特位置是,唯一一个开源的、跑在 Agent 进程内的治理层。这些替代方案各有各的地盘,但循环内决策这个生态位,目前只有它一个。路由做在请求外面还是进程里面,这个分野决定了各自的天花板。
我的判断分两半。架构判断是值得跟,in-process 这个切入点是对的,三层接入路径也是对的,先 observe 再 run 再 agent,任何团队都能无痛灰度。工程判断要谨慎,97% 的提交来自一个人,release 停更 5 个月,自述基准没有第三方复核,上生产前你得自己验证一遍。
坑里我最在意的是质量门控。加权平均的设计意味着任何单一验证维度失效,都可能被其他维度稀释过去,Issue #199 就是活证据。拿它管工具调用的团队,建议把 schema_valid 和 tool_exists 设成硬前置,别只调阈值了事。
趋势上我倾向于热度在,势能在降。3944 stars、22% 的 fork 率说明很多人真的拿去改了;但 commit 放缓加 release 停滞,配合商业版的存在,更像是公司在把重心往 Studio 挪。开源版不会死,但别指望它按社区节奏演化。
所以谁该用?正在搭多步 Agent、账单开始疼、又不想把流量甩给第三方网关的团队,值得接进去 observe 两周,让数据说话。单次问答脚本、强正确性要求的场景,现在别碰。
说它好用的和说它噱头的,其实都没说到点子上。它把对的事做了,把难的事留给了你。
资源地址
| 资源 | 地址 |
|---|---|
| GitHub | https://github.com/lemony-ai/cascadeflow |
| 官方文档 | https://docs.cascadeflow.ai |
| PyPI | pip install cascadeflow |
| npm | @cascadeflow/core |
| 公司官网 | https://www.lemony.ai |
| 社区讨论 | https://github.com/lemony-ai/cascadeflow/discussions |
资源地址都整理在这张表里了,剩下的篇幅已经不多,该看我们怎么收尾了。
值得跟,但把预期放对位置
总结三句。cascadeflow 抓的生态位是真的,Agent 循环内的成本与策略治理,开源独一份;它的工程品味在线,三层接入、六维评分、决策可归因,都是干过活的人做出来的设计。
但它是单人项目加商业公司的组合,bus factor 是 1,基准是自述的,门控是有已知 bug 的。我的建议是接进 observe 模式跑两周,用自己的流量验证那四到八点五成能省多少,再决定要不要往下走。
说到底,省钱这件事最后得靠自己账单上的数字去验证,而不是别人 README 里写下的结论。