
前几篇拆过 OpenAI 在 Smithery 上放出的几个小技能,都是几百行脚本配一份契约文档的路子。这次点开
openai/cloudflare-deploy,第一反应是尺寸不对。一份七百三十多词的 SKILL.md,背后挂着六十来个参考目录,比例失衡得有点离谱。
Cloudflare 的产品线是出了名的散。光”运行代码”这一个需求,无服务器函数就有 Workers 和 Pages 两套解法,再往下还有 Durable Objects、Containers 和 Workflows 三种没有直接对应的形态。存储侧的选项同样是一长串,从最简单的键值对一直排到向量检索,每个坑位都有人占着。开发者在这张网里选错产品,代价不是多花两小时,是整个架构要返工。
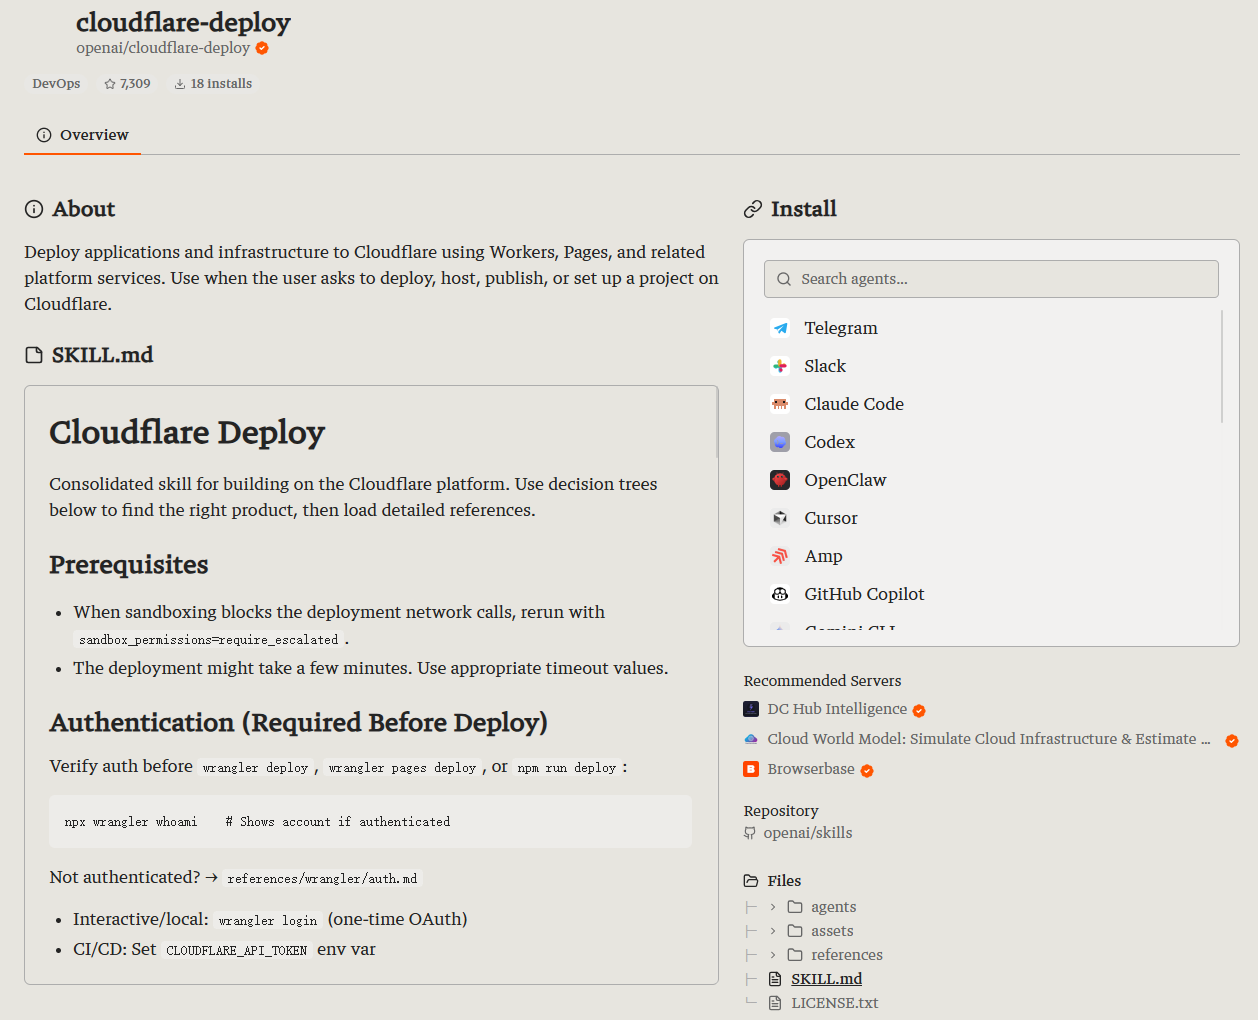
多数技能文档的解法是”把事情讲清楚”,于是文档越写越长。这个技能走了反路。它不讲实现,只讲”你要的到底是哪一类需求”,然后把细节全推给 references/ 按需加载。SKILL.md 里最重的资产不是任何一段脚本,是七棵决策树。
我的判断是,这个技能真正的产物不是”能部署到 Cloudflare”,而是把 Cloudflare 的选型知识做成了可路由的索引。它跟前几个技能的差别,恰好是”原子技能”和”路由技能”的差别。这件事比部署本身更值得拆。
架构解析
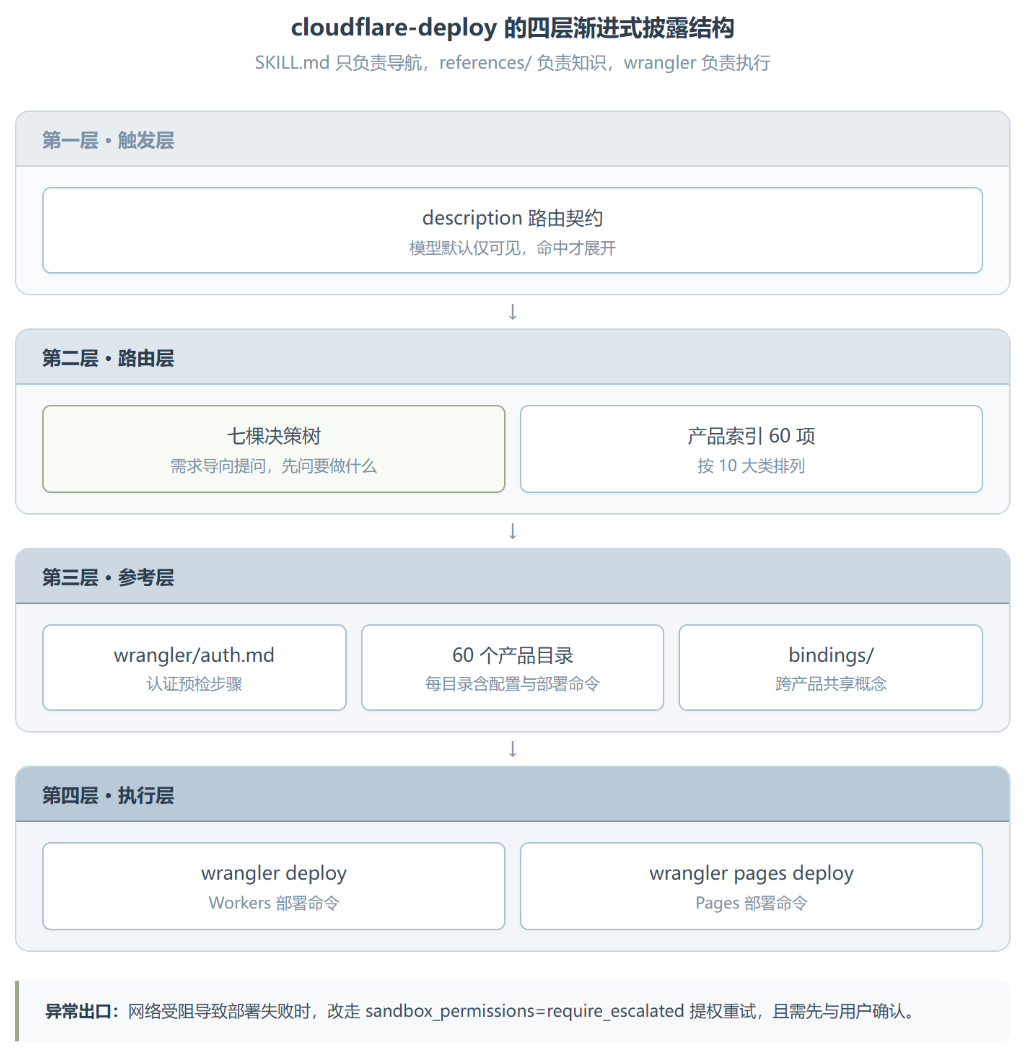
整个技能是四层。最上面是 frontmatter 里那句 description,模型平时只看得到它。命中了才展开正文的决策树,决策树把模糊需求收敛到一个产品目录,目录里的 references/ 才是真正的操作手册。任何一层没命中,都不会加载下一层。
决策树设计里最见功力的一点,是它的问法。第一问不是”你要用 Workers 还是 Pages”,而是”你需要运行代码吗”。这个顺序要是反了,产品导向会把选型负担重新丢回给模型,等于白做。
七棵树的问法全部是需求导向,没有一棵以产品名开头:
- 我需要运行代码吗
- 我需要存储数据吗
- 我需要 AI/ML 吗
- 我需要网络连接吗
- 我需要安全吗
- 我需要媒体内容吗
- 我需要基础设施即代码吗
最后一棵只占一行。每棵树的叶子都是一个目录名,看其中某一行的写法,运行容器 → containers/,连半句解释都不给,克制得近乎粗暴。
这些树要解决的是一个很具体的问题:Cloudflare 的产品边界互相重叠。同样是”实时”,Durable Objects 和 Realtime SFU 都能碰;同样是”数据库”,D1 是自带的 SQLite,Hyperdrive 是接外部 Postgres。文档不替你判定,树替你判定。
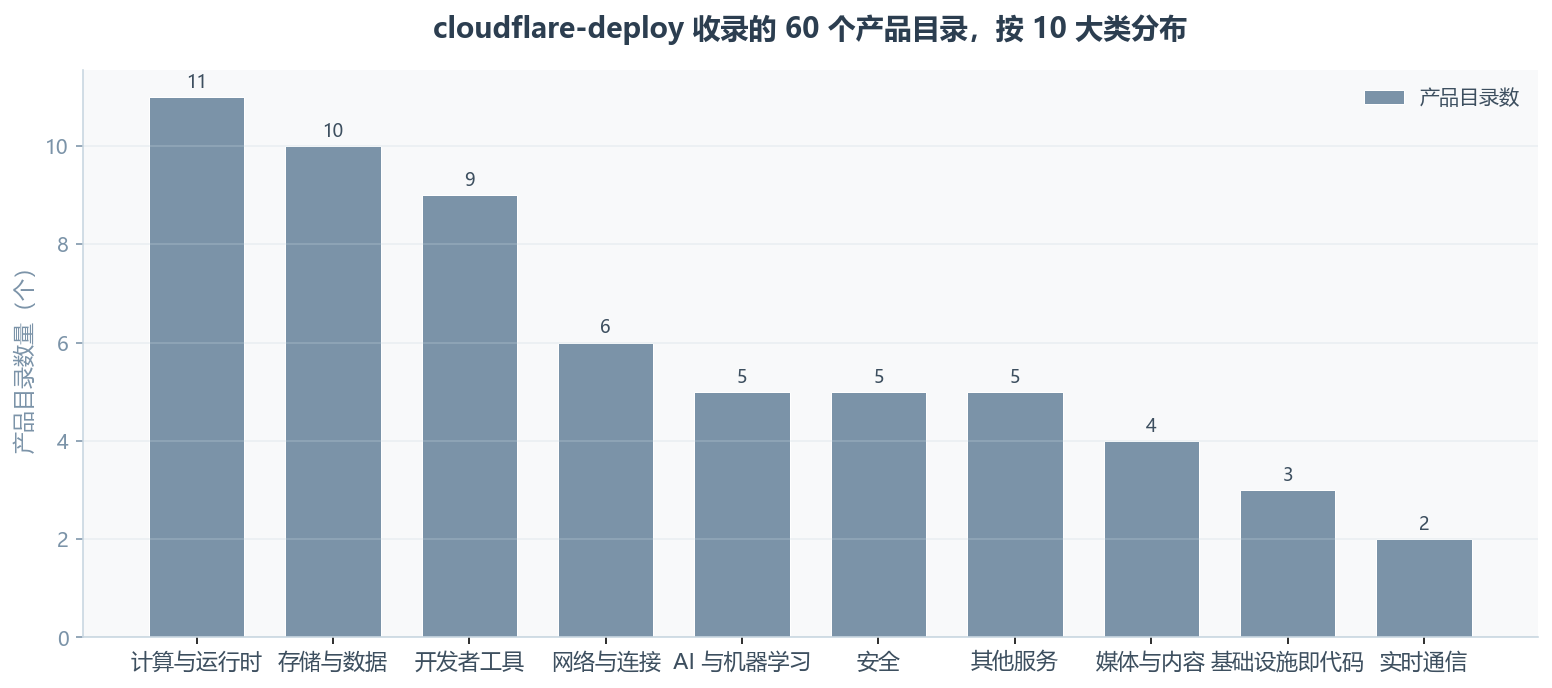
索引部分把六十个产品按十个大类排成表。值得一提的细节是索引和决策树并不重复。树回答”我该用哪个”,索引回答”这个产品叫什么、文档在哪”。两套导航一个管选型,一个管查找,各司其职。
工作流分析
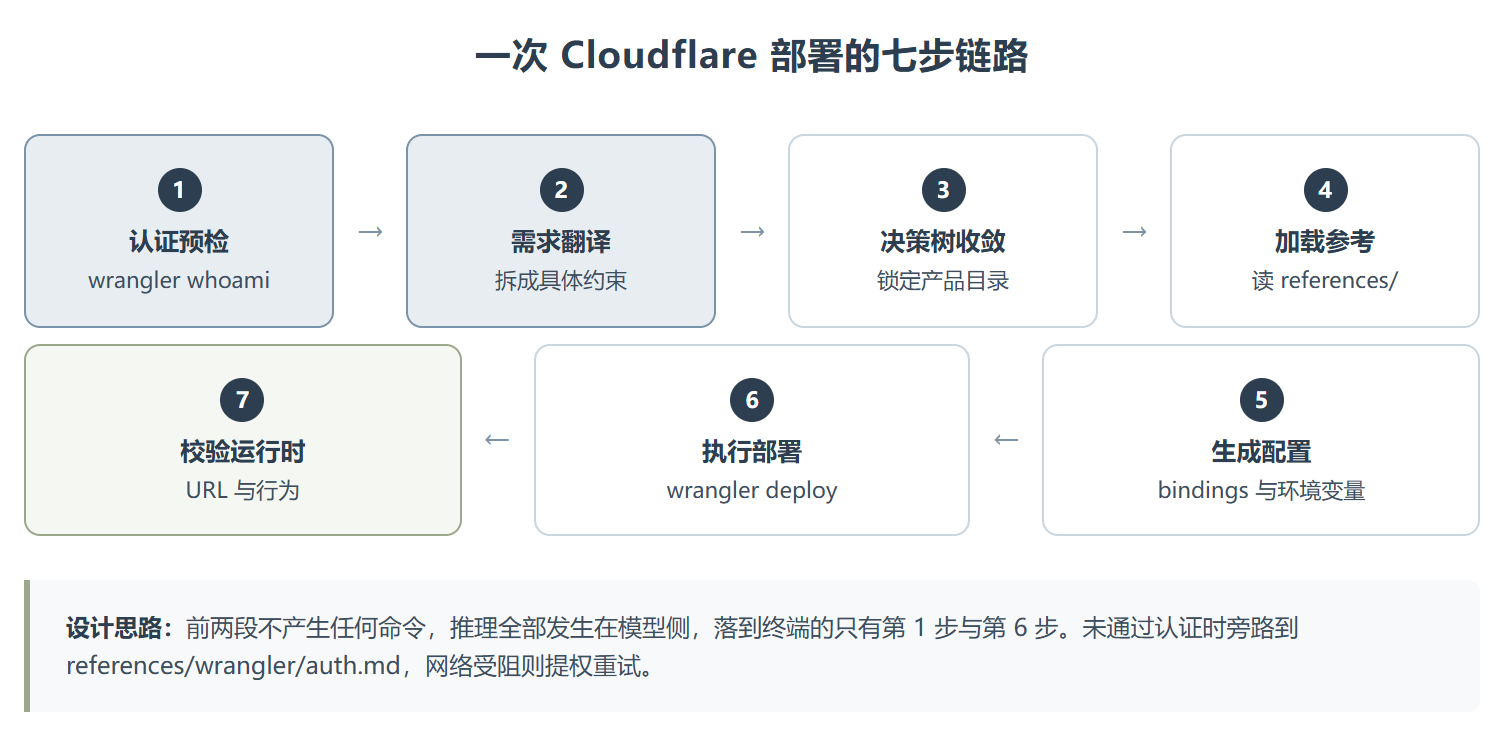
一次部署的链路大致分四段。最前面是认证预检和产品选型,中间一段加载参考,最后一段才真正执行落地。前两段几乎不产生任何命令,全是模型在推理;落到终端的只有头尾两段。这个重心分布挺反直觉的,因为日常经验里”部署”是个纯操作问题。
认证预检是硬门禁,写在正文最前面。原文的要求很直接:跑 wrangler deploy、wrangler pages deploy 或者 npm run deploy 之前,先验证身份。理由不难理解,这四个命令失败时的报错长得很像,认证过期和配置错误经常混在一起,先过一道 whoami 能把一半的排查成本砍掉。
npx wrangler whoami              # 已认证则回显账号信息
wrangler login                   # 本地/交互式,一次性 OAuth
export CLOUDFLARE_API_TOKEN=...  # CI/CD 场景
选型段完全在模型侧完成。它要做的判断是把用户那句”帮我把这个 Next.js 应用发上去”翻译成一串具体约束:
- 要不要 API routes
- 有没有数据库
- 需不需要定时任务
- 是不是多租户
这些约束齐了,决策树才有得走。这一步没做好,后面全是猜。
执行段的产物回归 wrangler。技能本身不封装任何部署 wrapper,不定义自己的命令,也不做二次抽象,就是把 wrangler 的原始用法交出去。这个选择有代价,模型得吃下 wrangler 全部的参数细节;好处也很明显,Cloudflare 官方文档更新了,技能不会过期。
最后一段是技能里唯一带”异常分支”的地方。部署可能因网络被阻断而失败,表现为超时、DNS 错误或连接重置。技能的处置不是重试,是提权:用 sandbox_permissions=require_escalated 重跑,并要求模型先用一句话跟用户确认再动。
使用场景
最常见的场景是把一个已有应用迁上去,而选型权不在开发者手上。用户说”部署这个 Next.js 应用,别弄丢 API routes”,技能要做的是从 pages 和 workers 两条路里选一条,再判断 API routes 该落到 Pages Functions 还是独立的 Worker。这种判断人工也能做,但每次都要重新查一遍两边的边界。
第二种是 CI/CD。技能明确给了无交互的认证路径,就是环境变量 CLOUDFLARE_API_TOKEN。这一步看起来像常识,实际是最容易踩的坑,很多人在本地 wrangler login 通了就以为 CI 也通,结果流水线卡在 OAuth 浏览器弹窗上。
边界得说清楚。这个技能不安装任何依赖,不定义工具权限,也不替你判断该不该上 Cloudflare。它假定环境里已经有 wrangler 和有效凭据。如果你连账号都没有,它帮不上任何忙,只会告诉你先跑 wrangler login。
还有一条容易被忽略的约束:部署是慢操作。技能在正文里提醒要用合适的超时值,意思是别用默认的短超时去卡一个要跑几分钟的 wrangler。这条提醒很朴素,但它出现的频率比想象中高。
洞察与反思
这个技能最反常识的地方,是它对”原子技能”教条的背叛。过去一年 Agent Skills 圈的主流建议是拆,一个技能只干一件事,边界越窄触发越准。cloudflare-deploy 反着来,把六十个产品塞进一个技能,还活得挺好。
道理其实站得住。拆的前提是”每件事能独立判定什么时候该用”。可 Cloudflare 的产品选型恰恰是一个整体判断:你不先确定要 Workers 还是要 Pages,就没法判断该加载哪份文档。这种情况下拆成六十个技能,模型面临的第一个问题会变成”该触发哪一个”,难度原封不动地转移了。
另一个值得记下来的姿态是权限。这份技能没有声明任何 allowed-tools,也就是说它不为自己申请任何额外权限,跑什么都在宿主 Agent 的常规权限模型下走。相比之下,前面拆过的 examples-auto-run 会一次性打开 shell、补丁和 MCP 三处自动批准。同样是 OpenAI 出的技能,风险偏好差得很远。
部署技能是一个家族。仓库里并排放着三份同族技能,Vercel、Netlify 和 Render 各占一个,正文结构高度一致,连提权和超时那两段话都几乎照抄。有一道提交信息显示,三家平台的人是各自贡献的。平台方自己来写部署技能,这比任何生态宣传都有说服力。
最后一个信号不太妙但必须提。openai/skills 这个仓库在 2026 年 6 月被标记为废弃,官方把技能和插件的例子迁去了 openai/plugins。也就是说你在 Smithery 上看到的这份快照,对应的上游已经挪窝了。技能内容短期内不会失效,但想跟进更新得换地址。
资源地址
| 资源 | 链接 |
|---|---|
| Smithery 技能页 | https://smithery.ai/skills/openai/cloudflare-deploy |
| 上游仓库(已废弃) | https://github.com/openai/skills |
| 技能目录 | skills/.curated/cloudflare-deploy |
| 现行仓库 | https://github.com/openai/plugins |
| Agent Skills 规范 | https://agentskills.io |
| Cloudflare 官方文档 | https://developers.cloudflare.com |
总结
把它当成一个部署工具看,格局小了。它真正做的是把一份庞大到无法通读的产品体系,压成七棵能走完的决策树,再靠目录结构把细节挪到需要的时候才加载。SKILL.md 只负责导航,references/ 负责知识,wrangler 负责执行,三层谁也不越界。
它适合什么场合?适合目标平台产品面宽、选型本身就是主要难度、且用户常常描述不清楚自己要什么的场景。反过来说,如果你的平台只有一种部署方式,做这样一份路由表纯属浪费,一句命令就够了。
我更愿意从它身上抄走的是那条判断标准:当一个技能要覆盖的选项超过十个,问题就不再是”怎么把文档写全”,而是”怎么让模型在需要的时候才读到那一段”。开源仓库那边 Skill 已经演进到几百上千个。这个方向上的下一次迭代,很可能就是下一代技能框架的默认形状。