
Agent 回答 API 问题最典型的翻车方式不是答错,是答得特别流畅。参数名、必填字段、默认值全都编得像真的,你照着改半天才发现在某个版本早就变了。模型的记忆是一张快照,OpenAI 的接口是按周在动的,这两个时间尺度对不上,出错是必然的。
OpenAI 自己放了个 skill 专门治这件事,叫 openai-docs,位置在 openai/skills 仓库的 curated 目录下。名字看着像个文档搬运工,真正读进去才会发现它不是查询封装,而是一份来源路由协议。
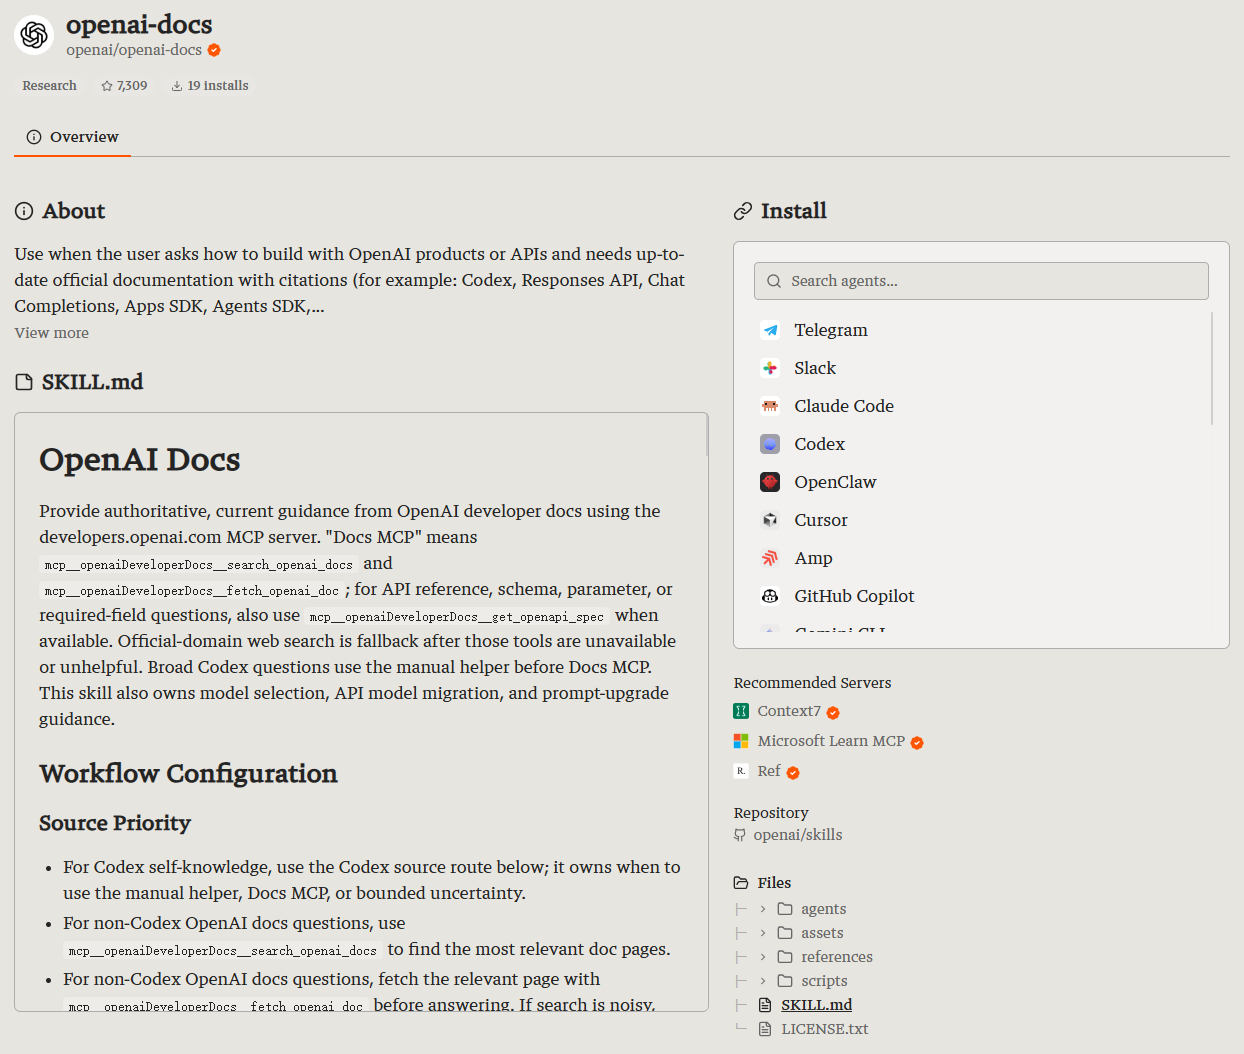
它的成本结构也挺讲究。整包 9 个文件 67 KB,但常驻加载的只有 frontmatter 里的 name 和 description,大约 115 token。剩下 17.9 KB 的 SKILL.md 和四份引用文件全部按需展开。它不指望自己随时待命,它指望被唤醒的那一次把来源选对。
这篇按架构样本拆它,主要看四件事:
- 来源怎么分车道
- Codex 自知识为什么单独走一条路
- MCP 断了怎么自愈
- 它给模型留的那个承认不知道的出口
架构解析
问题进来之后,这个 skill 做的第一件事不是搜索,是分类。它要先判断这属于哪一类:Codex 自身的配置与行为、模型选型与迁移、还是通用 API 文档查询。三条路差别极大,分错的代价比不查还高。
分类完才是来源分流。通用文档走 OpenAI Docs MCP,可用工具就三个:
mcp__openaiDeveloperDocs__search_openai_docs   # 检索最相关的文档页
mcp__openaiDeveloperDocs__fetch_openai_doc     # 拉取指定页的精确段落
mcp__openaiDeveloperDocs__get_openapi_spec     # 核对 schema 与必填字段
这三者分工不同。search 负责定位,fetch 负责取原文,get_openapi_spec 只在参数与必填字段这类契约问题上做交叉验证。另有一个 list_openai_docs,文档给它加了 only when 的限定,只在没有明确查询词、纯浏览发现时才准用。
值得留意的是它对检索质量的容忍度。search 结果噪音大不算换车道的理由,正确动作是收窄 query 再搜一次;已经知道一个官方 URL,就该用 fetch 走 MCP 而不是去开网页。同一车道内部的失败,只能用同车道的参数调整解决,不许提前跳车。
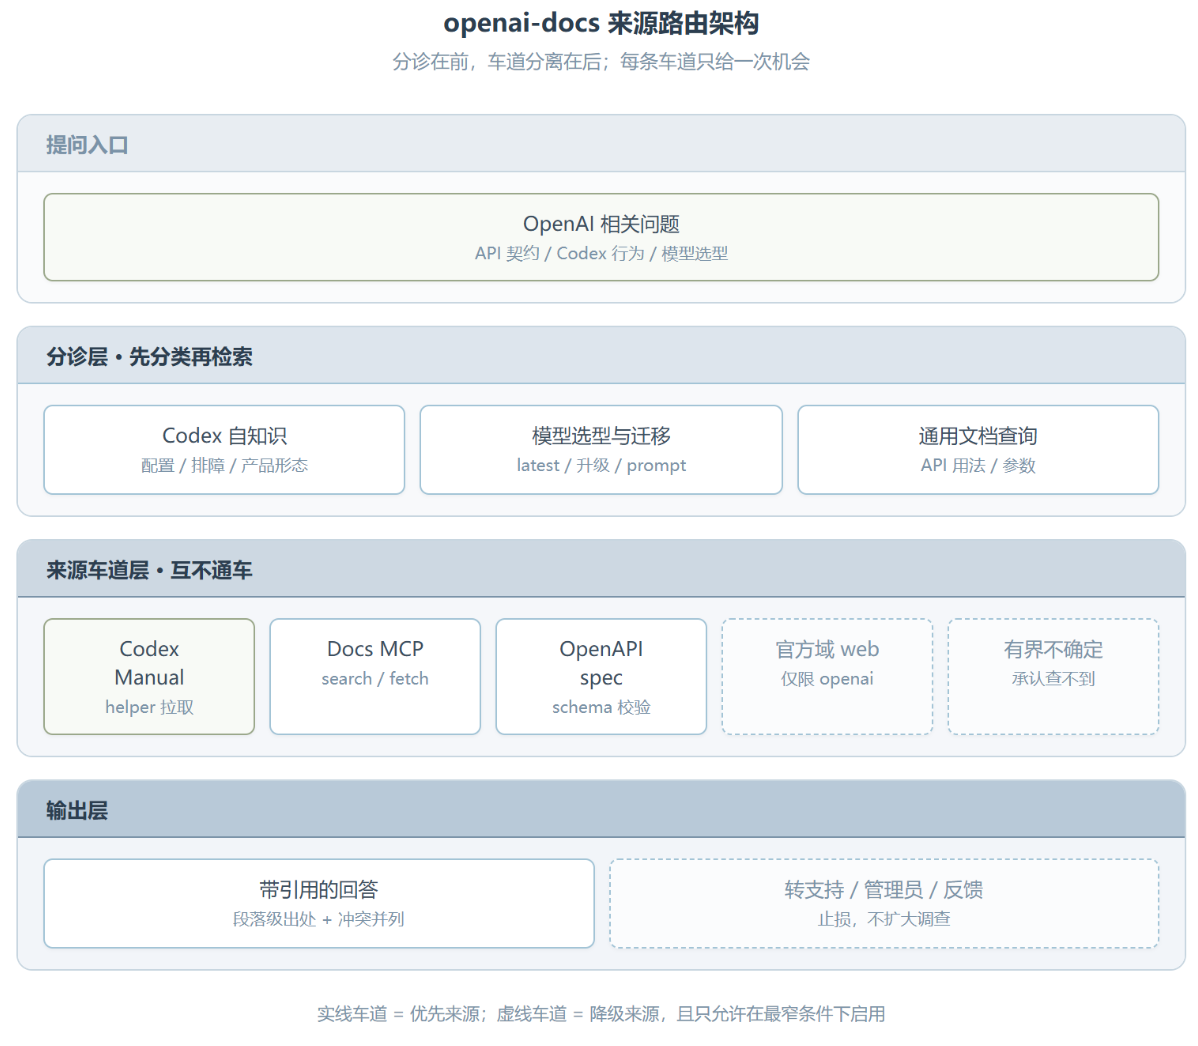
输出端也有约束。回答必须带引用,代码片段只在文档支持它的时候才给,多个页面冲突要两边都引并说明差异。这几条看着像写作规范,实际是在切掉模型最擅长的动作:把三个不同版本的信息缝成一段听起来统一的答案。
工作流分析
最长的分支是 Codex 自知识,也是这份 skill 里设计密度最高的地方。它先用一句话把边界钉死:只有问题本身就是关于 Codex 的,比如配置、排障、本地状态这些,才走这条路。代码库里提到了某个 plugin 或 hook,不算理由。
这条路的第一来源是 Codex manual,靠一个 15.7 KB 的 Node 脚本拉取:
node <skill-dir>/scripts/fetch-codex-manual.mjshelper 干三件事:校验新鲜度、写出 codex-manual.md、再生成一份 codex-manual.outline.md。outline 把源页面和各级标题映射到行号区间,模型据此定位到具体章节再精确读取。先拿目录再取章节,比把一整份大文档塞进上下文省得多。
缓存这块藏着最多运行时假设。默认目录按五个候选依次探测,它们指向同一个 openai-docs-cache 子目录:
$TMPDIR/openai-docs-cache
%TEMP%\openai-docs-cache
%TMP%\openai-docs-cache
/private/tmp/openai-docs-cache
/tmp/openai-docs-cache
文档还补了一句很容易被忽略的:只有 workspace 的写权限是不够的,必须有真正的临时目录可用。
新鲜度也有明确阈值,重取条件被写成四条:
- manual 抓取时间超过大约一天
- 路径不可用,或来自另一个线程
- 来源不确定,说不清是哪一次拉取的
- 明显缺少当下需要的信息
命中任意一条就该刷新,而不是靠感觉判断要不要重跑一次。这条规定让那份缓存从一次性产物变成了有生命周期的资源。
降级条件被收得很窄,只有五种情况允许离开 manual:
- manual 本身不可用
- helper 真的跑失败(猜的不算)
- 不允许使用临时缓存
- 关键论断缺失,或大概率已经过期
- 用户明确要求页面级引用
而且明令禁止猜。猜沙箱、猜 helper 会失败,都不构成跳车的理由。
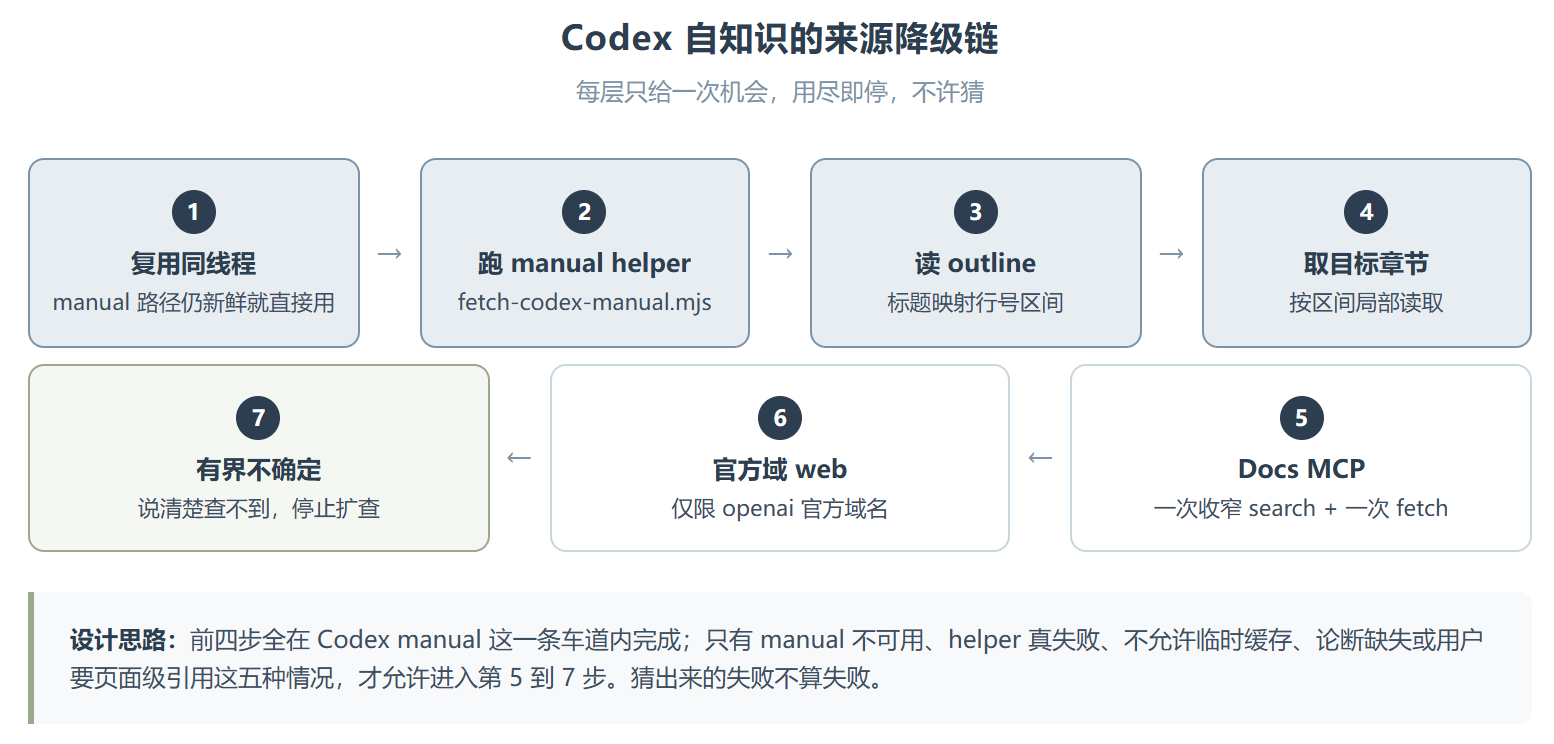
离开 manual 之后首先是 Docs MCP,一次收窄的 search 加一次 fetch;还不行才轮到限制在官方域的 web 搜索;再不行就停在 bounded uncertainty。整条链每一步只给一次机会,这是刻意的,防止模型在检索里无限打转。
使用场景
第二个高频场景是新模型发布后把旧集成升上去,这里的约束是最狠的。先查最新模型,fetch 官方那份 latest-model 指南,拿不到才读本地那份 references/latest-model.md,而且必须声明用了回落内容。
有个规则容易被忽略:只有目标写成 latest、current、default 或者压根没指定时,才去跑 resolve-latest-model-info.js。用户点名要迁到某个版本,就必须保留用户点名的目标,更新的模型只能作为可选提示提一句。这条挡的是模型自作主张,把人锁定的版本顶掉。
升级动作被压缩到只允许两件事:改模型字符串,改与这个模型直接绑定的 prompt。所有顺手能做的动作都进了禁区:
- 把 Chat Completions 迁到 Responses
- 换 SDK,或迁移到别的 provider
- 改参数形状与 tool 定义
- 改结构化输出的接线
需要动到上面任何一处,就标 blocked,不硬做。
判定结局只有三种:
- model string only:源模型是 5.4 系列、prompt 已经短而明确、没有严格输出格式依赖
- model string + light prompt rewrite:需要补引用纪律、工具预算、停止条件、验证步骤,但 API 面不动
- blocked:需要动参数、tool 定义、schema 契约、provider 迁移或实现代码
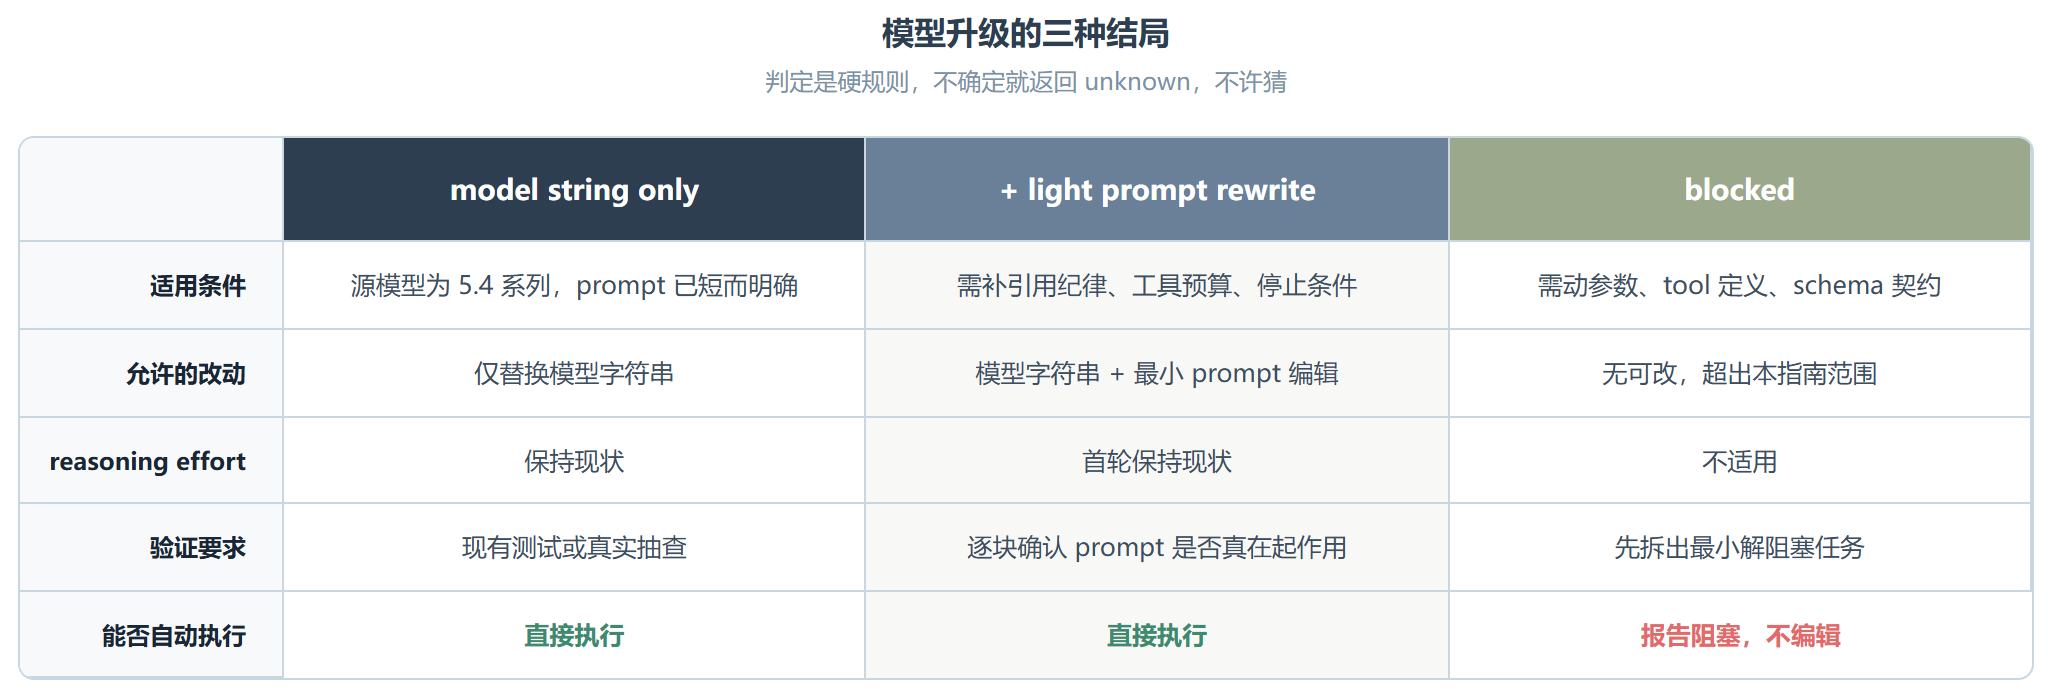
兼容性检查一共八条,判定规则写得很硬。宿主能不能直接吃下新模型字符串而不改客户端代码,这一条为否就直接 blocked;prompt 是否可识别可编辑这一条为否就返回 unknown,不许猜。文档反复强调一句:工具、agent 或多处调用点本身不构成阻塞,阻塞只留给真正需要改实现的情况。
还有一句我个人很欣赏的写法。文档说,如果安全迁移需要动上面任何一个地方,就标记 blocked 并说明这超出本指南范围,别为了把任务完成而糊过去。紧跟着补了一句,没有任务级验证就不要宣称省了 token。在一个普遍爱报喜的领域里,这种句子不多见。
洞察与反思
最值得抄的是车道不能混这一条。大多数查文档类工具把手册、MCP、网页搜索当成一个来源池,谁先返回用谁,结果是权威来源和二手转述混在一起,引用链断在半路。这份 skill 反复强调 manual 和 Docs MCP 是两条不同的车道,不可互换,这是它和普通检索封装的分水岭。
第二条是给不知道留了合法出口。bounded uncertainty 是这条链的正式终点,文档写得很直白:来源用尽还不能确立某个论断,就返回有界不确定,或者转给支持、管理员、产品反馈,而不是继续扩大调查范围。Agent 的默认性格是再查查总能查到,这个 skill 反过来给它划了止损线。
第三条是 Surface Map 那块。当那些配置名词互相重叠时,它按 scope 选最小的那个面:
- 当前 prompt 或线程 → 一次性任务约束
- AGENTS.md → 仓库级持久约定
- 项目 .codex/config.toml → 受信仓库的设置
- 全局配置 → 跨仓库的个人默认
- Skill 与 Plugin → 可复用工作流、可安装包
- MCP 或连接器 → 实时外部数据与授权应用
混合场景还专门给了拆法。always do X but only for this PR 这类请求默认只进当前对话上下文,要持久才写进 AGENTS.md,要机制强制才上 hook。多数 agent 平台的做法是让用户在一个巨大配置面里自己挑,这份反过来做更实际。
局限也清楚。helper 依赖临时目录写权限,read-only 会话里整条 Codex 自知识链路会让位给 Docs MCP,而 Docs MCP 对 Codex 自知识的覆盖本来就薄。三份 bundled references 自己承认会漂移,只靠一句 docs 赢来兜底,更新完全依赖上游重新打包,用户看不到版本号。helper 拉的是单一数据源,万一那份 manual 本身有误,车道再清晰也拦不住。
资源地址
| 资源 | 地址 |
|---|---|
| Smithery 页面 | https://smithery.ai/skills/openai/openai-docs |
| openai/skills 仓库 | https://github.com/openai/skills |
| Skill 源文件目录 | https://github.com/openai/skills/tree/main/skills/.curated/openai-docs |
| OpenAI Docs MCP 端点 | https://developers.openai.com/mcp |
| OpenAI 开发者文档 | https://developers.openai.com |
总结
这份 skill 的核心特征是把查文档从一个动作降级成一份协议。触发器写进常驻的 frontmatter,来源分成互不通车的几条路,每一层只给一次机会,越界就停手,查不出来就承认查不出来。
它适合需要引用出处、经常碰 API 契约、还要做模型迁移的团队。如果你只是想让它随便聊聊 OpenAI 的用法,那些问题交给普通搜索更省事,这套路由反而增加了开销。
值得盯的下一步是它能不能脱离 Codex 独立存在。脚本名、缓存目录候选、codex mcp add 这些细节都在往 Codex 上绑,helper 也只有一份 Codex manual 作为数据源。如果这套车道设计能被抽成平台无关的路由层,它对整个 agent 文档生态的价值会比现在大一个量级。