
改完一堆代码,你跟 Agent 说帮我提交一下再开个 PR。它回你一句已提交,你打开 GitHub 才发现分支直接建在了 main 上,commit message 写成 update files,PR 描述是把 diff 原样复述一遍,而这已经是同一天里它开的第三个 PR。
问题不在模型能力。你给的是一个意图,中间那串状态判断全靠它猜,猜错一步整条链路就歪了。openai/skills 这个仓库里有个叫 yeet 的 Skill 专门治这个,思路很朴素:把从 stage 到开 PR 这条链路切成一串带门禁的步骤,每步先探测环境状态再决定动作,最后压进一个 6.8KB 的 SKILL.md。
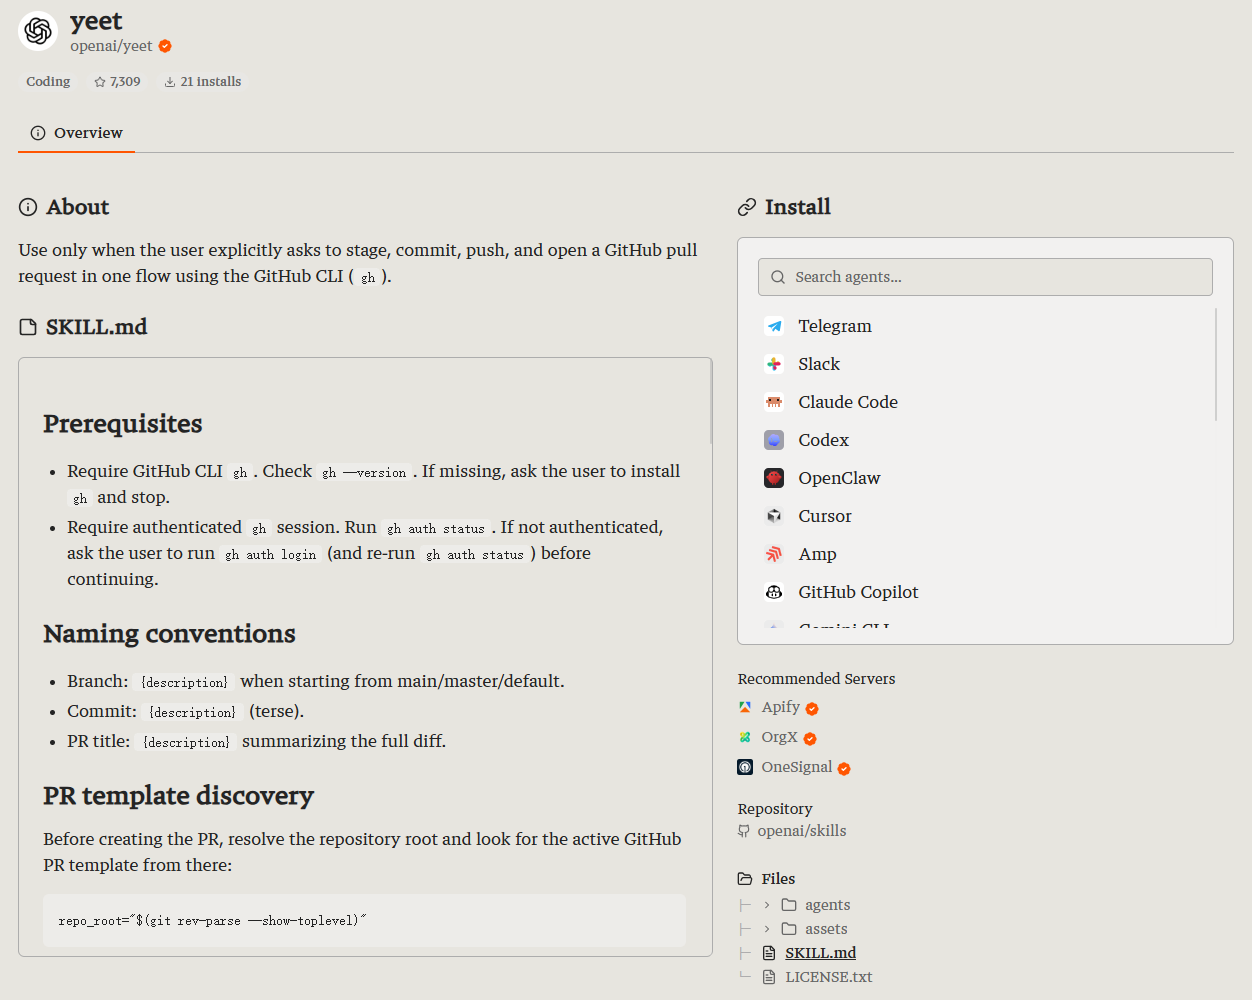
它的 description 写得异常克制,只有一句:仅在用户明确要求用 GitHub CLI 一次性完成 stage、commit、push 并开 PR 时使用。这句话我读了两遍才反应过来它在防什么,防的是 Agent 自作主张。多数同类 Prompt 会写成当用户完成代码改动时自动提交,一字之差,一个是工具,一个是定时炸弹。
这份文档的身份也值得说一句。它不是社区里写着玩的 Prompt 玩具,是 OpenAI 放在 openai/skills 仓库 curated 目录里的官方技能,跟着 commit 记录一起演进。你能看到 #340 那次提交把分支前缀里的 codex 字样去掉了,也能看到 #412 专门为它加了 PR 模板感知。是被真实交付流程磨过的东西。
我准备从三个角度拆它:整条工作流是怎么一步步收口的,它背后那层状态探测架构长什么样,以及哪些地方它在赌你不会翻车。
工作流拆解
整条链路读下来像一份事故复盘清单,几乎每一条都能对应到某个具体的翻车现场。第一步不是 git 命令,是两道环境门禁。
gh --version          # 没有就让用户装,然后 stop
gh auth status        # 没登录就让用户 gh auth login,重跑确认后再继续
这两行的价值在于它们带 stop 语义。很多 Skill 会写成如果没有 gh 就提示用户安装,模型读完经常一边提示一边继续往下跑,最后在 push 那步炸掉。这里直接用 stop 把执行流掐断,没有商量余地。
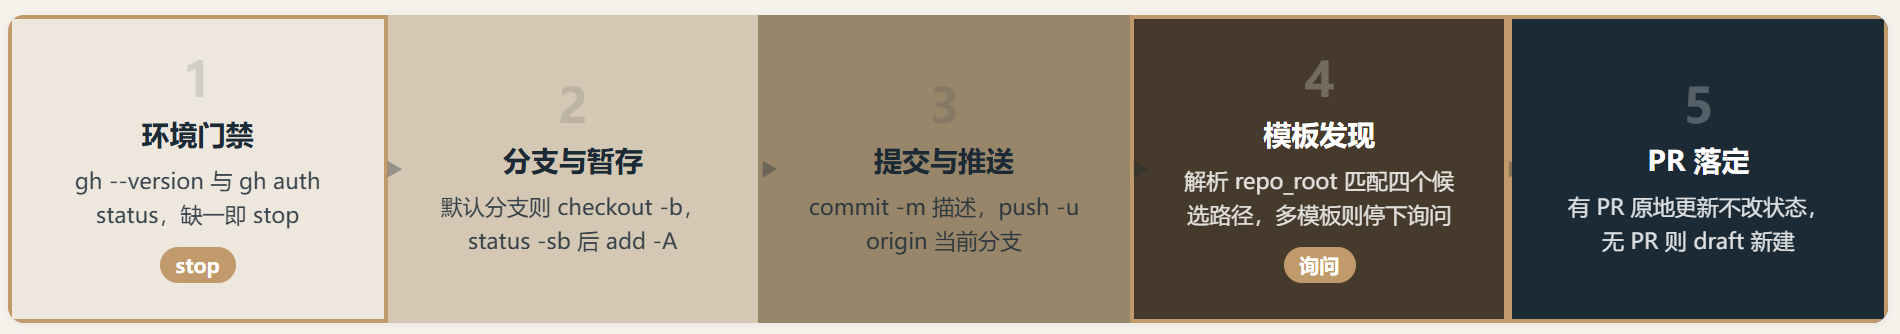
过了门禁才进命名约定。分支名、commit message、PR 标题三者共用同一个 {description} 变量,从默认分支切出时分支就叫这个名字,commit 用它的精简版,PR 标题用它概括整个 diff。这个设计看着偷懒,实际是在保证三处文本同源,避免你在 GitHub 上看到一个叫 fix-login-redirect 的分支顶着一条叫 update 的提交。
真正的执行序列是这几步,中间夹着两个失败补偿:
git checkout -b "{description}"        # 仅当当前在 main/master/default
git status -sb && git add -A
git commit -m "{description}"
git push -u origin $(git branch --show-current)
git add -A 前面挂了 git status -sb,要求先确认工作区状态再全量暂存。这个顺序是给模型留了一次看见的机会,让它有机会发现你忘了删的调试文件。至于 checks 那一步,文档只说若检查因缺依赖或工具失败就装依赖重跑一次,没定义到底跑什么,这是它最松的一处。
push 那句后面跟了个补偿分支:如果因为 workflow 权限报错失败,就 pull master 再重试一次。这种补丁式的句子在文档里一共只有两条,另一条是模板发现遇到多个候选时停下来问用户。凡是让你停下来的地方,都是它自己也没把握的地方。
架构解析
把整份文档按语义重排,它其实是三层,越往下越像程序而不是提示词。
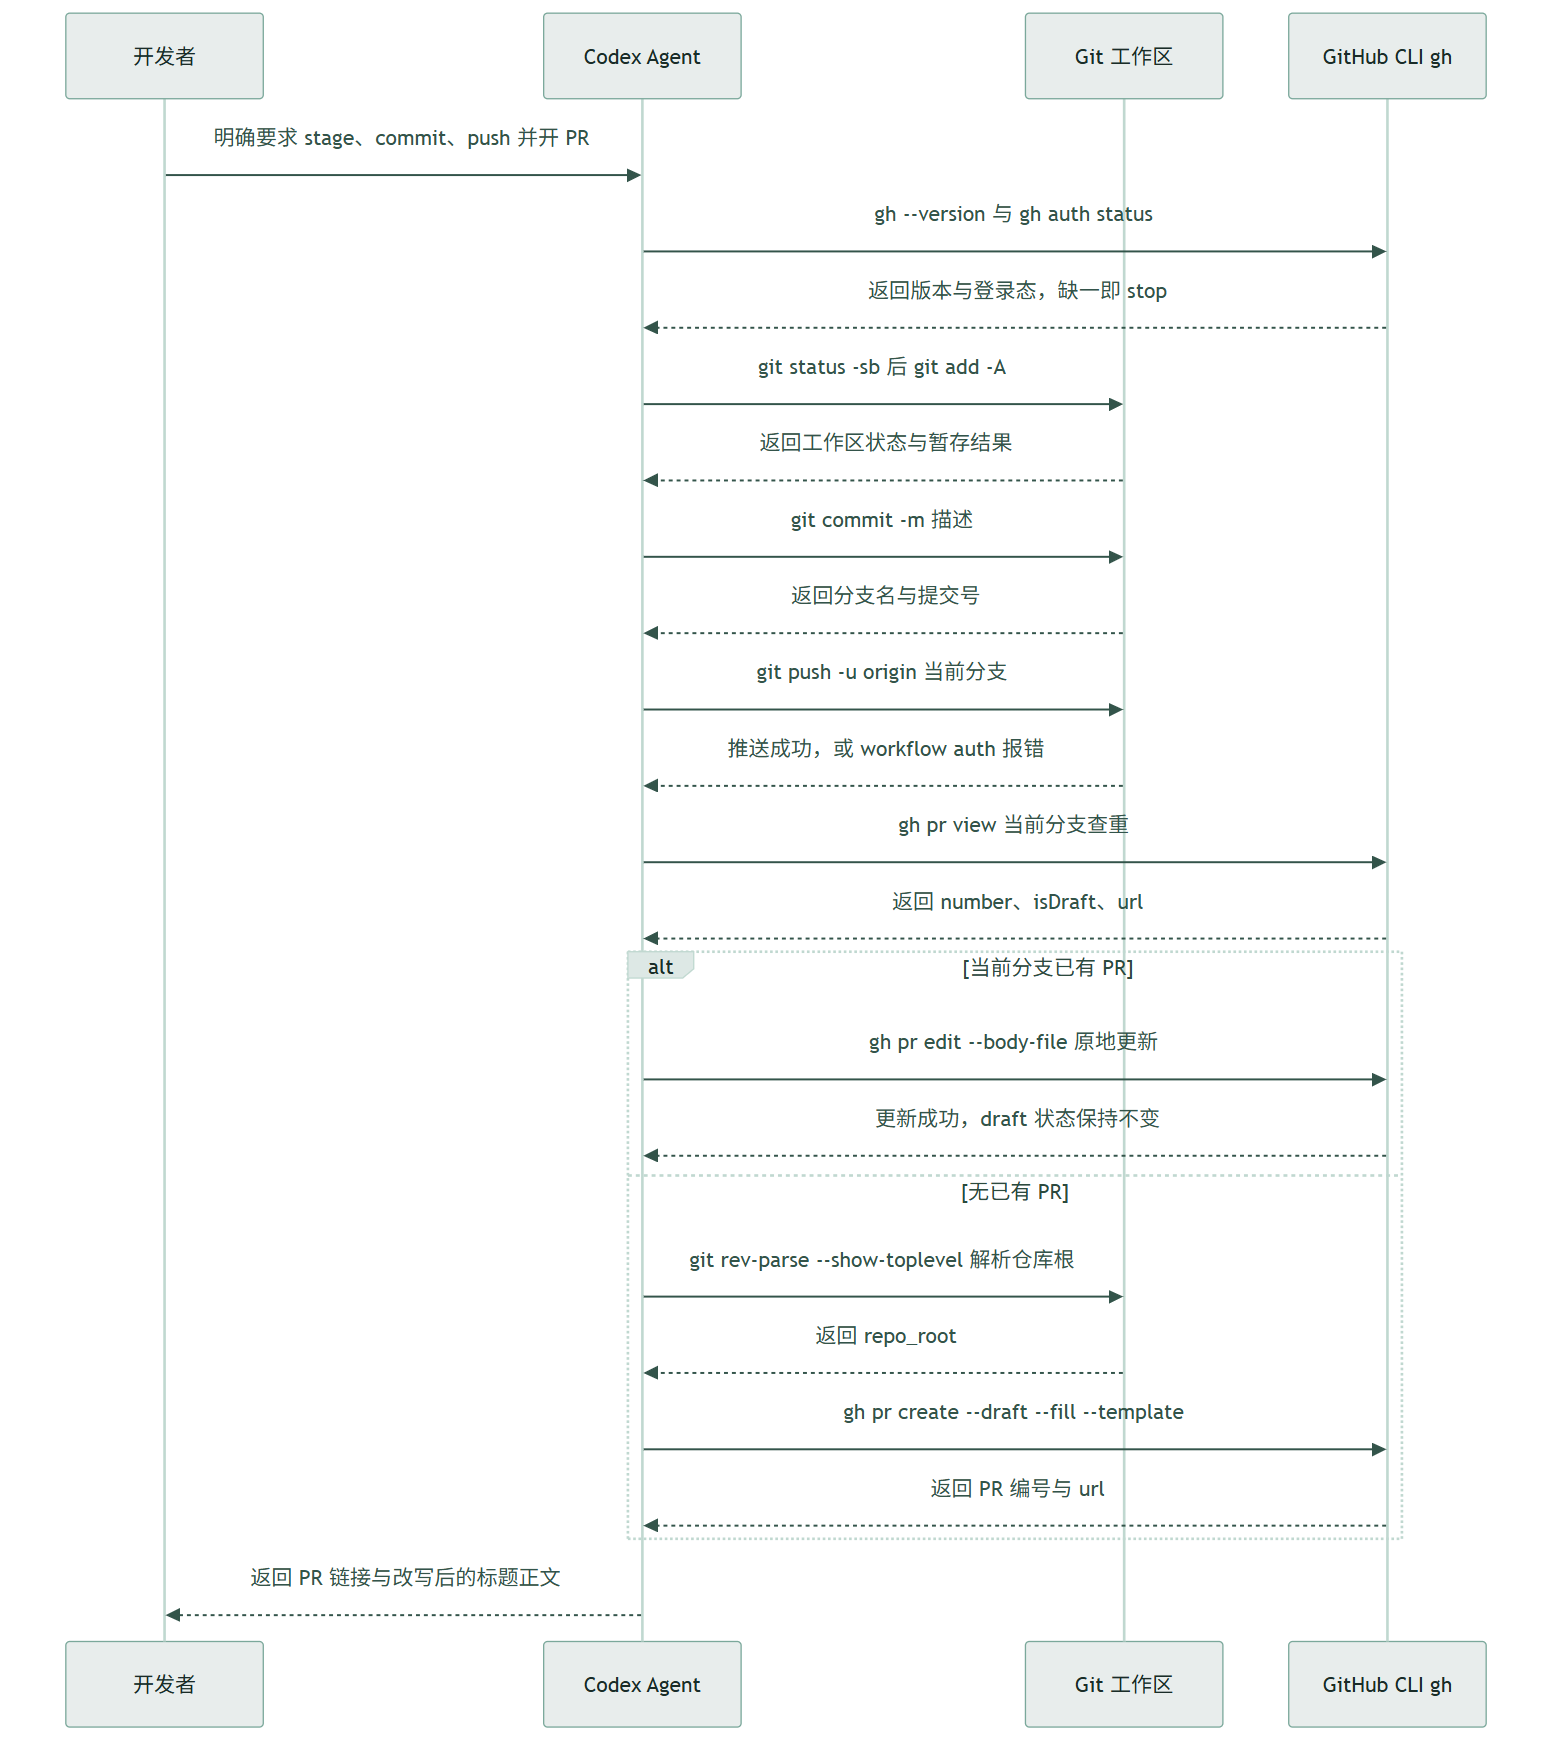
最上面那层是状态探测层。gh pr view "$(git branch --show-current)" --json number,isDraft,url 这行是整篇的枢纽,它决定了后面走新建还是走更新。文档在这里写了两条硬规则:已有 PR 就原地更新,不新建第二个;绝不改动已有 PR 的 draft 或 ready 状态。第二条尤其关键,它把 yeet 的默认行为约束成单向的,新建的一律是 draft,已存在的动都不动。
这个单向性设计我认为是全文最值钱的地方。Agent 类工具最容易犯的错是每次运行都试图把世界恢复到它认为正确的状态,于是你昨天刚点的 Ready for review,它今天跑一遍又给你改回 draft。yeet 用一句话把这个可能性堵死了。
中间层是两个环境变量,很容易被跳过:
GH_PROMPT_DISABLED=1 GIT_TERMINAL_PROMPT=0 gh pr create --draft --fill --head "$(git branch --show-current)"这两个变量是为了掐掉 gh 的交互式提问。Agent 跑在没法回答终端提问的环境里,一旦 gh 弹出让你选模板的菜单,整个流程就挂死在那儿。加上 --fill 让它自动从 commit 信息填标题和正文,整条命令就变成了一个可非交互执行的原子动作。
最下面那层是产物改写层。文档要求创建完 PR 之后再改标题和正文,让它们反映真实的净变更,并且强调要把正文写进临时文件用 --body-file 或 gh pr edit --body-file 传,避免 \n 被转义成一整行。这个细节非常具体,一看就是被 GitHub 上那堆挤成一坨的 PR 描述教育过。
使用场景
判断一个 Skill 好不好用,得看它在边界场景里怎么表现。我挑四个场景说。
第一个是你在 feature 分支上迭代了好几轮,PR 早就开着了。文档要求先 gh pr view 查当前分支有没有 PR,有就更新不新建。这条看起来基础,实际是这类 Skill 最常见的翻车点,一天下来同一个分支被开出四五个 PR 的场面我见过不止一次。
第二个是仓库配了 PR 模板。文档给了四个候选路径,按优先级找,并且要求用 git rev-parse --show-toplevel 拿到仓库根再拼路径:
.github/pull_request_template.md.github/PULL_REQUEST_TEMPLATE.md.github/pull_request_template/下的单个 md.github/PULL_REQUEST_TEMPLATE/下的单个 md
找到一个就传给 gh pr create --template,找到多个就停在开 PR 之前问你要用哪个,一个都没有才回落到内置的 Why / What Changed 结构。三种情况三条分支,没有一条是含糊的。
第三个场景是正文改写时的保护。文档专门加了一句检查已有正文里有没有关键信息要保留,举的例子是永远不要删掉正文里的图片,因为作者可能没法恢复。这种句子只可能来自真实事故。
第四个场景是它明确不该被用的情况。你只想本地提交不想开 PR,你想先看看 diff 再说,或者你的远程在 GitLab 上,这三种都不该触发 yeet。description 里那句 use only when 就是这道闸。
洞察与反思
拆完之后,我觉得这份文档最值得抄走的设计有三个,也各有各的代价。
| 设计 | 做法 | 代价 |
|---|---|---|
| 状态探测优先 | 先 gh pr view 判重再决定新建或更新 |
强绑 GitHub,换 GitLab 整份失效 |
| 状态单向演进 | 新建必 draft,已有 PR 的 draft 状态不动 | 用户想批量转 ready 时没有出口 |
| 非交互原子命令 | 两个环境变量 + --fill 掐掉所有提问 |
遇到 gh 版本差异时报错信息被吞 |
第一个亮点我自己写 Prompt 时已经借走了。多数人写这类指令会按动作顺序排,先提交再推送最后开 PR;yeet 是按状态分支排的,先问你现在在哪,再决定做什么。前者是脚本,后者才是状态机。
第二个值得说的是它对 PR 正文的要求。文档反复强调要写清楚为什么改,而且为什么必须排在改了什么前面,同时明确限制只讨论这次提交的净变更,不允许提那些试过又被回滚掉的方案。这条我怀疑来自 code review 时的实际抱怨, reviewers 最烦的就是在 PR 描述里读一段作者的心路历程。
不足也很明显,我数出来四处。
git add -A 是无条件的全量暂存,没有忽略策略,也没有确认环节。你的 .env、编辑器临时文件、随手放的调试脚本,全都一起进去了。文档唯一的缓冲是先跑 git status -sb,但那只是让模型看见,不是让它停下来。
分支命名直接用 {description},没做任何 slug 化处理。你用中文描述,或者一句话里带空格和斜杠,git checkout -b 当场就报错。这个坑在英文语境下不容易暴露,中文用户一撞一个准。
命名约定和 PR 标题格式之间有内部张力。上半部分说 PR 标题就是 {description},下半部分又给了 <type>(<scope>): <subject> 的 conventional commit 格式和七种 type 枚举。两者没说清谁优先,模型会随机选一个。真要我改,我会把 {description} 明确成 subject 部分,前面强制补 type。
最后是零回滚。整份文档没有任何一步失败后的回滚设计,push 成功但 PR 创建失败时,你的提交已经躺在远端了。
资源地址
| 资源 | 链接 |
|---|---|
| Smithery 页面 | https://smithery.ai/skills/openai/yeet |
| 来源仓库 | https://github.com/openai/skills |
| 安装命令 | npx skills add https://github.com/openai/skills –skill yeet |
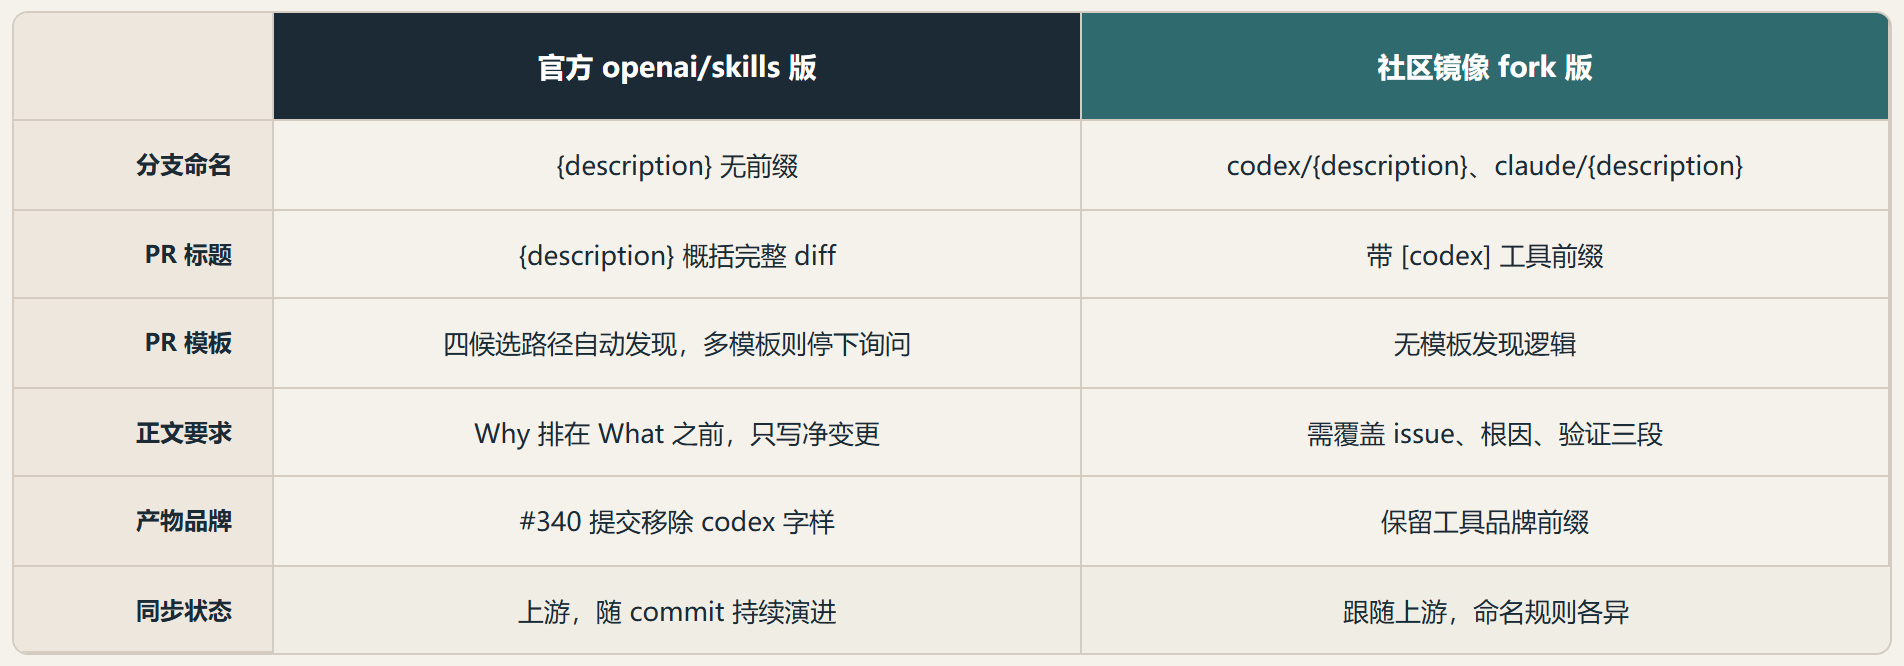
还有个细节值得记一笔。社区镜像版本分支前缀是 codex/{description},PR 标题带 [codex] 前缀,trailofbits 那边改成了 claude/{description}。官方 curated 版在 #340 那次提交里把这些字样全去掉了,理由是不在 GitHub 产物里提 codex。同一份 Skill 在不同 fork 里有三种命名风格,你装之前最好先确认自己拿到的是哪一版。
总结
值不值得装,取决于你的远程在不在 GitHub 上。如果你日常就在用 gh 管仓库,又习惯让 Agent 干完活顺手开个 draft PR 自己再去改标题加 reviewer,这份 Skill 基本开箱即用,装完省掉的是每次重复描述 git 流程的那几句话。
我自己的改法有三条:把 git add -A 换成显式路径列表或者加一条忽略清单;给 {description} 补一个 slug 化步骤;在 push 之前插一个 dry-run 确认。这三条都不难,加起来大概十行。
如果你指望拿它当跨平台的通用提交工具,那趁早放弃,它从第一行到最后一行都长在 gh 上。真正的价值在它那条状态机思路,不在那几条命令。
最后留个问题:这种默认开 draft 的设计,你认为是保护还是负担?我现在越来越倾向于认为默认 draft 是这类 Agent 工具的正确默认值,但每次还要手动点一次 ready,累积起来也是成本。你怎么看,评论区聊。