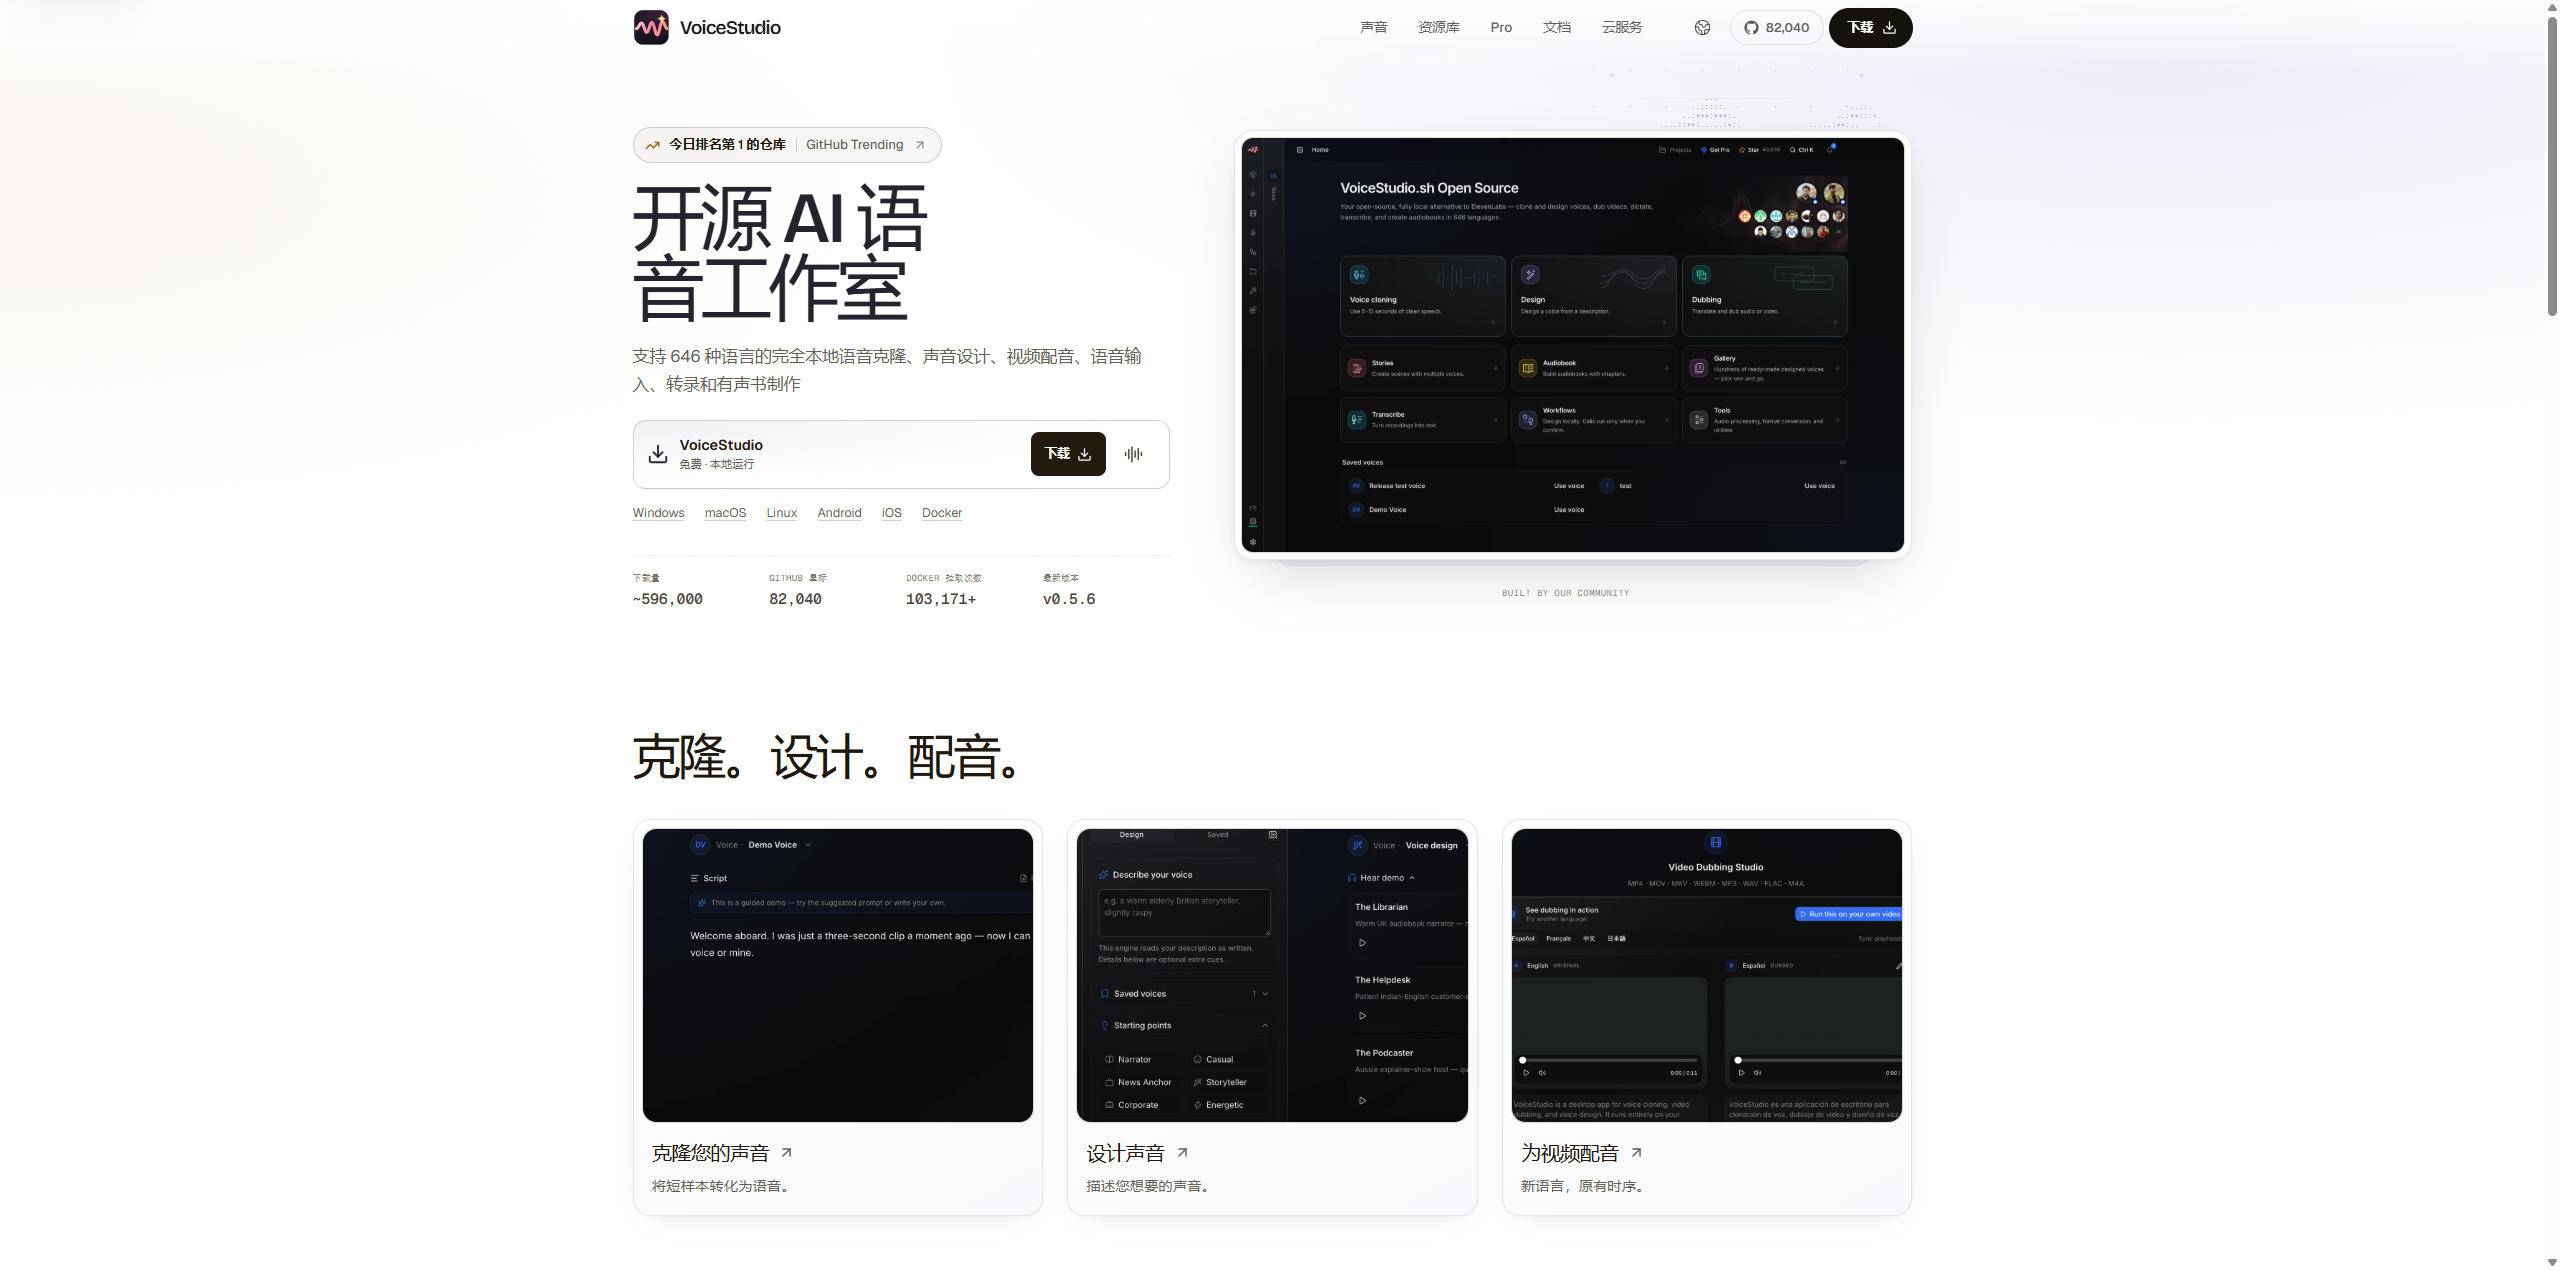
VoiceStudio 是过去半年 GitHub 上最能打的一个本地语音项目,也是最容易让你在许可证上吃闷棍的一个。这两句话不矛盾。它把云端语音服务那套能力拆成了 19 个语音合成引擎和 12 个语音识别引擎,全部跑在你自己的机器上,不需要账号,也不需要 API Key。
截至 2026 年 11 月 1 日,仓库有 96,556 Stars、10,714 Forks、334 个 watcher。它 2026 年 4 月 9 日才创建,半年做到这个体量,期间长期挂在 Trendshift 榜首。协议是 AGPL-3.0,主要语言 Python,最新版本 v0.5.7 发布于 10 月 26 日,版本号还停在 0.5 这个量级。
我起初把它归进“又一个贴着开源标签的云端服务套壳”那一类。翻到 LICENSE-NOTICE.md 才停住:默认引擎 k2-fsa/OmniVoice 的代码是 Apache-2.0,权重是 CC-BY-NC,非商用。应用本身商用完全没问题,官方文档写得很清楚。但你要靠它给客户配音赚钱,默认装上的那颗模型先把门关了一半。
更让我在意的是另一处。docs/benchmarks.md 打开是一张空表,正文只写着一行:No verified rows yet。一个专门给了测试脚本、把本地性能当卖点的项目,性能表是空的。这两件事凑在一起,就是这篇文章想聊的东西:它强到什么程度,弱在哪里,README 里那套漂亮话有哪几句经不起查?
它把一整条语音生产线装进了一个 app
有区分度的地方不是“支持语音克隆”这种人人都会写的功能。是它把引擎做成了可插拔的插槽。docs/engines/README.md 里列了 19 个 TTS 引擎和 12 个 ASR 引擎,从默认的 OmniVoice,到 CosyVoice 3、GPT-SoVITS、IndexTTS 2.5、VoxCPM2、KittenTTS,再到跑在 Apple Silicon 上的 MLX 系和走 GGUF 的原生运行时。每个引擎装法不同,但对外暴露的接口是同一个。
这件事的价值在换语言和换硬件的时候才显出来。中文情绪表达 IndexTTS 更稳,纯 CPU 的小机器上 Kokoro 那八千多万参数的版本更实际,苹果芯片上 MLX 系比 PyTorch 快一截。单引擎方案走到这一步就得改代码,VoiceStudio 里只是换个下拉选项。
第二件事是配音链路做全了。丢一个视频进去,WhisperX 先做带词级时间戳的转录,人声分离单独跑,字幕按段切好,NLLB 做翻译,再挑目标音色重新合成,最后按原片时长对齐。混剪号和出海内容团队最费时间的就是这一段,现在被串在同一个界面里。
音频对齐是它工程上最扎实的部分。合成长度不可能天然等于原句时长,粗暴拉伸会留下明显的痕迹。它把重混和重合成分开,只改时间轴的重混不重新调用 TTS,缓存命中时合成次数是零。tests 里还有一组操作数预算测试专门盯这条路径,任何一次多余调用都会让 CI 挂掉。
这些能力不是并排摆在界面上的一排按钮,而是一层一层往下落的。想看清它们怎么叠起来、许可的边界到底画在哪一层,得先看它的整体结构,因为后面所有关于能不能商用的讨论,都建立在这张图的分层上。
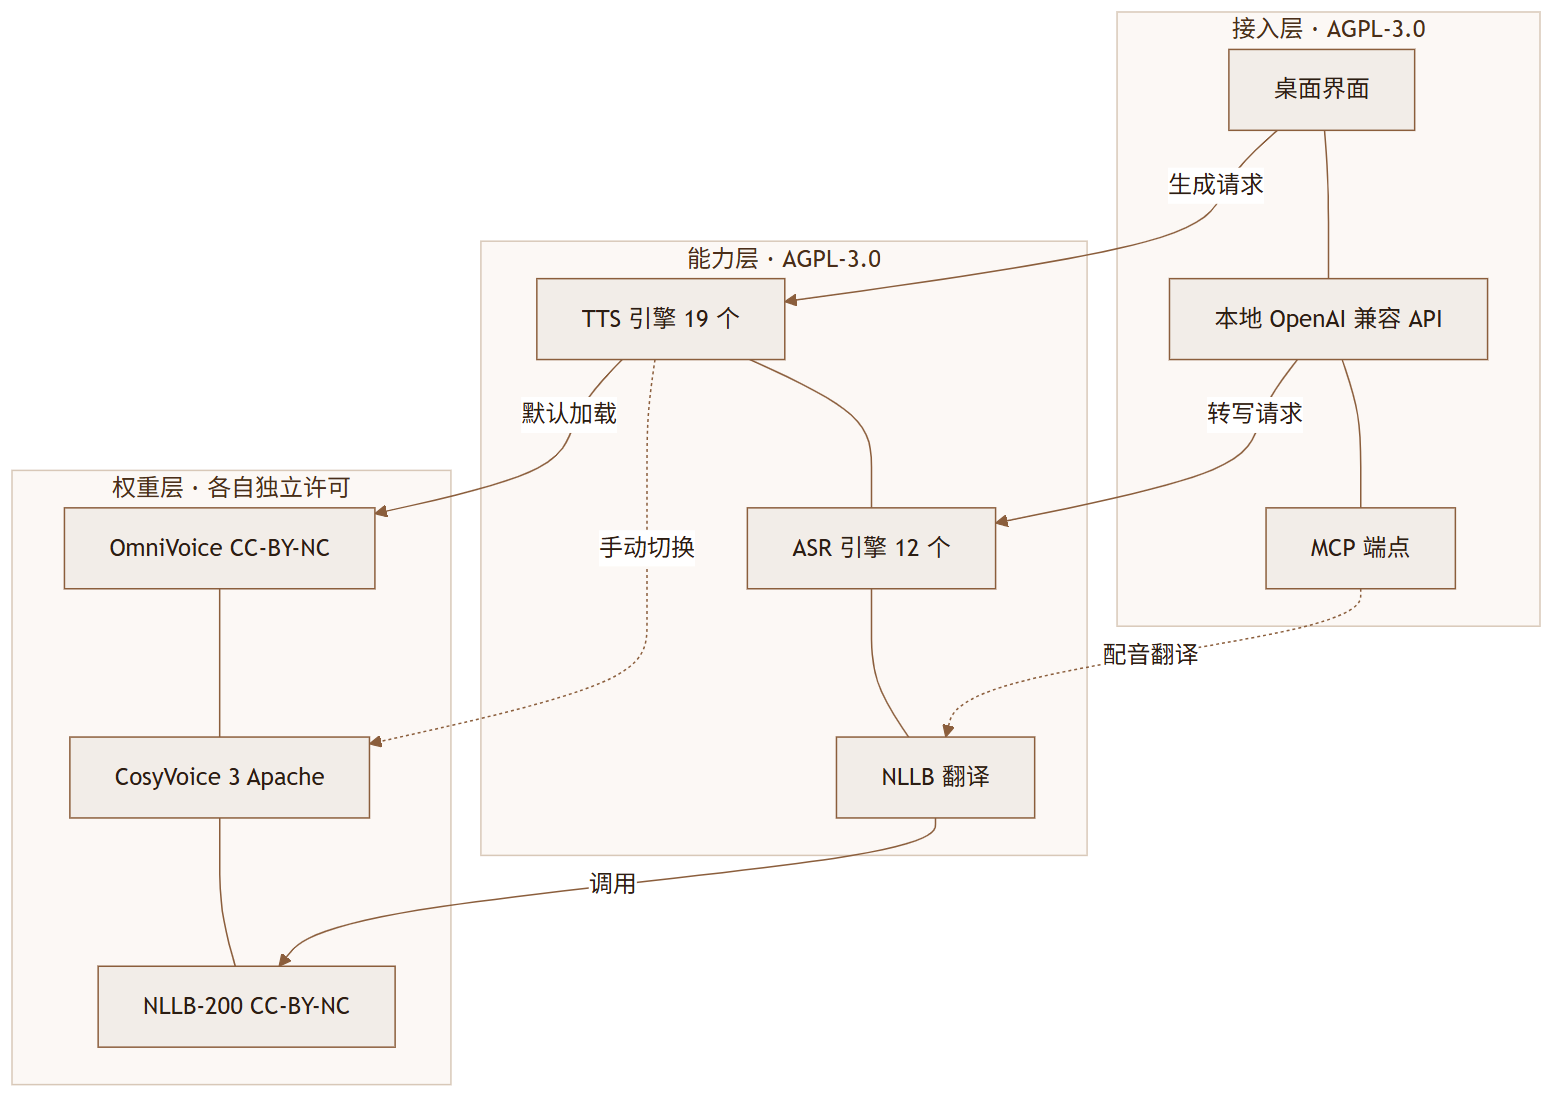
从上往下看,桌面外壳、本地服务、引擎适配这三层都是 AGPL-3.0 的应用代码,随便商用。到了最底层的模型权重,性质就变了,这也是整个项目最容易被误读的一段。
对开发者来说,还有一层比界面更有用的东西:本地服务。后端跑在 127.0.0.1:3900,对外是 OpenAI 兼容格式,/v1/audio/speech 做合成、/v1/audio/transcriptions 做转录,另外开了 MCP 端点给 Claude Code、Codex 这类客户端直接调用。现有代码把 base_url 指过去就能用,这一点比大多数同类项目省事。
从一条命令到第一段音频
不想碰命令行也行,releases 页面有现成的 dmg、exe、AppImage 和 deb 包,覆盖 macOS、Windows 和 Linux 三个主流桌面平台。习惯脚本的话,官方给的两条命令就能装完,前者对应 Unix 系,后者走 PowerShell:
# macOS / Linux
curl -fsSL https://voicestudio.sh/install | sh

# Windows (PowerShell)
irm https://voicestudio.sh/install.ps1 | iex
从源码跑要先把 Bun 装上。README 给的路径是 clone 之后 bun run dev,脚本会先装前端依赖,再建 Python 环境,最后拉起 Electron。只想重建 Python 环境就单独跑 bun run setup:api。最慢的一步永远是模型下载,官方没有给统一的硬盘要求,第三方评测里常提到要预留十到二十个 G 的量级。
装完它不会偷偷下模型,第一次生成前会问你要不要下,这点比不少同类项目克制。没有独显也能跑,代价是慢。有个坑得提前说:第一次生成永远是最慢的一次,权重要懒加载,CUDA 还要现场编内核,判断速度得从第二次开始看。
服务跑起来之后不要急着写代码,先用两条命令确认它是活的。第一条拿能力清单,第二条走一次完整的转录,两步都能过再谈集成的事。这几秒钟的验证能省掉后面大半的排查时间:
curl http://127.0.0.1:3900/.well-known/voicestudio-speech
python -m backend.speech_client transcribe recording.wav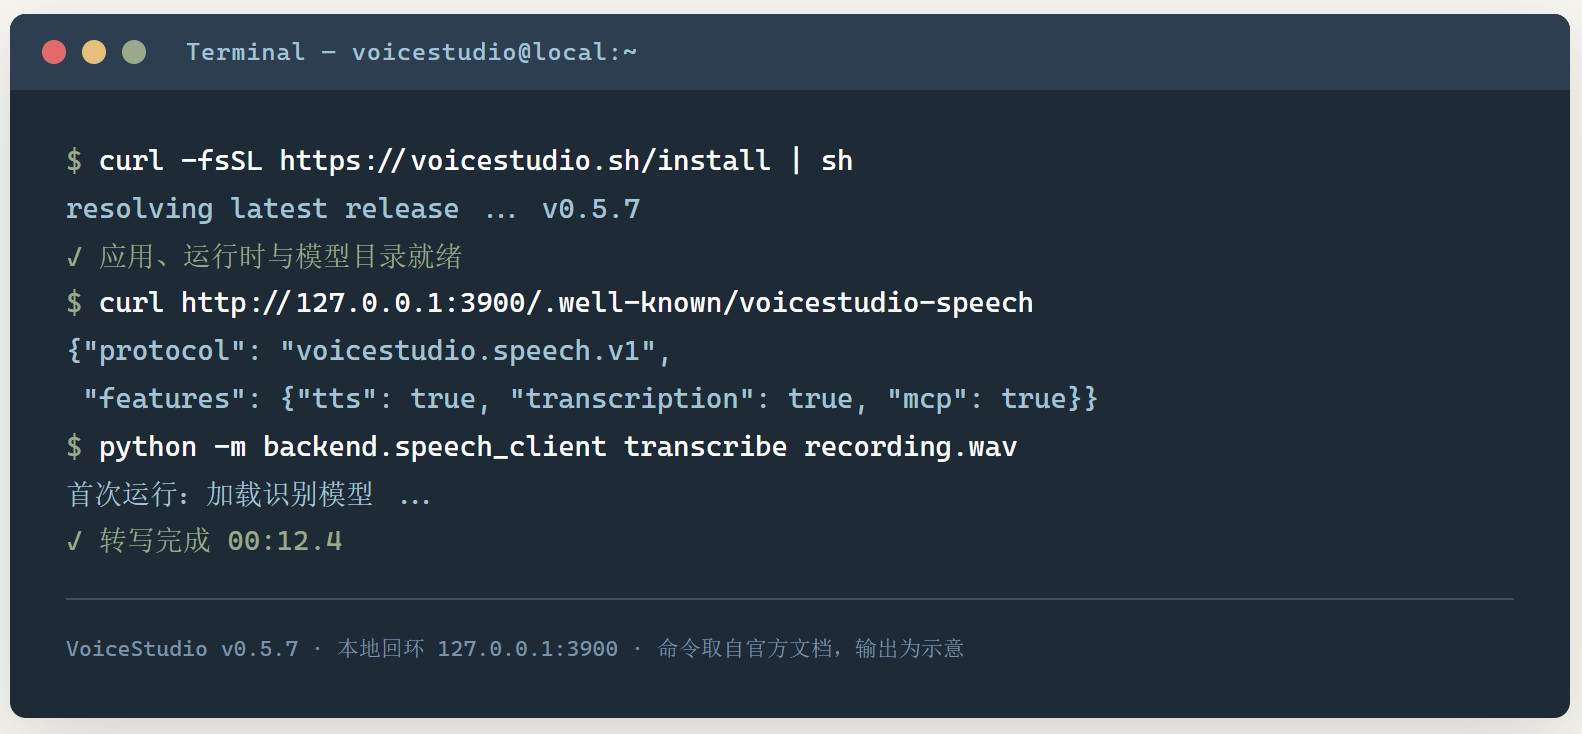
返回的文档会带上 voicestudio.speech.v1 版本号和一批相对路径,所以挂在 Tailscale 或者反向代理后面也能用。真要接进自己的流水线,把 OpenAI SDK 的 base_url 改成 http://127.0.0.1:3900/v1 就够了,api_key 不填也能过,只有你主动设了 OMNIVOICE_API_KEY 才会开始校验。不过这套本地接口没有内置鉴权,多用户共用一台机器的时候得自己加一层。
装好只是起点。这个项目功能摊得极开,用不用得舒服几乎完全取决于你的场景对不对得上,跟工具本身好不好关系不大。所以下一步不是继续挖功能,是先把判断做掉。
什么时候该用,什么时候别碰
它的定位不是一个 TTS 工具,是一个本地语音工作台。判断自己该不该装,看这四个位置对不对得上。
| 位置 | 典型用户 | 它的优势 | 它的短板 |
|---|---|---|---|
| 本地全流程工作台 | 独立创作者、小工作室 | 克隆、设计、配音、转录、有声书在一个 app 里 | 界面复杂度不低,首次配置要花时间 |
| 多引擎试验台 | 做语言覆盖和多语言配音的团队 | 19 个 TTS、12 个 ASR 可随硬件切换 | 引擎质量参差,得自己逐个试 |
| 私有部署语音服务 | 医疗、法律、未公开素材 | 数据不出本机,OpenAI 兼容接口直连 | AGPL 网络条款对闭源分发不友好 |
| 单一稳定英文 TTS | 只要报幕和旁白的场景 | 免费、无用量上限 | 开箱稳定性不如打磨多年的云端服务 |
表格里最值钱的是第二行。真正的差异化不在功能列表,在“你可以为了某个语言、某块显卡换掉整个引擎而不改一行调用代码”。
三类人我会直接劝退。只想给英文视频配个稳定旁白,而且没打算研究模型的,云端服务省心得多。机器是 Intel Mac 的,本地后端直接不支持,只能连远程。想把它嵌进闭源产品对外卖的,AGPL 的 Affero 条款要求你把修改后的完整源码开放给网络用户,这条比 GPL 更硬。
还有一条比技术更硬的限制。官方自己在 LICENSE-NOTICE.md 里写明:No commercial clearance is asserted by the initial inventory。backend/config/model_licenses.json 里登记的 70 个模型,5 个被明确标为非商用,其余 65 个是 unreviewed,一个都没被认定可以商用。默认引擎就在那 5 个里面,视频配音的翻译模型 facebook/nllb-200-distilled-600M 也是 CC-BY-NC-4.0。所以拿它做付费项目之前,第一件事是换引擎,而不是研究界面。
说完这些边界,该看这个项目背后是什么样的人在推了。一个半年冲到十万星的仓库,维护结构比功能列表更能说明它能走多远,也更容易被忽略。
两个人的项目,跑着一百个人的节奏
| 指标 | 数据(2026-11-01) | 说明 |
|---|---|---|
| Stars / Forks | 96,556 / 10,714 | 半年 96k,Trendshift 榜首常客 |
| 核心维护者 | 2 人 | debpalash 与 velixio,兄弟两人 |
| 提交集中度 | 前 100 位贡献者共 6,334 次 | 两人占 89.1%,第三名 141 次 |
| Open Issues | 102 | 相对 96k Stars 极低 |
| 最新版 | v0.5.7(2026-10-26) | 从 0.5.1 到 0.5.7 不到两个月 |
| 协议 | AGPL-3.0 | 企业采用需评估网络条款 |
这份数字里最值得看的是提交集中度和 PR 吞吐的反差。debpalash 一个人 4,590 次提交,占全部统计量的 72.5%,velixio 912 次,加上同一人的另一个身份 141 次,两个人合起来接近九成。十个以上外部贡献者,每人贡献都在几十次的量级。同期 PR 编号已经排到 #3738,说明合并速度非常快。
Bus Factor 在这里是 2。一个半年冲到十万星的仓库,代码资产压在两个人身上,这是它最实在的风险,比任何技术缺陷都更值得盯。
另一处摩擦是许可证治理。2026 年 10 月项目推出 CLA,要求贡献者把版权授权给维护方 Yupcha Softwares Private Limited,issue #2586 攒了 68 条评论。有位 42 次提交的贡献者 psiberfunk 在 10 月 3 日写了一段挺有分量的话:“CLA 1.0 是一份比我们大多数人贡献时适用的条款要宽得多的协议,它明确覆盖过去和未来的贡献,授予永久的、不可撤销的权利,用于专有产品、再许可、专利和未来收购方的转让。”他接着提议,贡献者至少应该拿到一份永久的个人 Pro 授权。
这不是什么黑料,是标准的 open core 打法:AGPL 应用开源,商业化靠 Pro 和闭源嵌入授权。只是 README 里那句“VoiceStudio is free and has no paid cloud behind it”,读起来跟 LICENSE-NOTICE 里指向 voicestudio.sh/pro 的那句话有点温差。
另一个长期未决的坑是代码签名。issue #1779 从 9 月 3 日开着,贡献者 BichengWang 在 10 月 10 日贴出校验记录:v0.5.6 的 macOS DMG 哈希跟发布页一致,打开仍报已损坏。维护者的回应很坦率,签名早接进了 release 工作流,缺的是那张九十九美元一年的苹果证书。聊到这儿,接下来该给个明确态度了。
我的判断:它值 96k 星,但不能按 README 的方式用
先给结论。VoiceStudio 是我目前见过完成度最高的开源本地语音工作台,但它现在更接近“功能齐全的试验场”,还不是“可以无脑交付的生产线”。
我一开始笃定它是靠“ElevenLabs 平替”这个标签吃到流量的。翻完 docs 目录之后这个判断被推翻了一半。performance.md 有三万多个字符,逐条列出“感觉变慢”的真实成因,每一条都挂着回归的 issue 号:v0.3.15 之前空 transcript 会每次生成都重跑一遍 Whisper,v0.3.23 之前中断配音会把 TTS 模型遗留在 CPU 上,之后每次生成都慢十到五十倍。敢把自己修过的坑写成文档的项目,代码品味通常在平均线以上。
但它也暴露了同一种品味的反面。benchmarks.md 从建立到现在只有一张空表和一份贡献指南,框架搭得很讲究,一个人都没往里填数据。这不是懒,是把“性能表必须由真机跑出来”这条标准执行到连自己的宣传材料都不肯凑数。对做技术判断的人是加分,对想快速选型的人就是减分。你说这算不算一种诚实过头?
许可证这件事我不觉得是算计。model_licenses.json 里 65 个 unreviewed 全部标 true→false 的失败关闭设计,反而说明维护方知道这件事的分量:没审完就不能算能用。真正的问题在对外表达上。落地页写着“Run it, for anything, including at work and for money”,而默认引擎的权重是非商用,这两句话之间的缝,普通用户读完 README 是看不出来的。
只盯着它自己的功能列表容易失真。把它和常被拿来当参照的几类方案摆在一起,位置反而清楚得多,因为这四个选项代表的其实是四条互斥的取舍路线。卡里 ElevenLabs 的语言数和月费区间取自项目 README 的对比表,与第三方评测口径一致。
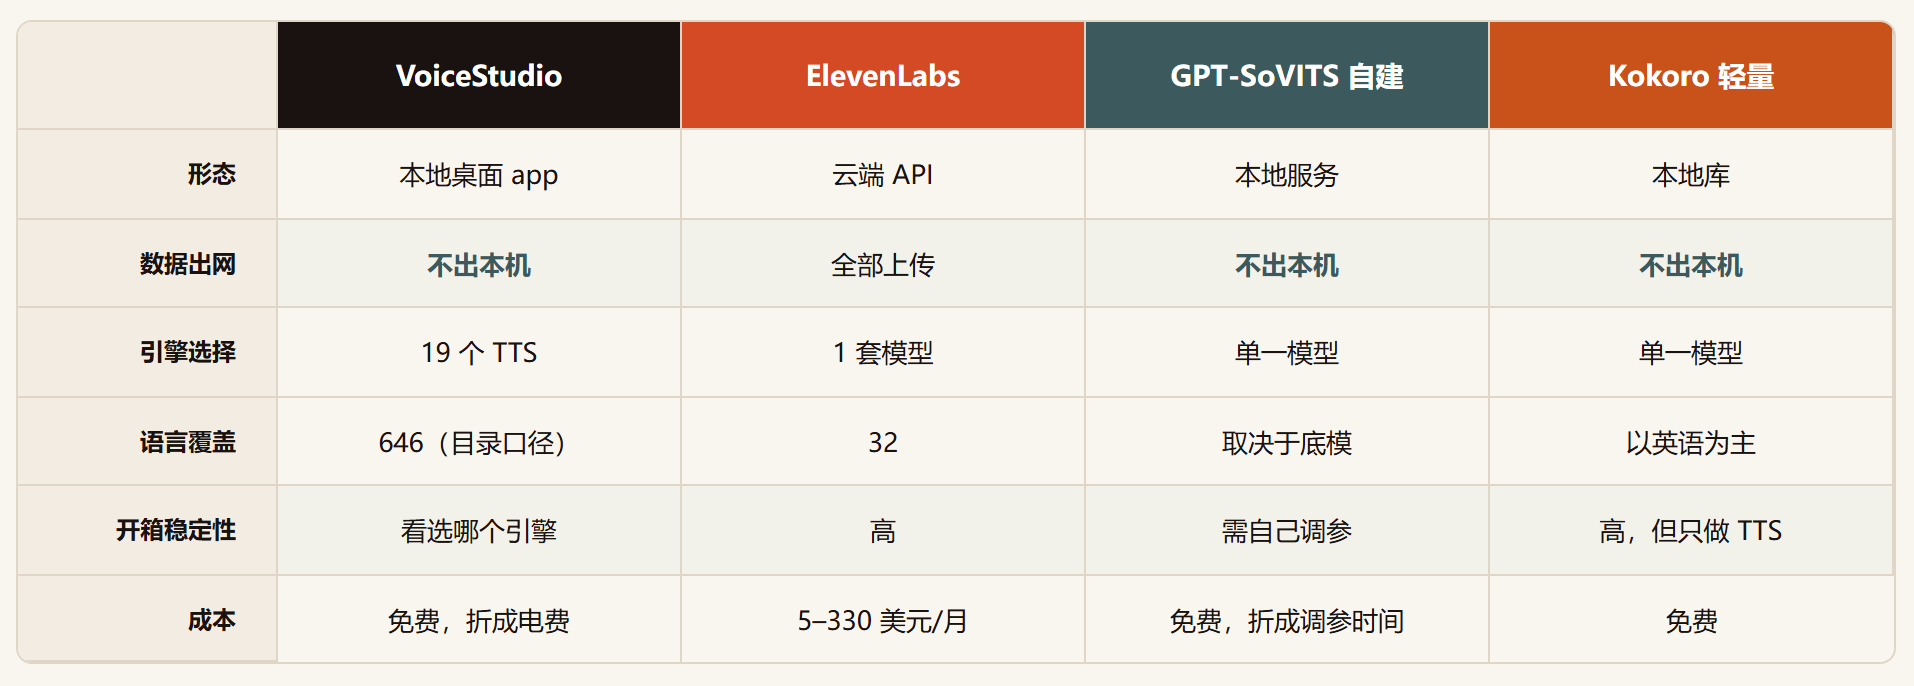
跟 ElevenLabs 比,差距不在功能数量,在“开箱即用”这四个字。云端服务的价值是把一个模型调到所有场景都稳定,本地工作台的价值是让你在任何一个场景都能换到合适的模型。前者省时间,后者省成本和数据。中间那两条路线各有各的窄门,GPT-SoVITS 调参成本高但上限高,Kokoro 轻到极致但只能干一件事。
趋势上我偏乐观。半年 96k Stars 的数字可以靠话题买来,但 v0.5.1 到 v0.5.7 两个月七个版本、PR 编号冲到三千七百多、102 个 open issue 对应十万星,这套节奏买不到。真正需要观察的是两件事:外部贡献者能不能突破现有的一成份额,以及那张性能表什么时候有人填上。
资源地址
| 资源 | 地址 |
|---|---|
| GitHub | https://github.com/debpalash/VoiceStudio |
| 官网 | https://voicestudio.sh |
| 最新发布 | https://github.com/debpalash/VoiceStudio/releases/latest |
| 引擎目录 | https://github.com/debpalash/VoiceStudio/blob/main/docs/engines/README.md |
| 性能指南 | https://github.com/debpalash/VoiceStudio/blob/main/docs/performance.md |
| 本地接口 | https://github.com/debpalash/VoiceStudio/blob/main/docs/speech-platform.md |
| 许可说明 | https://github.com/debpalash/VoiceStudio/blob/main/LICENSE-NOTICE.md |
先把引擎换成能商用的那颗
如果你只是给自己做旁白和转录,现在就可以装,从 Voice Cloning 那个界面进去最快,装完先跑一段三十秒的短文本,别拿长篇当第一次测试。
如果你的用途涉及收款,顺序要反过来。先去 Model Manager 里把默认引擎从 OmniVoice 换掉,CosyVoice 3 和 VoxCPM2 的权重都是 Apache-2.0;视频配音如果要用翻译,NLLB 那条链路也得查一遍。这一步比调参数重要得多,因为它决定你的产出能不能合法交付。
如果你在评估要不要把它写进团队的技术栈,盯两个指标就够了。一是外部贡献者的提交占比能不能从一成往上走,二是 docs/benchmarks.md 什么时候出现第一行真实数据。这两件事决定了它是停留在个人作品,还是长成一个能背责任的工具。
一个半年长出十万星的项目,最容易犯的错是被自己的速度骗了。VoiceStudio 目前还没犯这个错,它只是还没来得及把该说的话说完。