想让 AI 把页面做得像有人设计过,直觉是给它更多资料、更好的提示词、更多示例。Hallmark 反过来做。它最厚的文件是一份写着 88 条编号规则的清单,其中 39 条一条都不许破,26 条只记录不拦路,剩下的部分才谈美。
项目 2026 年 4 月 27 日建仓,MIT 协议,出自 Together AI 的人,README 第一行写着给 Claude Code、Codex、Cursor、OpenCode 用。截至 2026 年 11 月 1 日,43,678 Stars、2,291 Forks,10 月 27 日单日涨 2,372 星,挤进当天 GitHub 日榜第二。
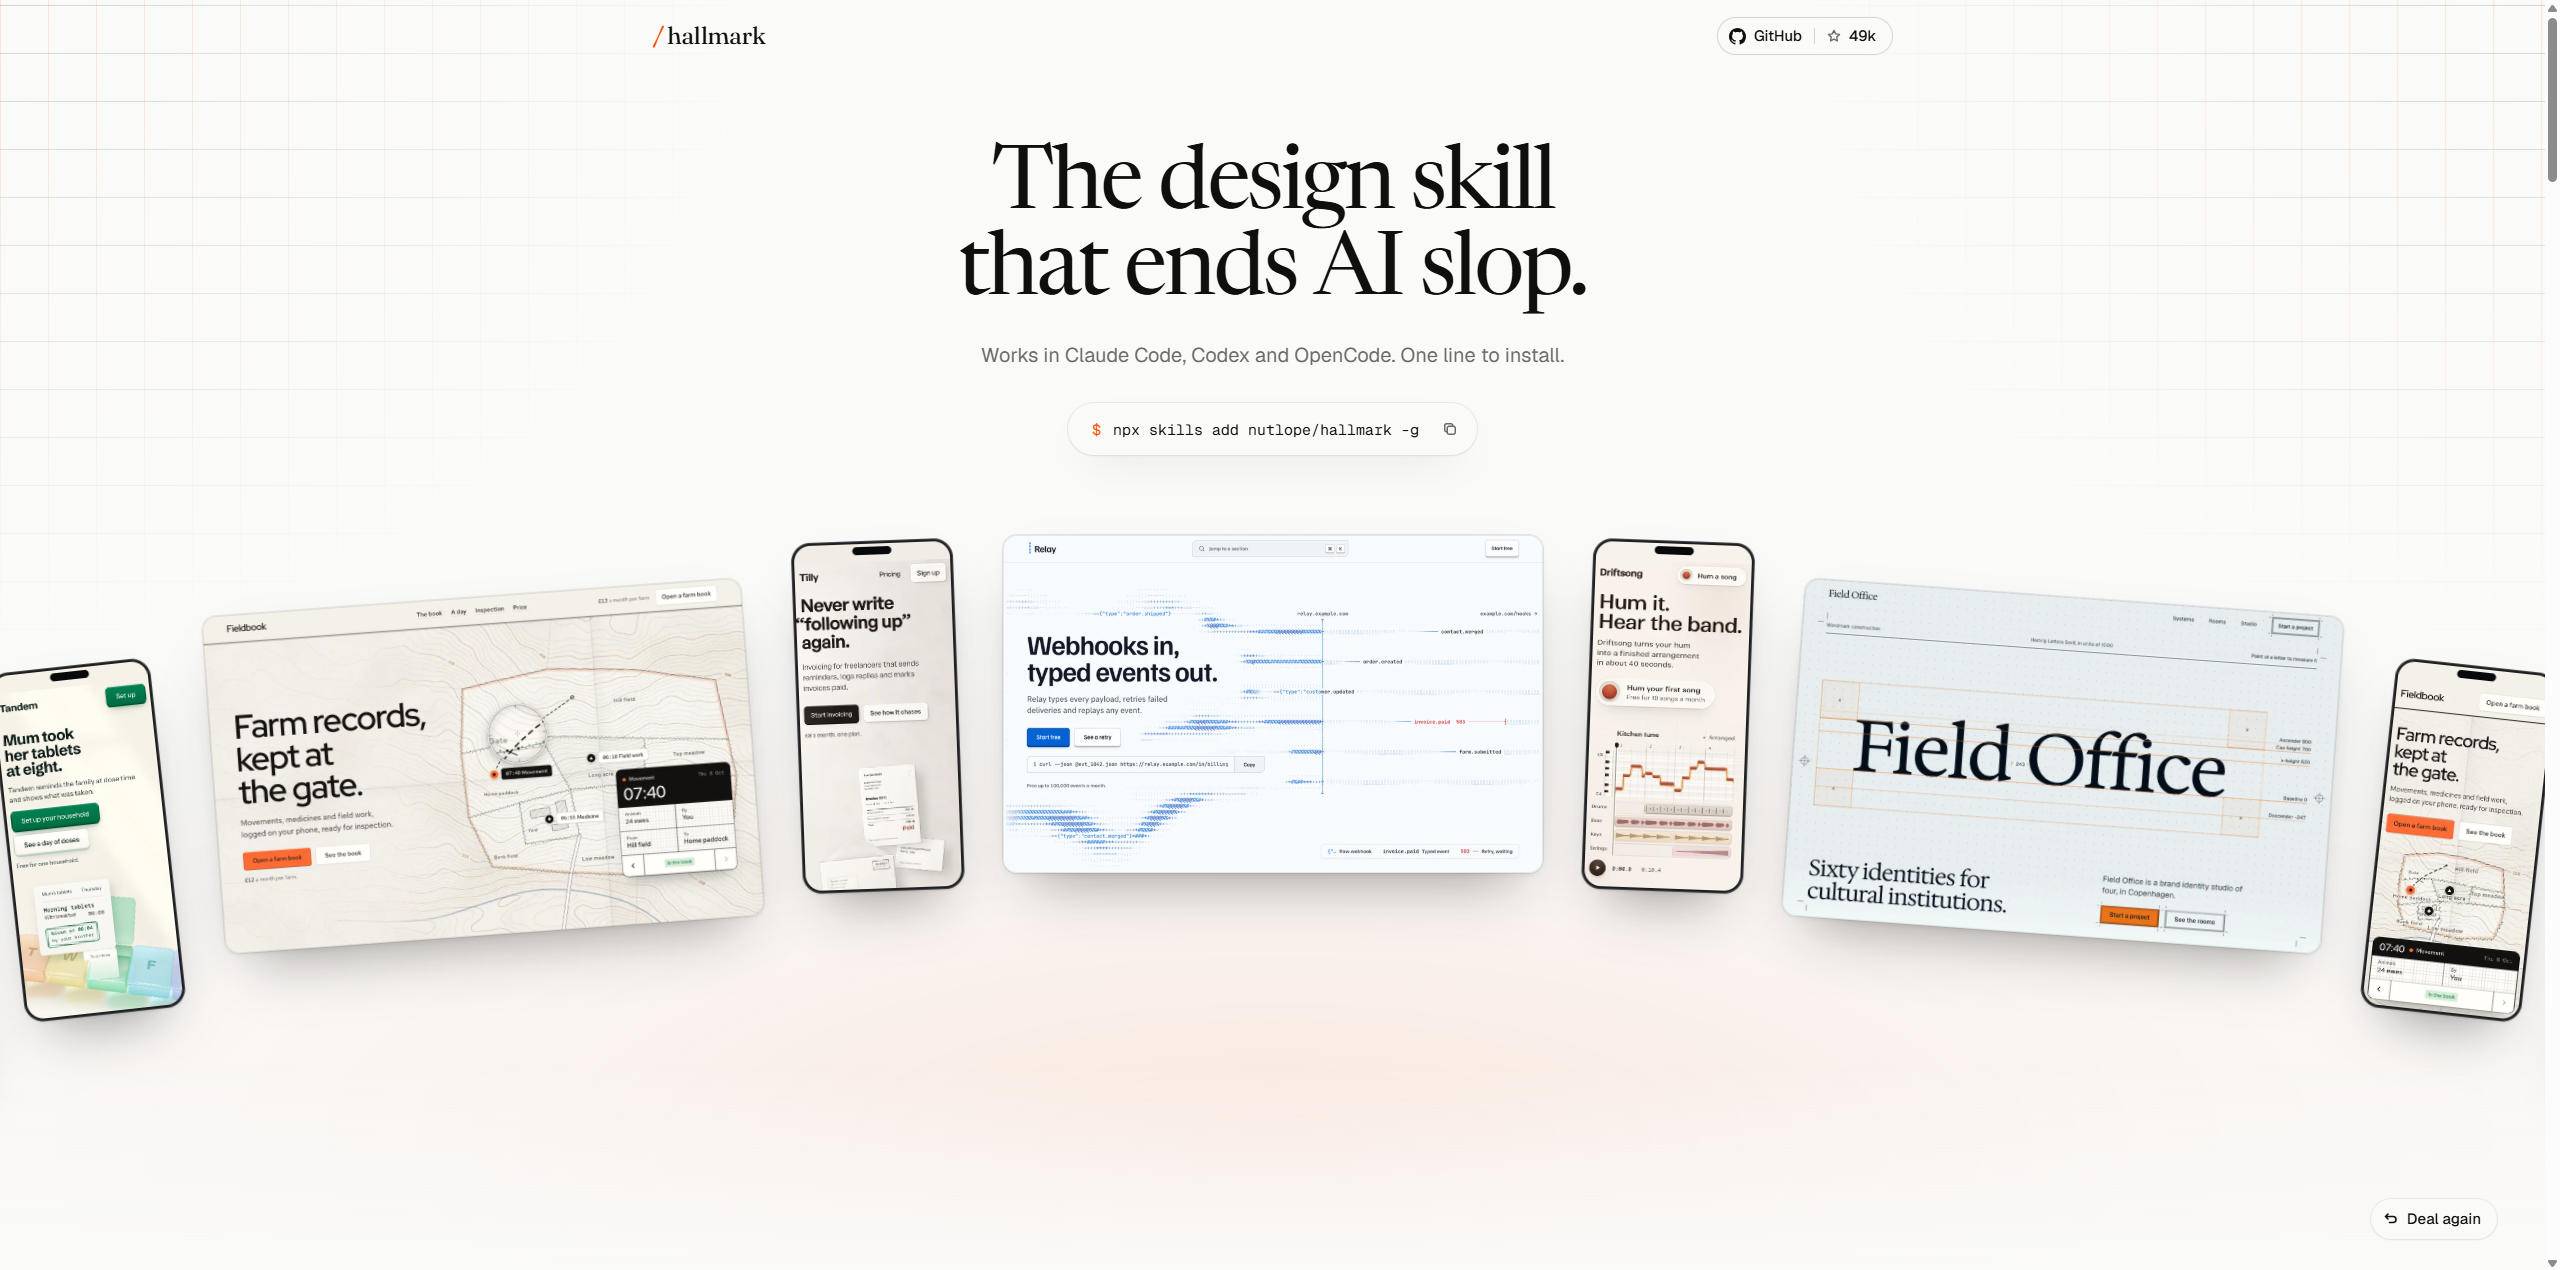
它的形态和多数 skill 不一样。没有组件库,没有模板包,没有运行时依赖。skill 本体 154 行,围着它摊开的是 151 个参考文件、50 套主题、21 种页面骨架、一个 231KB 的单文件 linter、一个 755 张图的照片库,还有一整套把评测写进仓库的脚本。154 行对 151 个参考文件,这个比例本身就是设计宣言。
我读它的时候一直在想一件事:这么多规则,模型真的会读吗?后来在 Issue 区翻到一份第三方做的对照实验,编号 #74,答案比我想的难看,也比我想的有意思。
它到底禁掉了什么,那份实验又测出了什么?答案指向相反的方向,所以得分开说。接下来先把规则的形状摆出来。
它到底禁掉了什么
三层门禁是理解 Hallmark 的唯一入口。Floor 层 39 条,管正确性、可访问性、诚实和几条房规,一条都不许破。Reflex 层 48 条,是模型最爱掉进去的默认值,带理由可以在 CSS 注释里豁免。Finish 层 26 条,编号 F1 到 F26,只管手艺细节,报告,不拦路。
Floor 里最有意思的几条不是技术问题,是品味问题。不许在标题上方放一行小字当引子,不许把标签设成全大写加字距,不许用中点把 A、B、C 串成元信息,不许在标题里把某一个词单独染色,不许紫到蓝的渐变,不许卡片套卡片,不许拿 emoji 当图标。这几样恰好是大模型最稳定的输出习惯。
让任何模型生成落地页,它几乎必然给你 eyebrow、渐变按钮、三列图标卡、结尾邮件订阅。Hallmark 的解法是先把这些默认值在静态检查层面物理禁掉,然后才谈设计。规则表里每条都写了识别什么、怎么修,不是一句价值观。
第二层是主题系统。50 套主题,每套是一个材料而不是一个模板:纸、字体、颜色、表面、它自己的组件和纹理,旁边配一张成品页面截图。单个文件不超过 8KB,一次构建只读一个。theme.mjs 的 deal 按 prompt 抽三个候选,draw 按业务类型抽页面骨架,包括怎么开场、导航长什么样、行动按钮放哪、这次不用哪两种构图。
所以同一句 prompt、同一个主题,跑两次会得到两个不同页面。这不是运气,是 draw 带日志去重后的硬要求。主题只管材料,页面结构由业务动作决定,卖货的页面用卖货的结构,订阅的页面用订阅的结构。
这些环节不是散着跑的。SKILL.md 把它压成七步:读项目、问一次、定形、定方向、加载参考、出 Picks 块、构建并清扫。下面这张图是我按流程和门禁分层重画的,能看出外部输入只有三样。
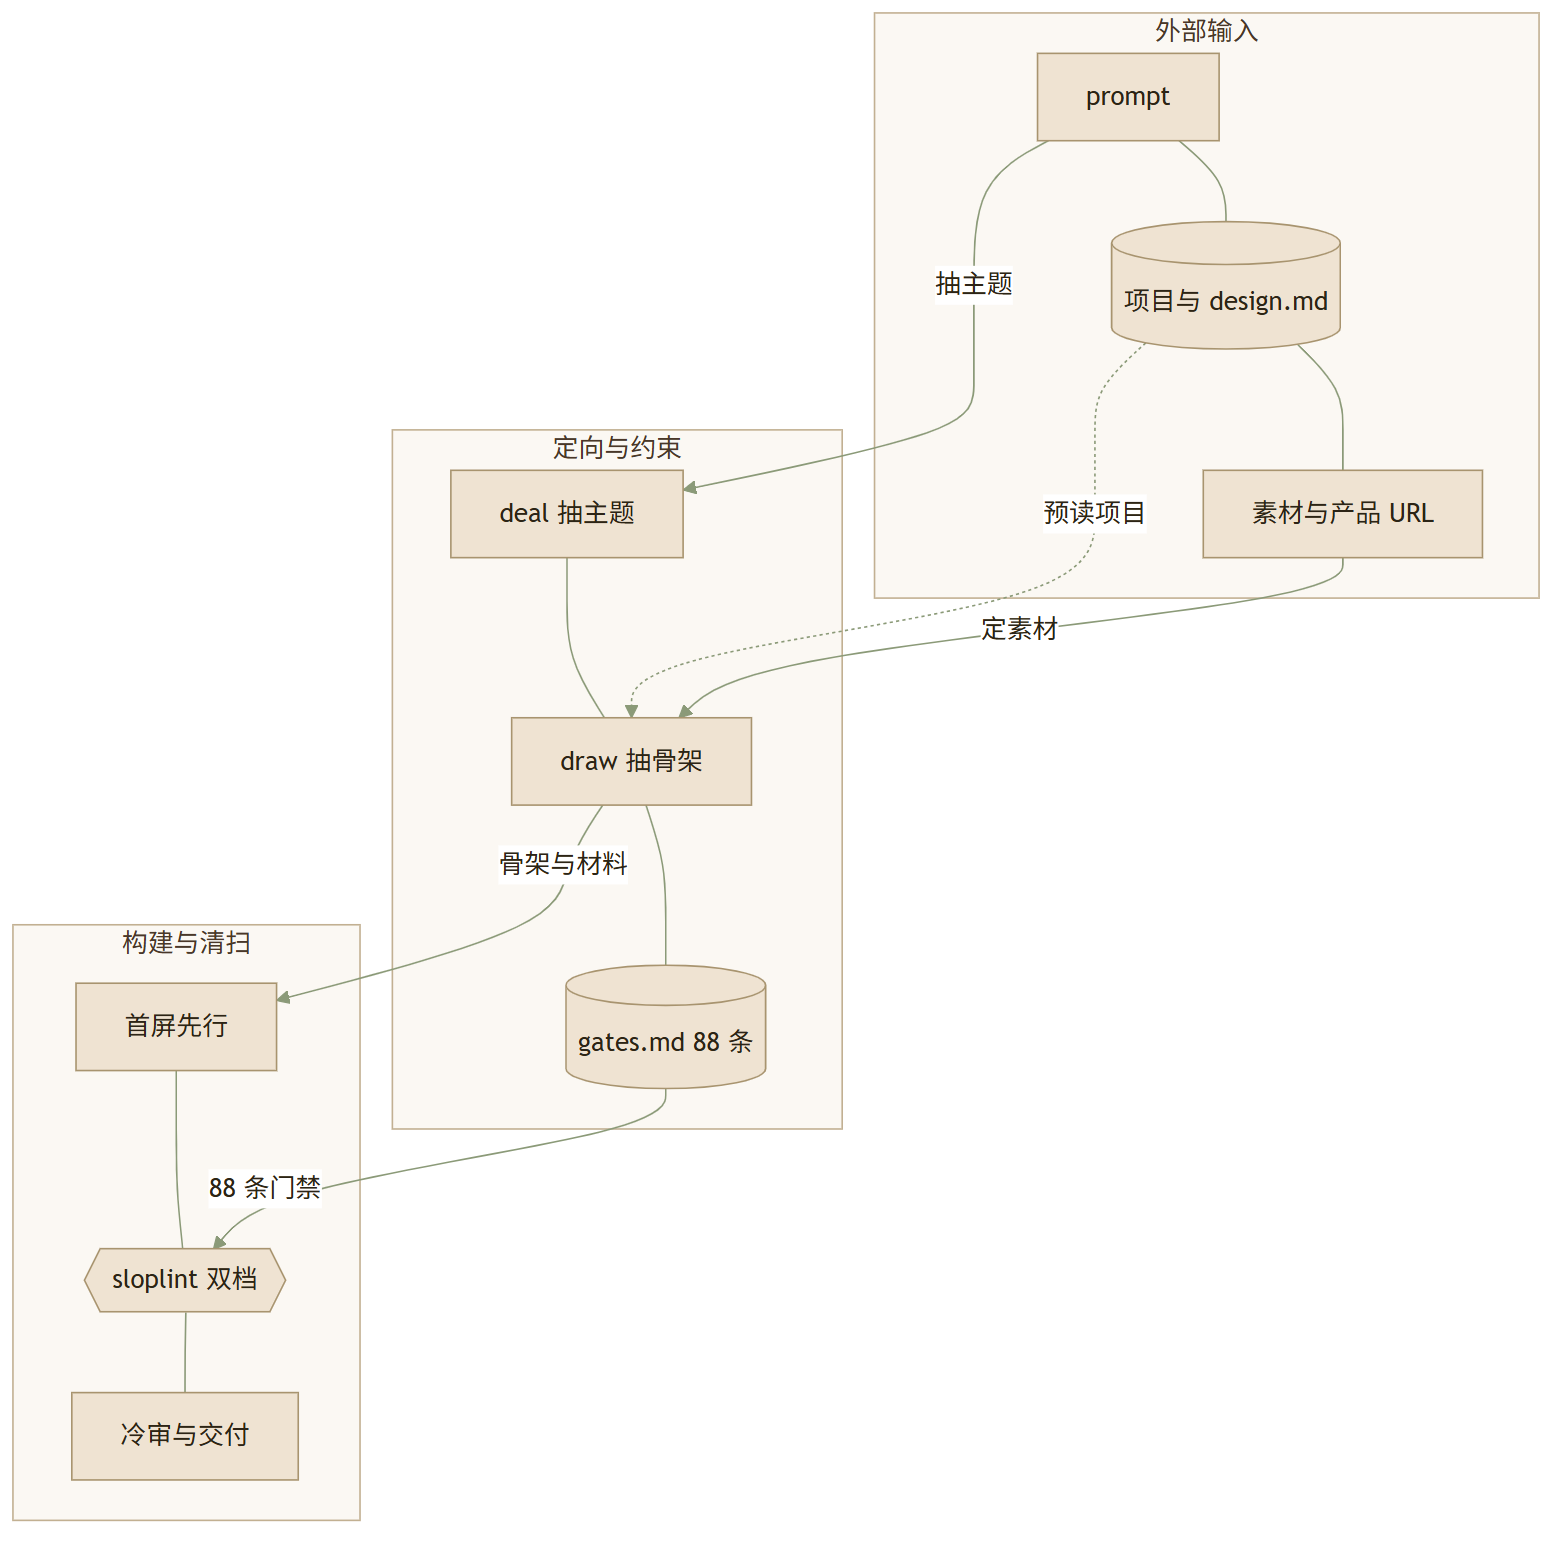
图里最关键的一处是第 7 步。清扫完成后,两个 fresh context 的 reviewer 接手,先审首屏再审整页,写页面的那条线程没有发言权。SKILL.md 给的理由只有一句:建这个页面的线程,是最差的审稿人。
第三层是 sloplint,231KB 单文件、零依赖,直接读 HTML、CSS、框架组件和 Tailwind 类名。加 –render 之后它真的开浏览器,在八个宽度上量:首屏在 1280×800 装不装得下标题、一句话和主按钮,对比度按文字背后的像素算,焦点环靠按 Tab 找,还查分区节奏、照片占页比例、文字被别的元素压住、手机版丢掉的内容。这套东西真正的贡献是把审美降级成可判定的几何。
还有一件事我在别的设计 skill 里没见过:评测被写进仓库。eval 目录有 8 个 brief、两档 harness、一个六轴视觉裁判、六条验收标准,其中 b4 专门诱惑模型编造指标,这一格过不过判定得很硬。
装上去,然后被它问四个问题
装它只要一条命令,Node 18 以上。浏览器档的检查(sloplint –render 和截图)额外要 puppeteer-core 和 Chrome,没装也能跑静态档。
npx skills add nutlope/hallmark -g-g 是装到全局,去掉就装进当前项目。只装一个 harness 就加 –agent 参数,或者走 Claude Code 的插件市场:
npx skills add nutlope/hallmark -g --agent claude-code
/plugin marketplace add nutlope/hallmark
/plugin install hallmark@hallmark
装完落地位置各不相同。Claude Code 落在 ~/.claude/skills/hallmark,Codex CLI 落在 ~/.agents/skills/hallmark,Cursor 和 OpenCode 会去这两处找现成的副本。想单独 lint 某个页面,跳过整个流程直接调脚本也行:
node skills/hallmark/scripts/sloplint.mjs ./index.html --render跑起来之后第一件事不是生成,是它问你四个问题:素材(截图、真实数字、真实引语)、受众、页面要驱动的唯一动作、语气。语气必须挑一个极端,干净现代不算语气。全部跳过也可以,回一句 go ahead,它会自己推断,并在顶部声明推断了什么。这个环节踩坑最多。
- Issue #76 记的是 npx skills add 只复制 skills/hallmark 目录,SKILL.md 里那几个 ../../ 外链装完就指向虚空,agent 打不开它被告知要去查的 tokens.css。这个 issue 到 10 月 27 日还有讨论,仍然开着。
- 当前版本的 SKILL.md 里那些 ../../ 已经不见了,改成 skill 内部自引用,说明结构重构顺手治好了它,但 issue 没人关,维护者没收尾。
装得上、跑得通,不代表它适合所有人。这套流程在什么场景下划算,在什么场景下反而是累赘?
什么时候该用,什么时候别指望
| 场景 | 典型用户 | 优势 | 局限 |
|---|---|---|---|
| 落地页、营销页、活动页的第一次成型 | 独立开发者、小团队 | 结构不撞车,视觉不掉档,交付即自包含 HTML | 要有素材,没图就跑不出真正的效果 |
| 已有页面重做系统与版式 | 前端、设计工程师 | redesign 保留全部链接与表单,丢一个就自己判失败 | 必须点名调用,静默不会触发 |
| 给 AI 产物做体检 | 用 agent 出活的团队 | 88 条规则可静态检查,能进 CI | 只查 tell,不查信息架构对不对 |
| 品牌站、编辑型长文页 | 内容团队 | 21 种骨架 + 50 套材料,编辑型题材覆盖最厚 | 品牌真值要自己喂,它拒绝凭记忆编 |
先说清楚它的边界:这是一个约束 skill,不是组件库。它不产出可复用的按钮、卡片、导航,产出是一份自包含的 HTML 加 CSS,第一行注释里盖着一份决策记录。想要组件资产,它帮不上忙。
它的定位也和同类不太一样。下面这张卡片把三个最常被放在一起比的项目拉到一张表上,数据都取到 2026 年 11 月 1 日。
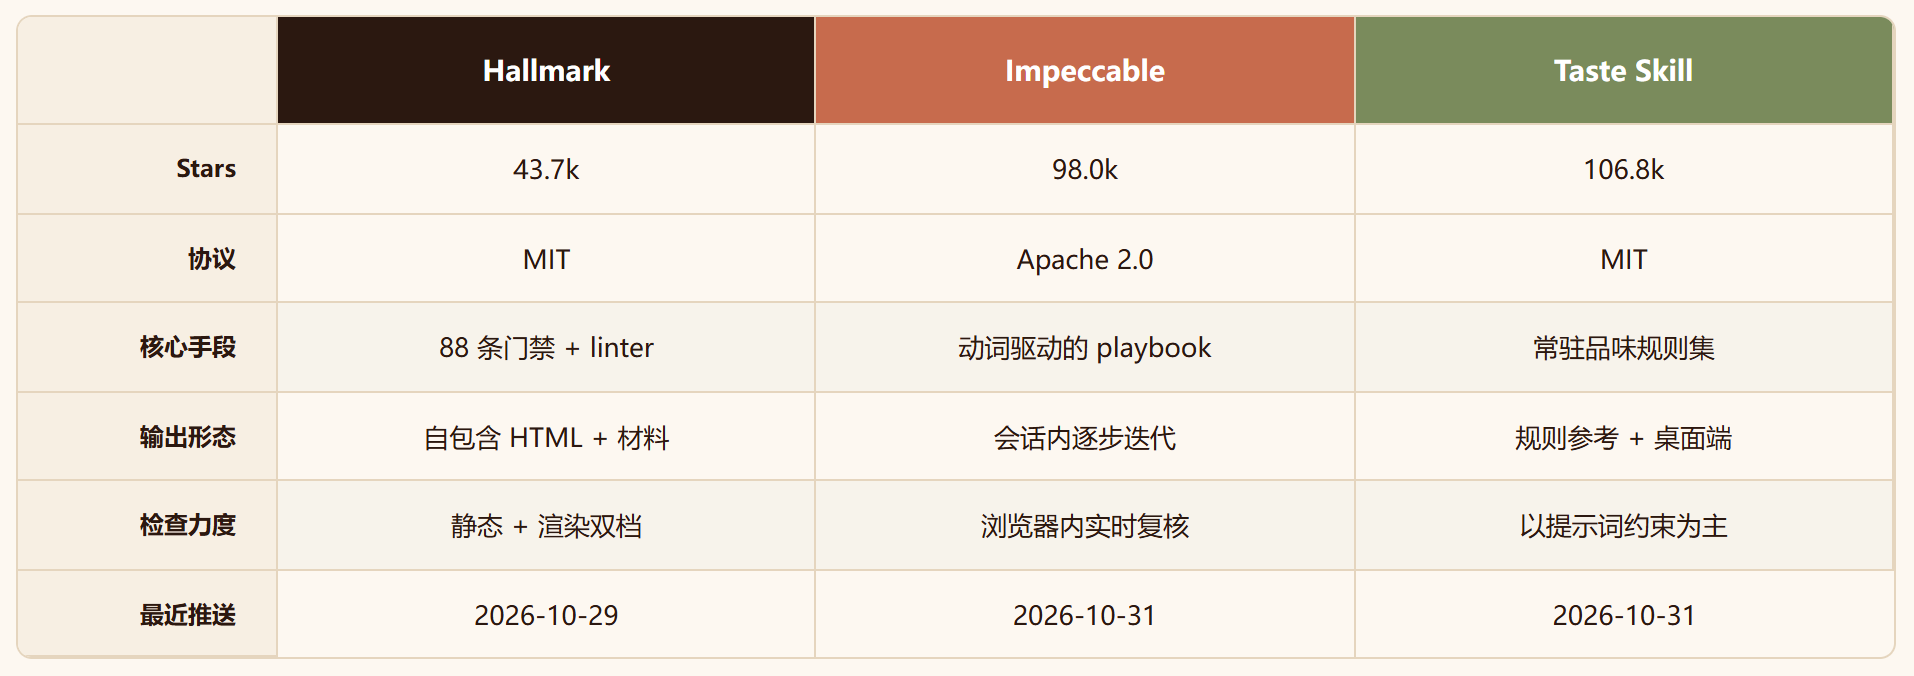
从表里能读出 Hallmark 的取舍:它的检查最重(静态加渲染两档,还要两次冷审),主题最具体(50 套材料各配成品图),代价是流程最重、最依赖素材。Impeccable 用动词驱动,polish、bolder、critique 一条一条下指令,轻。Taste Skill 把品味做成常驻规则集,覆盖面最广。三者不是替代关系,是三种不同力度的干预。
不适用的情况也得说清楚。你只是想让 agent 顺手把按钮改圆一点,用 Impeccable 的动词更快,走 Hallmark 会先被问四个问题。你要的是设计稿级别的像素还原,任何 skill 都替代不了人对着稿子调。你连一句文案、一张截图都没有,那再好的门禁也只能给你一个没内容的空壳。说完用法,得看是谁在维护它。
一个人写了 292 次提交
| 指标 | 数据 | 说明 |
|---|---|---|
| Stars | 43,678 | 截至 2026-11-01,10 月 27 日单日 +2,372 |
| Forks | 2,291 | Fork 与 Star 比 5.2%,属正常区间 |
| 核心维护者 | 7 人,其中 1 人 292 次提交 | Bus Factor 高风险 |
| Open Issues | 66 | 对比 10 月底仍在合并外部 PR |
| 协议 | MIT | 商业友好,可闭源衍生 |
| 发布 | 无 GitHub Release | 版本号写在 SKILL.md 的 frontmatter |
贡献者名单是这样的:Luffixos 292 次提交,作者本人 Nutlope 12 次,其余五人各 1 到 2 次。这个分布意味着项目的设计判断几乎全部来自一个人,而那 292 次提交里相当一部分是 site 目录和主题页的迭代。Bus factor 等于一,这是它最大的结构性风险,不是 Stars。
社区声音我挑两条能验证的。#74 的实验者写得很克制:“看起来是 SKILL.md 说了什么就被执行,藏在参考文件里的就没被执行。” #62 则是一份逐行照做后整理出的文档矛盾清单,作者说三步之内就撞上三套互相冲突的导航默认值。
趋势上它在往上走。10 月 27 日那波日榜流量之后没有回落,最后一行代码停在 10 月 29 日,v2 的五十套主题是同月铺完的。但要盯的不是星星,是那 66 个 open issue 的消化速度。
那份第三方实验,把话说得比 README 硬
说它的效果之前,得先看一份不是官方做的数据。Issue #74 是一次消融实验:同样四个 brief(开发者工具、面包店、设计工作室、一日会议),一组装 skill,一组不装,100 次生成,用确定性规则打分,不用 LLM 当裁判。
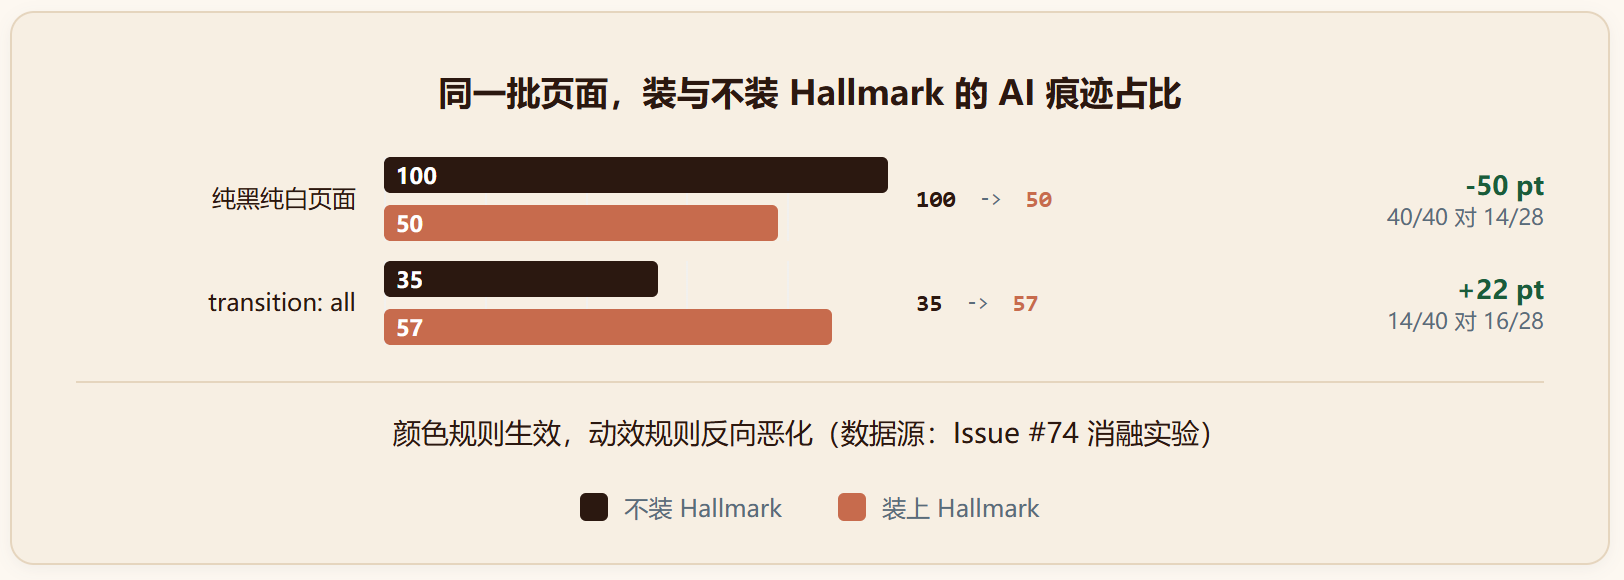
图里两条数据的方向完全相反。纯黑纯白的页面占比从 100% 掉到 50%,区间不重叠,这条是真效果。transition: all 的占比却从 35% 涨到 57%,方向反了,而且用的恰恰是 Hallmark 自己的时长与缓动 token。同一份规则,怎么会一边奏效一边反噬?
我对这份实验的评价是:它比官方 README 可信,因为它把自己不利的结论也写进去了。但它只测了一个模型(claude-haiku-4-5),样本 40 对 28,大模型上的表现可能不一样,作者自己也标了这条 caveat。
机制解释比数字更有用。实验者统计了参考文件的打开次数:macrostructures.md 被读过 3 次,anti-patterns 和 slop-test 一次都没被请求过。而 14 条检测项里有 12 条只定义在那两份文件里。这解释得通为什么颜色规则生效了(SKILL.md 自己讲了 token 系统),transition: all 反而恶化(它只活在参考文件里)。
第二条坑更硬:40 次带 skill 的尝试里有 12 次没产出任何页面,全部卡在问四个问题那一步。brief 里明明写了受众和用途,门禁还是问了。交互场景里这是一次多余的回合,在 claude -p、CI、批量跑的地方,这就是终点。30% 的产出是这么丢的。
第三条是触发问题。同样的四个任务,只用描述性 prompt(“读 brief.md,把里面描述的落地页做出来”),12 次里 skill 激活 0 次;点名 hallmark,40 次全中。SKILL.md 自己也认了这点,末尾写着如果它没自动触发,就点名。
所以我的判断是:这东西的价值不在 50 套主题,主题是糖。价值在那 39 条永不豁免的规则和一个能进 CI 的 linter,那才是别人抄不走也绕不过的部分。
更值得说的是它的方向。过去一年做设计 skill 的人都在拼“给模型更多灵感”,Hallmark 赌的是“给模型更少自由”。从纯黑白那条数据看,这个赌注成立了一半,另一半败在模型根本不去读参考文件。
先把它当 linter 用
如果你手上有素材、也要做一个新页面,从 /hallmark 加一句 prompt 开始,别先挑主题,让 deal 去抽,抽完你再看那三张成品图选材料。
如果你只是想治住 agent 那股默认味,别指望它整页接管。把 sloplint 单独接进流程,或者干脆把 gates.md 里那 39 条 Floor 抄进你自己的规范,成本低得多,收益也稳定得多。
要观望的话,盯两个数:66 个 open issue 多久消化完,以及那个 292 次提交的账号如果停手,还有没有人能接住 50 套主题的维护。这两个数决定它是个人作品还是能长期依赖的基础设施。
资源地址
| 资源 | 地址 |
|---|---|
| GitHub | https://github.com/Nutlope/hallmark |
| 官网与五十套主题 | https://www.usehallmark.com |
| 规则全集 | https://github.com/Nutlope/hallmark/blob/main/skills/hallmark/references/gates.md |
| 技能入口 | https://github.com/Nutlope/hallmark/blob/main/skills/hallmark/SKILL.md |
| 评测工具 | https://github.com/Nutlope/hallmark/tree/main/eval |