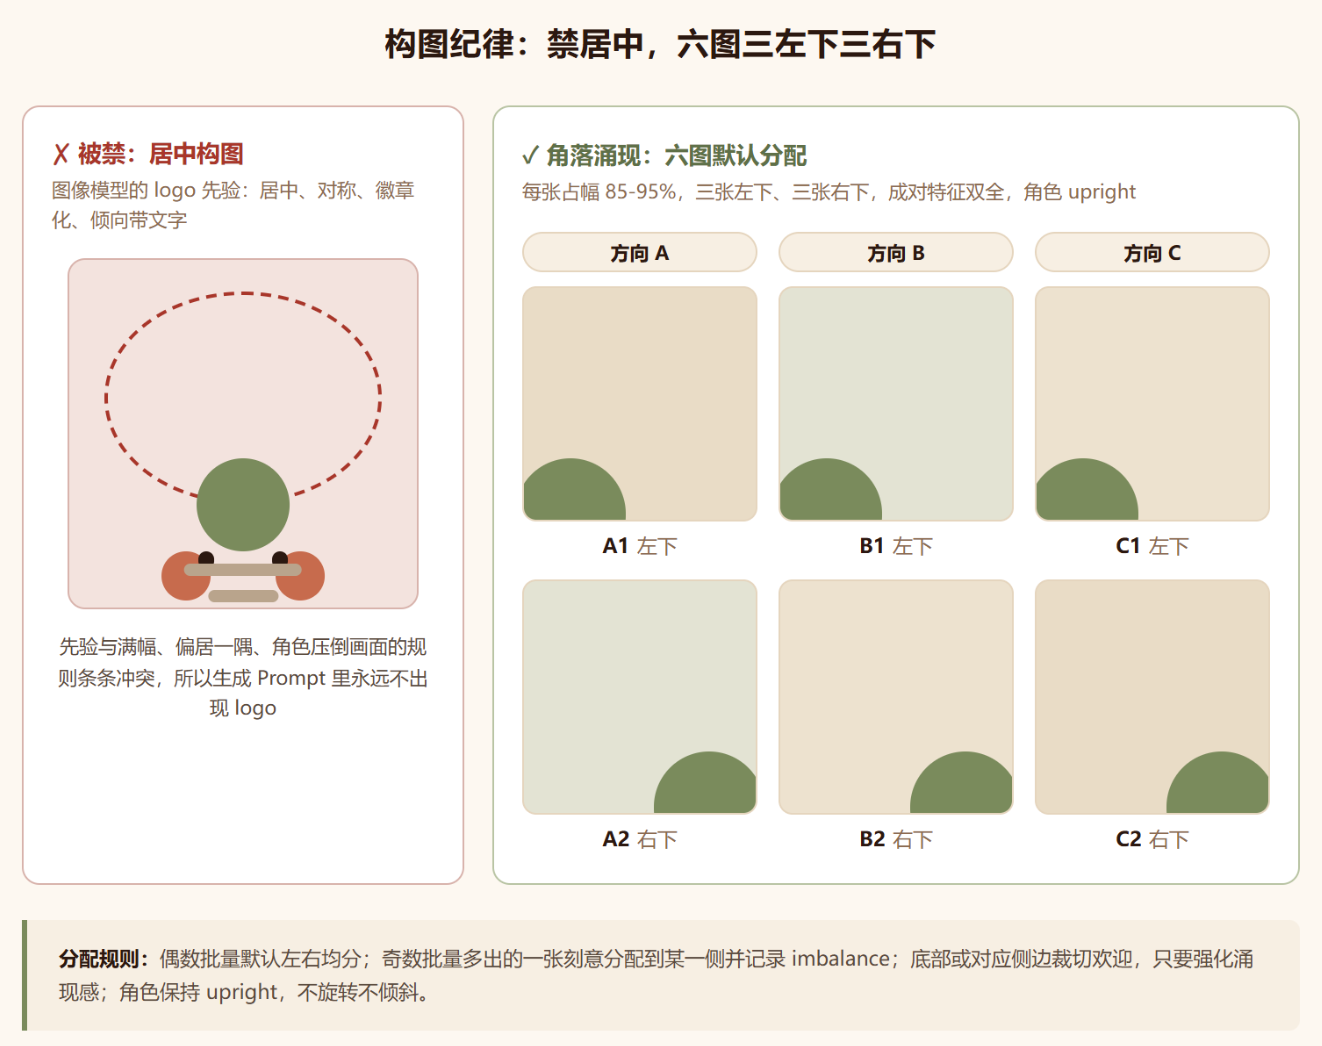
你让 AI 画个品牌吉祥物,它大概率还你一个居中的对称玩意儿,带点图标味。圆脸,正面,端端正正摆在画面中间,四周留一圈等宽留白。这不是模型笨,是 logo 这个词自带一坨强先验:要居中,要对称,要徽章化,最好再来点文字。模型读到这个词,就把默认答案搬出来了。
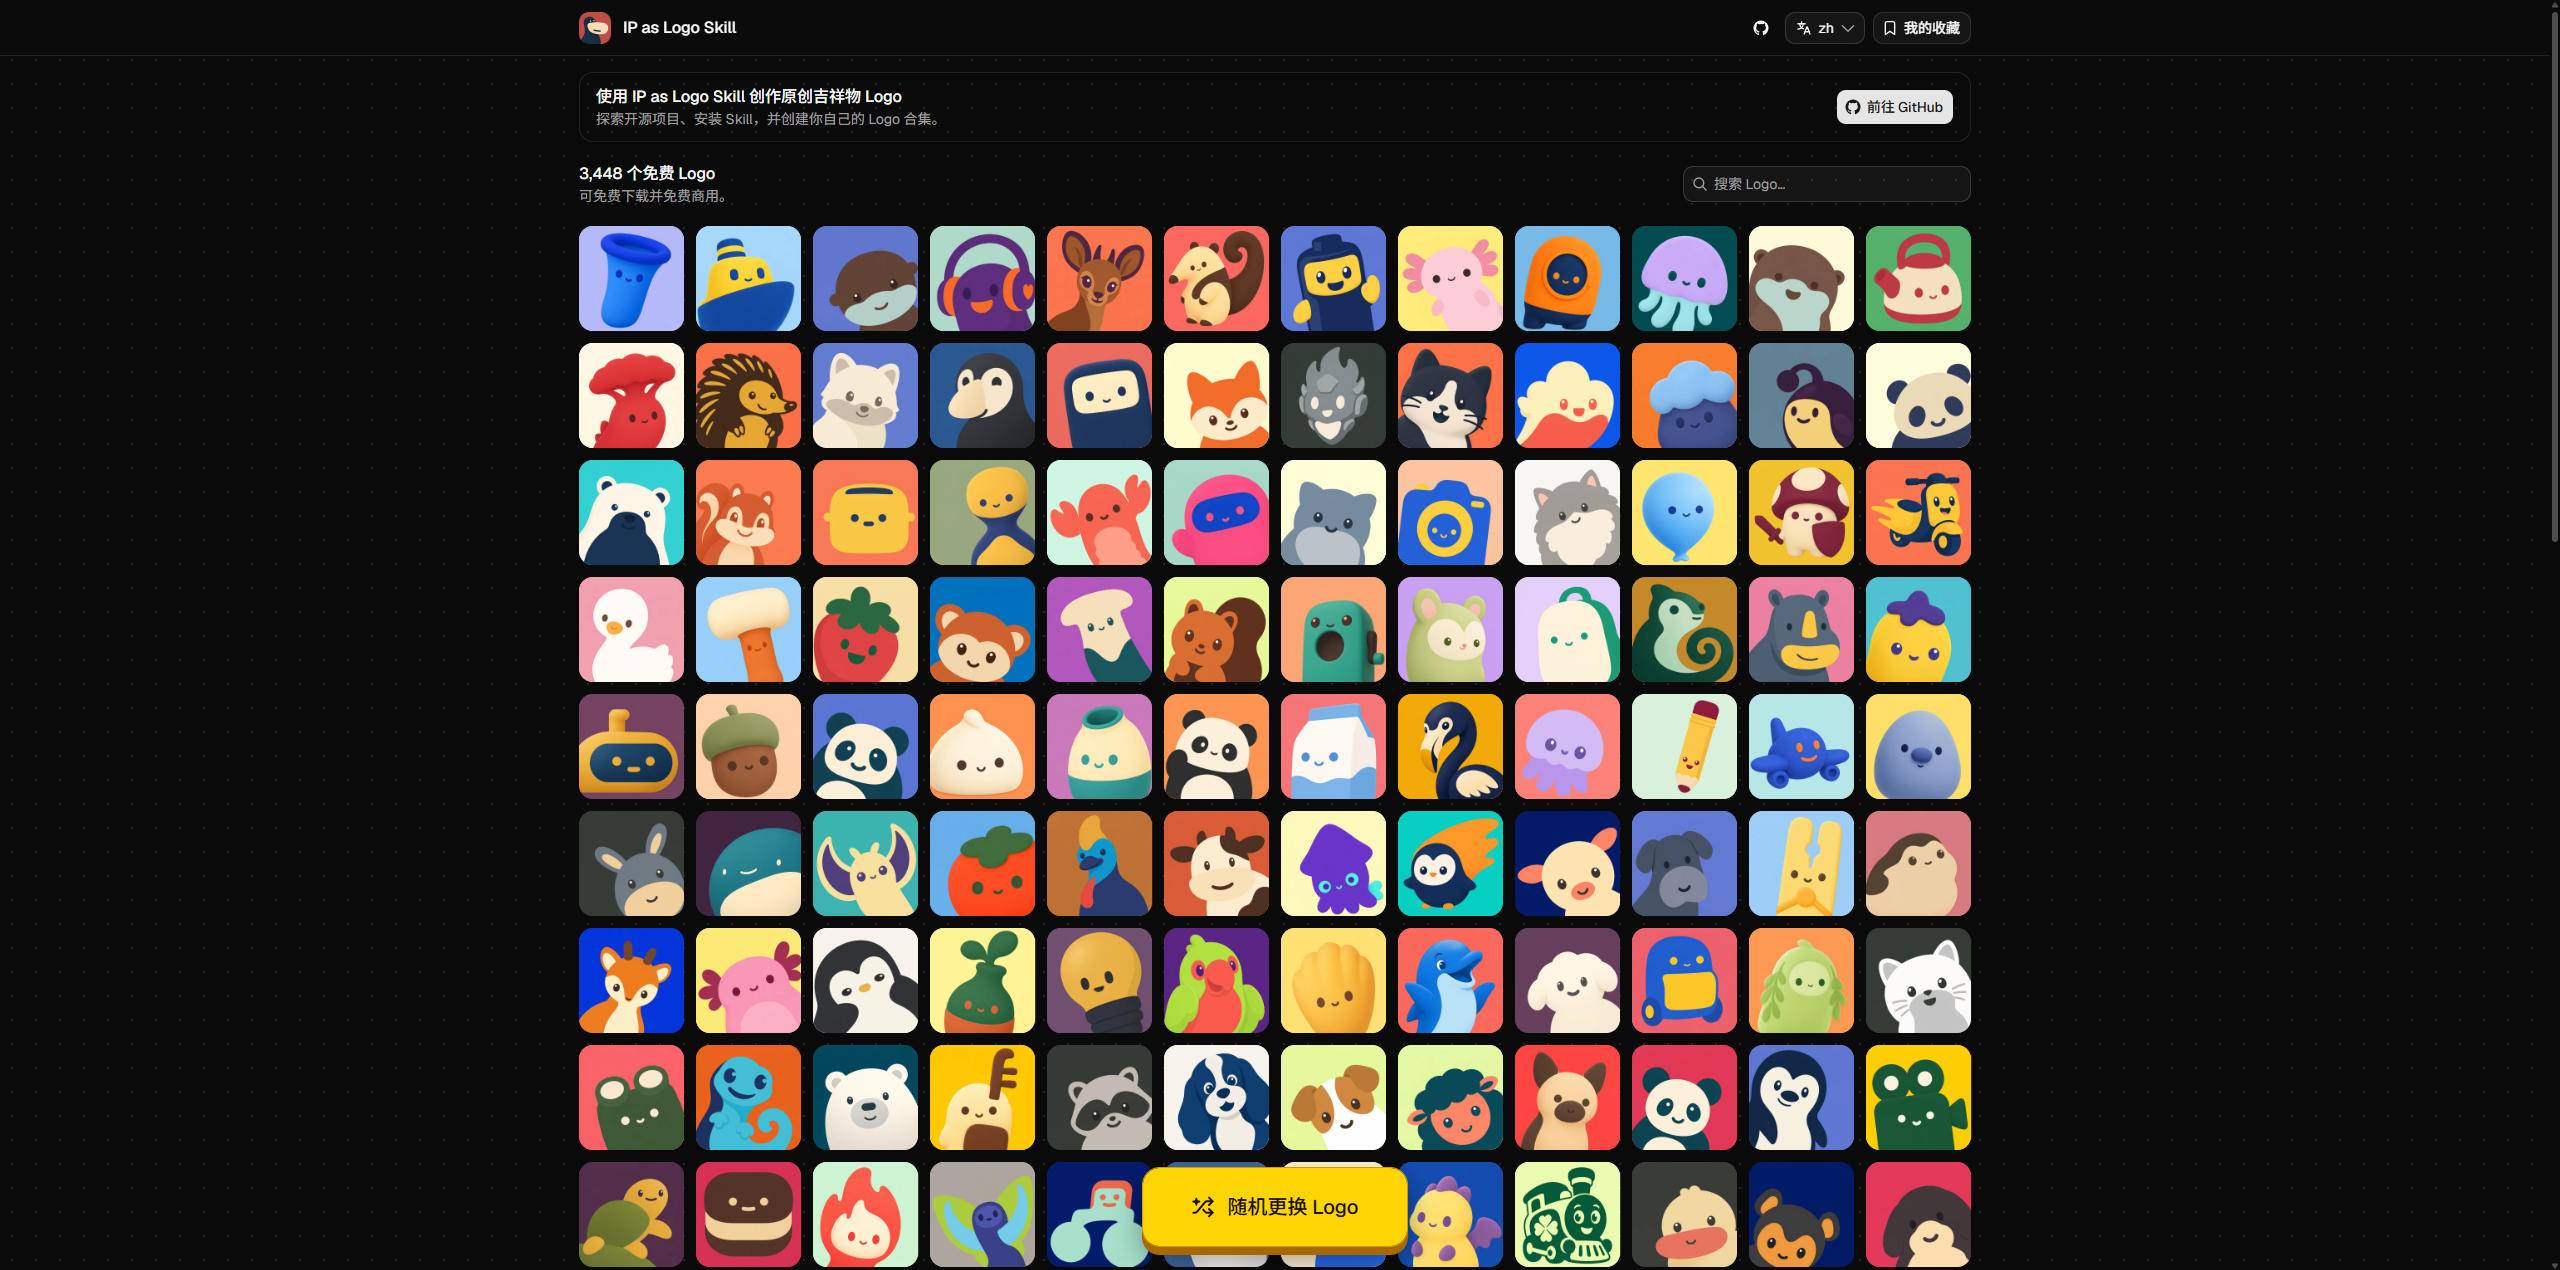
ip-as-logo 是 GitHub 用户 s1dashu 放出来的紧凑 Agent Skill,专治这件事。全部家当是一个 SKILL.md 加一张展示图,没脚本、没样式参考、没生成依赖。安装一行命令,主流编码 Agent 基本都认,官网还挂着一个免登录的素材库,两手都备齐了。
我翻这份 SKILL.md 之前,以为又是一个画吉祥物的 Prompt 合集,堆一堆风格词和参数。翻完发现完全不是。它真正干的是划边界,几件事钉死:
- 一个角色最多用几个大形状,什么特征只算一个
- 整张图几个颜色,各归谁管
- 角色从哪个角涌出来,占画面多大
- 什么词绝对不许出现在生成 Prompt 里
它的核心判断可以一句话说完:图像生成是抽奖,Skill 的工作不是提高中奖率,是控制奖品的结构。约束型 Skill 才是 Agent 时代真正稀缺的货,我在 nuget-manager 那篇里说过类似的话,这里再说一遍,因为它更极端:那边管的是文件写入路径,这边管的是模型的先验。
使用场景
安装走 Agent Skills CLI,一行:
npx skills@latest add s1dashu/ip-as-logo-skill安装器识别仓库根目录的 SKILL.md,让你选一个支持的 Agent,把整个 ip-as-logo 目录连带资源装进去。想跨项目个人使用,加 –global。装完直接说人话就行,比如“创建一个极简可爱的幽灵 IP 角色,深蓝纯色背景”。默认连色彩模式都不问,除非你明确要控颜色。
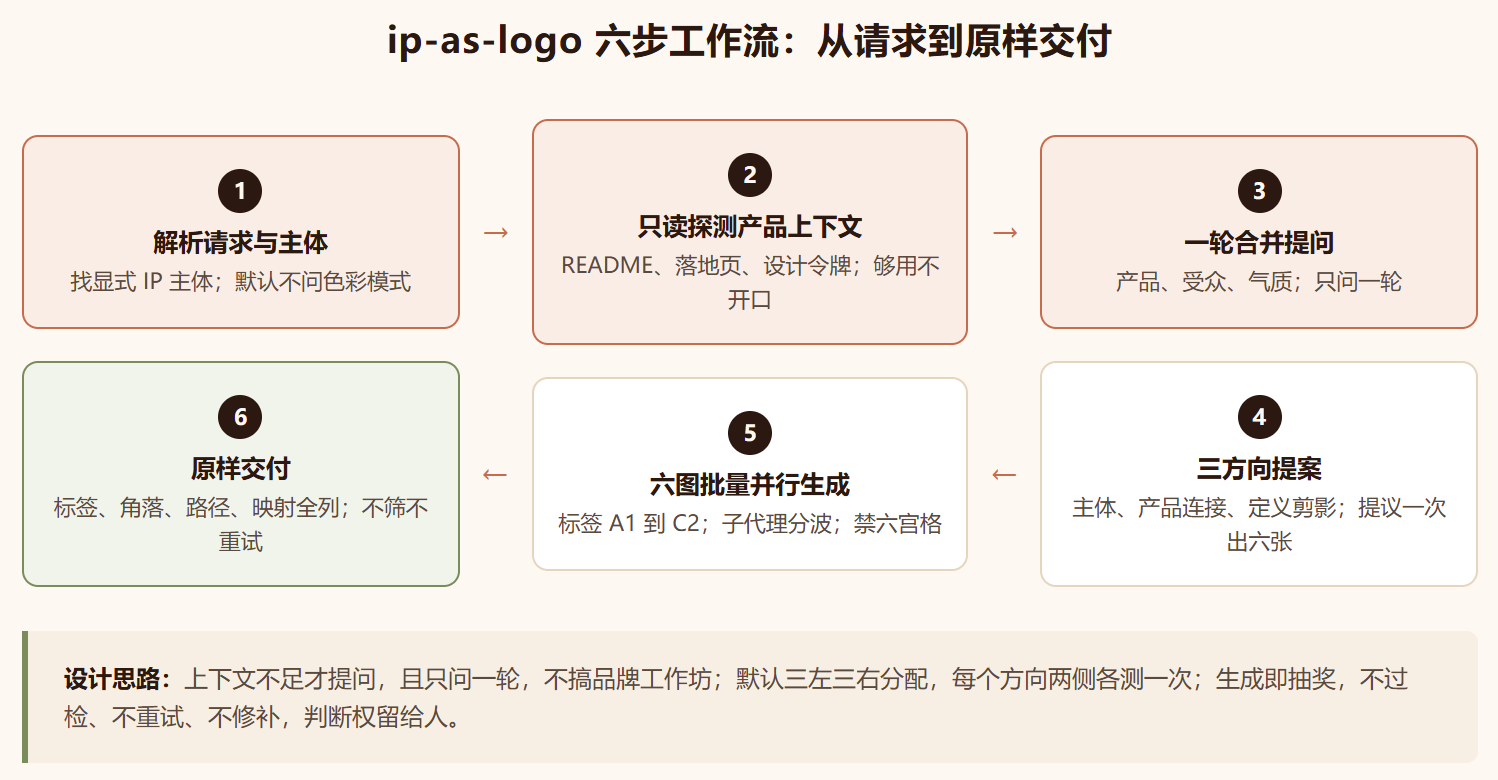
工作流值得完整走一遍。你没指定主体,当前又是个产品仓库,它先只读翻上下文,从 README 到落地页文案,从包元数据到设计令牌,够用就不开口。不够,问一轮合并问题:产品做什么,服务谁,该是什么气质。只问一轮,不搞品牌工作坊。
上下文够了,给三个方向。你指定了主体,三个方向就是同一个角色的三种设计处理,换个剪影、换个副色区、或者换个性格侧重,每次都从不同角度切。没指定,三个方向是三个不同的主体或隐喻,每个绑一条产品属性或品牌承诺,不随便扔三只动物上来。开放批次里九成五以上的候选得是熟悉动物,猫狗兔子仓鼠这一档。冷门生物和幻想物件不行,抽象机器和工业器具也不行,没有明确产品理由,一律不上。
每个方向一行写清三件事:IP 主体、产品连接、定义剪影。写完直接提议一次生成六张,等你点头,或者你的请求里已经授权了六张,它才动笔。
确认之后按规则分配。三个方向全收,一次出六张,标签从 A1 排到 C2,每个方向两张变体,首张从左下涌现,次张从右下涌现,天然三左三右。只选一个方向,就是 A1 到 A6,奇数左下偶数右下。你嫌数量或分布不对,听你的,它不争论。
运行时支持子代理就并行生成,并发不够分波,每张都是独立的全分辨率方图,明确禁止让模型拼六宫格交差。生成结束要交账,每张图的信息列全:
- 标签与方向理由
- 分配的涌现角落
- 保存路径与最终尺寸
- Prompt 与色彩的对应关系
它不管的事同样清楚:不查透明度,不分类候选合不合规,不自动重试,不后处理修补,永不回落 SVG。要改可以,你明确说了再画。
技术架构与设计决策
说是架构,其实是四组硬约束。
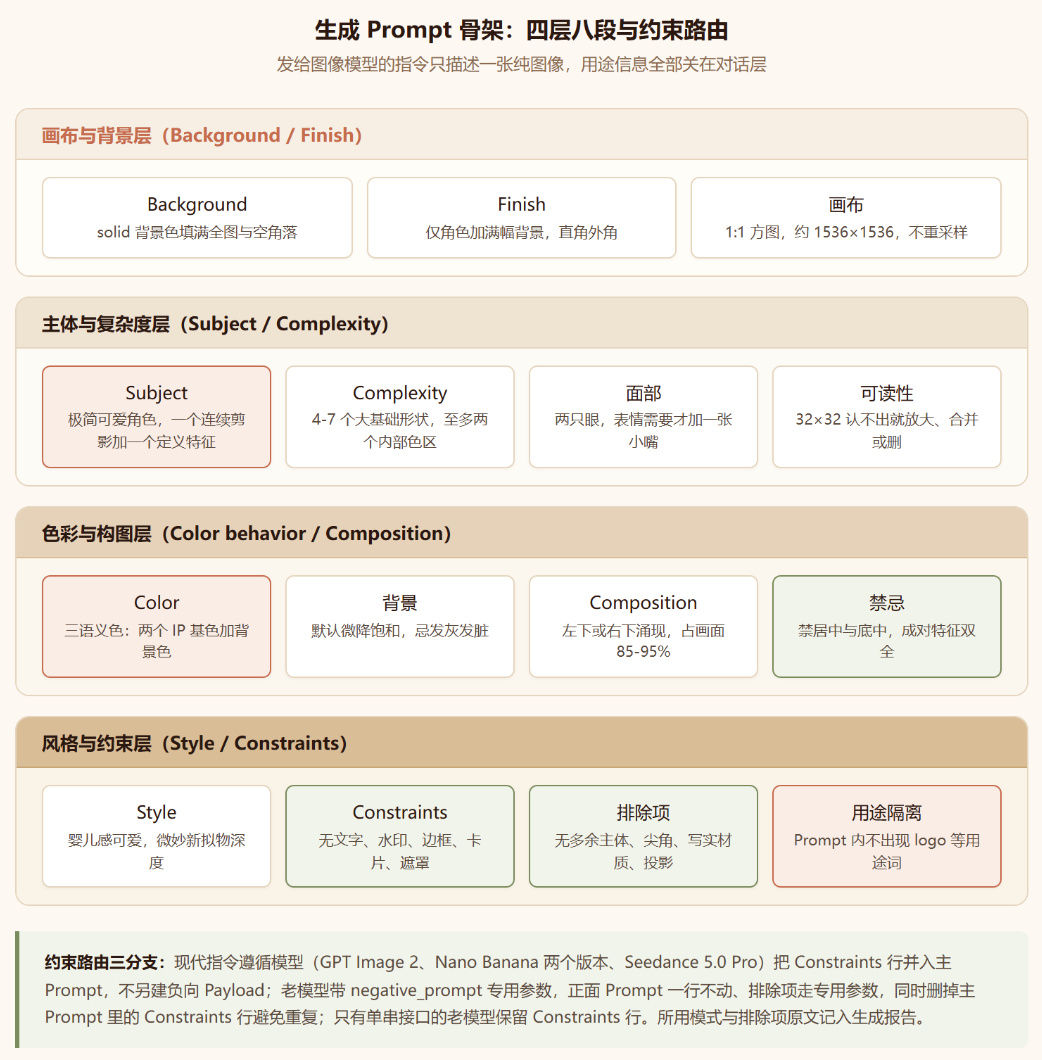
复杂度预算打底。一个主导连续剪影,大约四到七个大型基础形状,不承载身份、表情或识别度的形状,删。至多一个物种定义特征,一对弯角或一个宽面罩都算一个。至多两个大内部色区,脸只允许两只眼,表情需要才加一张小嘴。剩下的全砍:
眉毛、高光、鼻孔、纹理、描边、装饰标记
重复的羽毛、鳞片、毛簇、甲片、纽扣、螺丝、数字、标签
砍完拿 32×32 卡一眼。认不出的特征,放大、合并或者删掉,三条路自己选。这一条是整个预算的锚,后面细说。
色彩纪律。默认整张图正好三个语义色,两个 IP 基色加一个背景色。面部标记复用 IP 色,不引入新色。用户给了背景色板,背景全从色板出,主体两色独立选。没给,就轻微降一点背景饱和度,要克制,要干净,要有意识,不要发灰发脏。Prompt 里直接点名背景色,让它填满所有开放区域和空角落。opaque、alpha、transparency 这类图像模式词明确禁用,免得把模型注意力带偏。
构图。角色 upright,从左下或右下涌现,占画面 85% 到 95%,永远不许居中或底中。底部或对应侧边可以裁切,只要能强化涌现感,但不规定具体裁多少。画布 1:1,外角直角,请求约 1536×1536,服务端只给 1254×1254 也照单全收,绝不为了凑数字重采样。
生成指令与用途隔离,这是我最欣赏的一条。发给图像模型的 Prompt 里永远不出现 logo,brand mark、app icon、icon asset 这几个词也一并拉黑,更不预铺任何暴露用途的元数据。这条只约束生成 Prompt,你和 Agent 的对话,还有 Skill 的名字,照常说 logo 没问题。
为什么这一条这么关键?回头看模型的先验:要居中,要对称,要徽章感,最好再来点文字,跟这个 Skill 的构图规则几乎条条冲突。你要的是满幅画面,偏居一隅,角色压倒一切,嘴里冒出 logo 这个词,模型就把你往它的默认答案上拽。把用途信息全关在对话层,生成指令只描述一张纯图像,两边的干扰就隔开了。这不是文字游戏,是 Prompt 分层,用途归用途,绘制归绘制。
约束怎么送也分了路。现代指令遵循模型,GPT Image 2 算一个,Nano Banana 的 Pro 和 2 两个版本算一组,Seedance 5.0 Pro 算一个。这一代模型,完整正面 Prompt 里带一行自然语言 Constraints 就行,不另建负向 Prompt。老模型或运行时如果有 negative_prompt 专用参数,正面 Prompt 一行不动,最小排除项走专用参数,主 Prompt 里反而要删掉 Constraints 行,避免同一个排除说两遍。只有单串接口的老模型,保留那行 Constraints。用哪种模式、排除项原文是什么,记进生成报告。
老参数那套最小排除项长这样:
text, watermark, borders, frames, cards, presentation masks,
extra subjects, scenery, thin fragile lines, sharp tips,
photorealistic materials, strong three-dimensional rendering,
external cast shadows
模型前置也有门禁。首选 GPT Image 2,一个都没有就问用户开工具或给 API key,永不回落 SVG,换别的图像模型必须用户明确同意,且提前告知质量可能不匹配。也不许编造生成结果。
洞察与反思
这条 Skill 最反直觉的地方在交付行为:生成即抽奖,不过检。每张候选只生成一次,原样返回。透明度不查,背景不挑,颜色不挑,构图不挑,渐变阴影立体感一概不论。不分类推荐或不推荐,不自动重试,不后处理修补。
我一开始以为这是懒。翻到 Model behavior 那段才想明白,合规在这里本质是审美判断,审美判断写不成退出码。你写背景必须纯净,模型怎么理解纯净?你写构图必须饱满,85% 和 95% 哪个对?规则钉得死结构,钉不死品味。更现实的考量是成本和多样性,自动重试一次就是多烧一份积分,筛掉一半候选,六张变三张,每张都很安全,也很无聊。
三左三右的默认分配也是风险管理,不是审美偏好。下角涌现是整个 Prompt 里最激进的约束,模型翻车概率最高。六个候选分两侧各测一次,一侧画砸不至于全军覆没,拿批量换鲁棒性。
32×32 可读这条,是复杂度预算的锚,也是我最想偷走的设计。它把简单从一个形容词变成一个可判定测试:这个特征缩到 32 像素还在不在?不在就是噪音,放大、合并、删掉,三条路自己选。很多 Skill 也喊保持简洁,喊完就没了,因为没有判定标准,模型根本不知道该删什么。有个具体数字卡着,减法才落得下来。
暗坑也有五处,按扎心程度排:
- 重度依赖顶级图像模型,没有就开工具或掏 API key,成本实打实
- 纯指令文件零脚本兜底,约束生效全看模型指令遵循能力,换弱模型可能大面积失守
- 随机性无保证,一批里出一两张离谱的是设计内损耗,稳定产出得接受反复抽
- 产出是方图位图不出 SVG,品牌落地要矢量得另外转
- 用途隔离只保护 Skill 内部 Prompt,绕过 Skill 直接喊画个 logo,先验照旧
几条路线放在一起,差异比想象中大:
| 维度 | ip-as-logo | 直接让 AI 画 | 传统设计工具 | 通用 Logo 生成器 |
|---|---|---|---|---|
| 构图控制 | 下角涌现,禁居中 | 模型先验说了算 | 全手动 | 模板居中 |
| 简洁度判定 | 32×32 加形状预算 | 无 | 靠设计师自律 | 模板化简洁 |
| 色彩 | 三语义色纪律 | 随机 | 品牌手册 | 固定配色 |
| 结果处置 | 原样交付,不筛不重试 | 随手挑 | 人工迭代 | 自动但同质 |
| 主要成本 | 顶级模型 API | 同左 | 设计师时间 | 订阅费 |
| 产出物 | 方图位图 | 位图 | 矢量 | 位图为主 |
直接让 AI 画和 ip-as-logo 之间差的那几列,就是约束两个字的含金量。后两列提醒另一件事,它不是设计工具的替代品,是设计流程里从零到一一棒的加速器,方向定了之后的事它不管。
顺带一提它的分发。作者还挂了个网站 ipaslogo.com,Cloudflare R2 加 Supabase 撑的可搜索素材库,没有 Codex、Doubao、Coze 或 WorkBuddy 的人直接下载现成 logo,全部免费商用。Skill 给有 Agent 的人,网站给没有的人,一个仓库两头堵,这个分发思路比 Skill 本身还值得学。
资源地址
| 资源 | 链接 |
|---|---|
| GitHub 仓库 | https://github.com/s1dashu/ip-as-logo-skill |
| 官方网站 | https://ipaslogo.com |
| 安装命令 | npx skills@latest add s1dashu/ip-as-logo-skill |
| 兼容 Agent | Codex、Coze、Doubao、YouMind、Manus、Gemini Apps、Replit Agent |
| 推荐图像模型 | GPT Image 2、Seedance 5.0 Pro、Nano Banana Pro、Nano Banana 2 |
| 开源协议 | MIT |
总结
如果你手上有不错的 Agent 加顶级图像模型,平时又需要给产品、活动或独立项目整点像样 IP 形象,装上它,成本一行命令。回报不是画得有多神,是一致性,形状数量,颜色数量,构图位置,全在框里,一批六张摆在一起像一家人。
反过来的情况也明确:指望它出矢量、出成套品牌规范、每次都给稳定神图,别用。它只管从零到一那张满幅方图,管完就撒手。
说到底装不装是次要的,真正该学的是写法。用途和绘制要分开,别让模型的先验污染生成指令。简单要改写成可判定测试,32×32 认不出就删。审美判断留给人的时候,别建闸门,建流程。这三条放在任何图像类 Skill 上都成立。