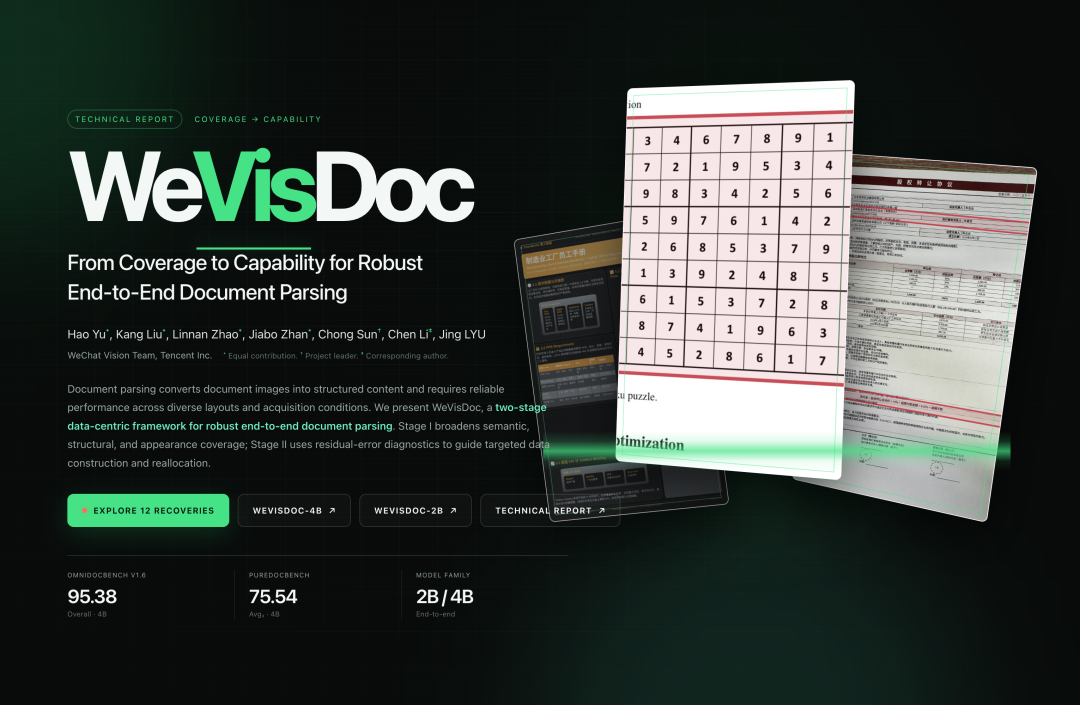
腾讯微信视觉团队(WeChat Vision)近日发布并开源WeVisDoc,一套面向端到端文档解析的模型与两阶段数据构建框架。基于该框架训练的 WeVisDoc-4B,在 OmniDocBench v1.6 上取得95.38的 Overall 分数;在 PureDocBench 的 Clean、Digital Degraded 和 Real Degraded 三条赛道平均得分为75.54。
除评测结果外,这项工作还思考了文档解析模型的数据与能力覆盖问题:如何区分”缺少可学习数据”与”已有数据曝光不足”,并在有限训练预算下组织更有针对性的补充与配比。
围绕数据与能力覆盖的两阶段设计
端到端文档解析需要同时处理文字识别、元素类型、结构层级和阅读顺序。真实文档还会受到语言、版式、内容密度、扫描质量、拍摄角度和屏幕翻拍等因素影响。仅扩大数据来源和增强类型,可以拓展数据覆盖面,但不一定能够说明模型仍缺少哪类能力。
WeVisDoc 采用两阶段数据建设方案:Stage I 通过广泛的数据覆盖与数据增广,扩充模型的基础能力;Stage II 再借助独立诊断探针识别残留弱项,并针对性补充难例、合成数据和优化采样。
| 阶段 | 目标 | 数据规模 | 主要动作 |
|---|---|---|---|
| Stage I:广覆盖建设 | 建立尽可能宽的训练支持面 | 约 4000 万条 | 整合异构来源,统一结构标注,并进行结构保持的视觉退化合成 |
| Stage II:诊断与定向补强 | 识别残留弱项并分配训练资源 | 约 500 万条 | 通过独立探针、固定聚类簇与分项误差,组织难例、定向补充和残差感知采样 |
Stage I:广覆盖建设
Stage I 覆盖内容领域、版式结构、语言文字与采集条件等多个维度。通过多样化的数据构建与广泛采集,提升模型对不同文档类型和采集条件的覆盖能力。
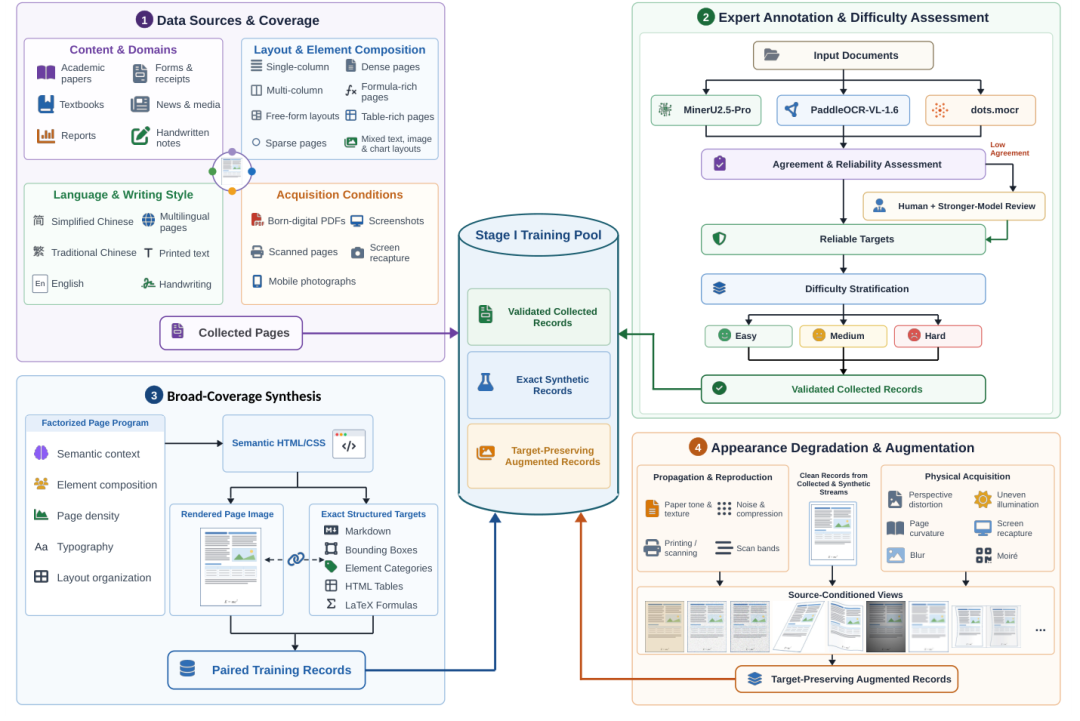
图1 Stage I 数据构建流程:多维度覆盖收集、专家标注与难度分层、通用合成和外观退化增强共同构成训练池。
外观增强采用结构保持的方式,让纸张纹理、扫描条纹、透视畸变、页面曲率和不均匀光照等变化影响视觉外观,但不改变原始结构化标注,从而将版式覆盖与视觉退化控制分离。
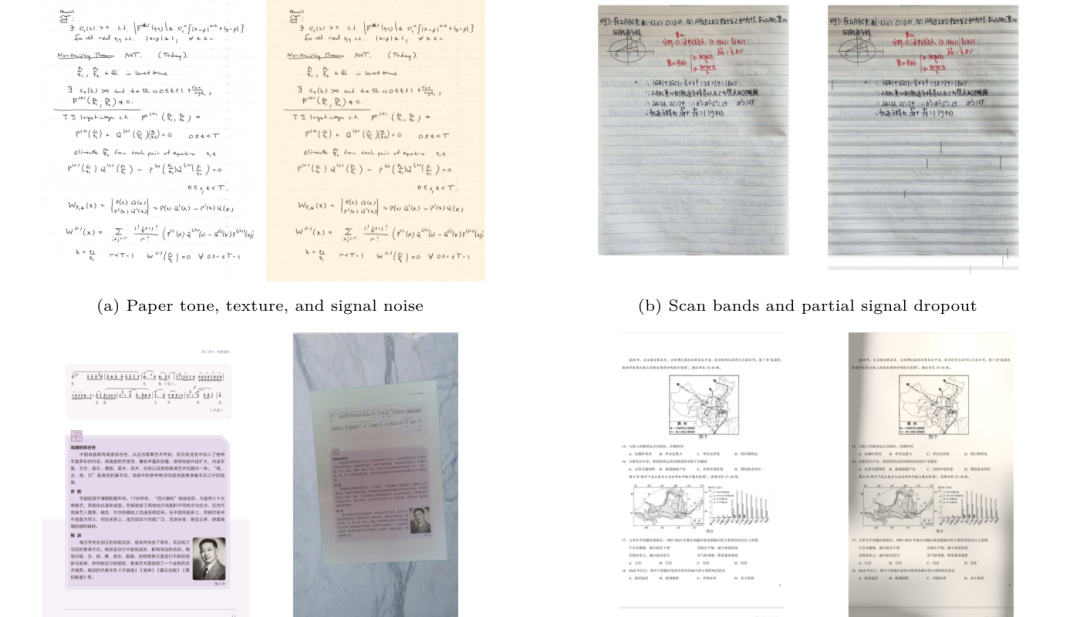
图2 代表性外观变换:纸张纹理与噪声、扫描退化、透视与手持拍摄、页面曲率与不均匀光照。
Stage II:诊断与定向补强
Stage II 采用独立于训练、难例挖掘和最终评测的诊断探针。该探针在固定的视觉—结构聚类簇中,分别评估整页转录误差,以及表格、公式和阅读顺序等分项误差。流程还会区分标注问题、解码退化、目标不可观测和真实能力缺口。
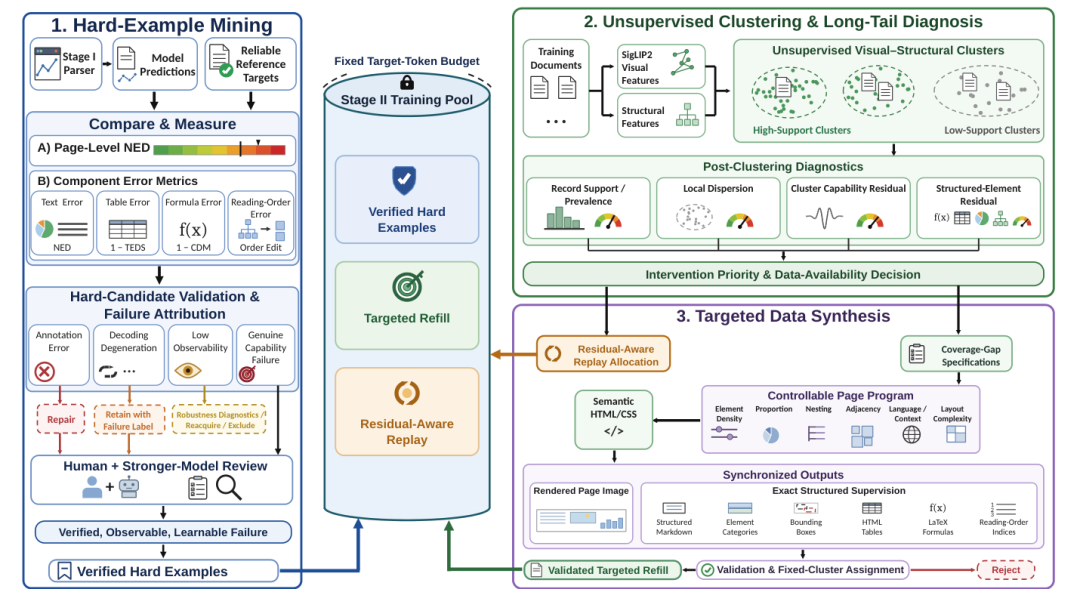
图3 Stage II 数据构建流程:难例审核、聚类诊断、定向合成与残差感知分配共同形成精炼训练池。
为组织诊断与数据补充,论文使用视觉—结构特征形成固定聚类簇,并针对低覆盖区域生成或收集更有针对性的样本。
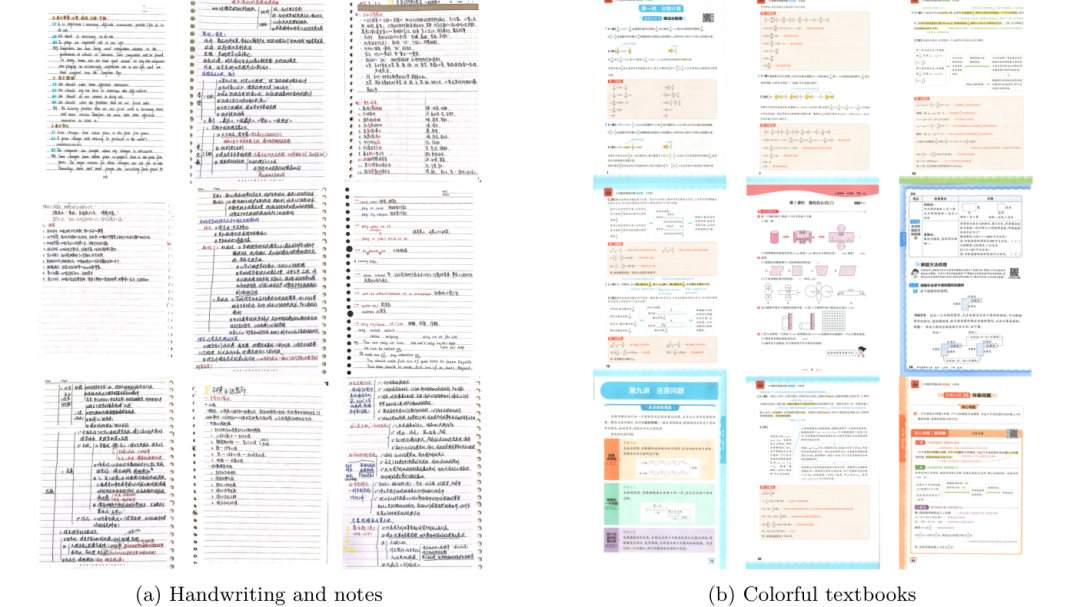
图4 聚类中的代表性结果,包括手写笔记与彩色教材等文档类型。
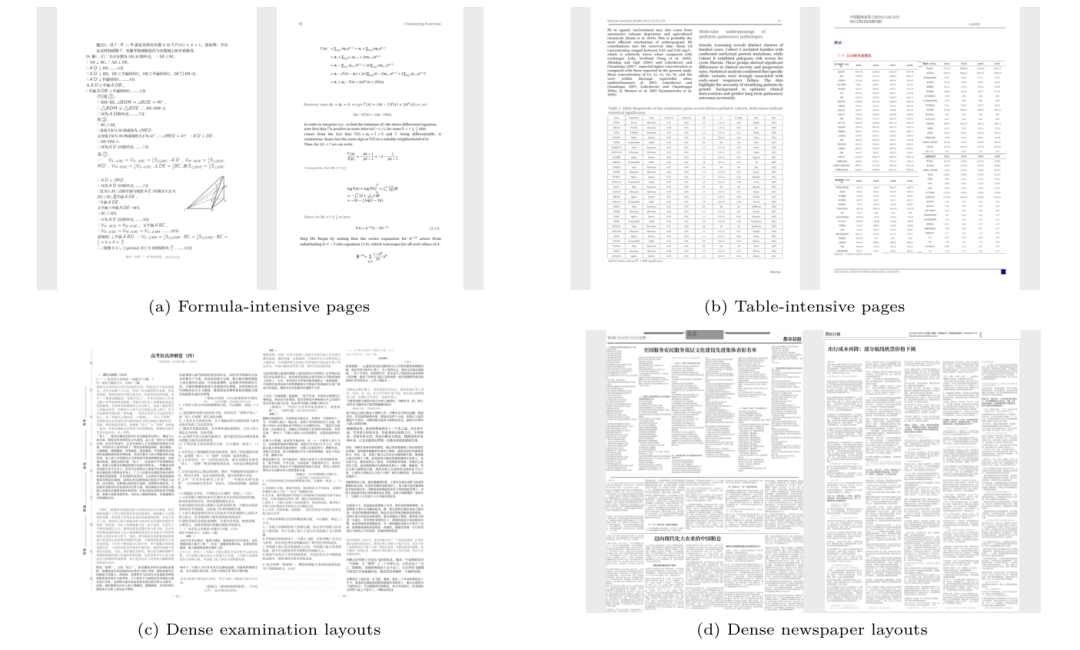
图5 面向低覆盖能力的定向构造样例,覆盖公式密集、表格密集、试卷与新闻版式。
评测结果:多榜单领先
WeVisDoc 提供 2B 和 4B 两种参数规模,相较于其他代表性端到端文档解析模型表现突出。WeVisDoc-4B 在 OmniDocBench v1.6 以及 PureDocBench 三条赛道的四项设置中均取得最高 Overall 分数;更小的 2B 版本也保持了较强竞争力。
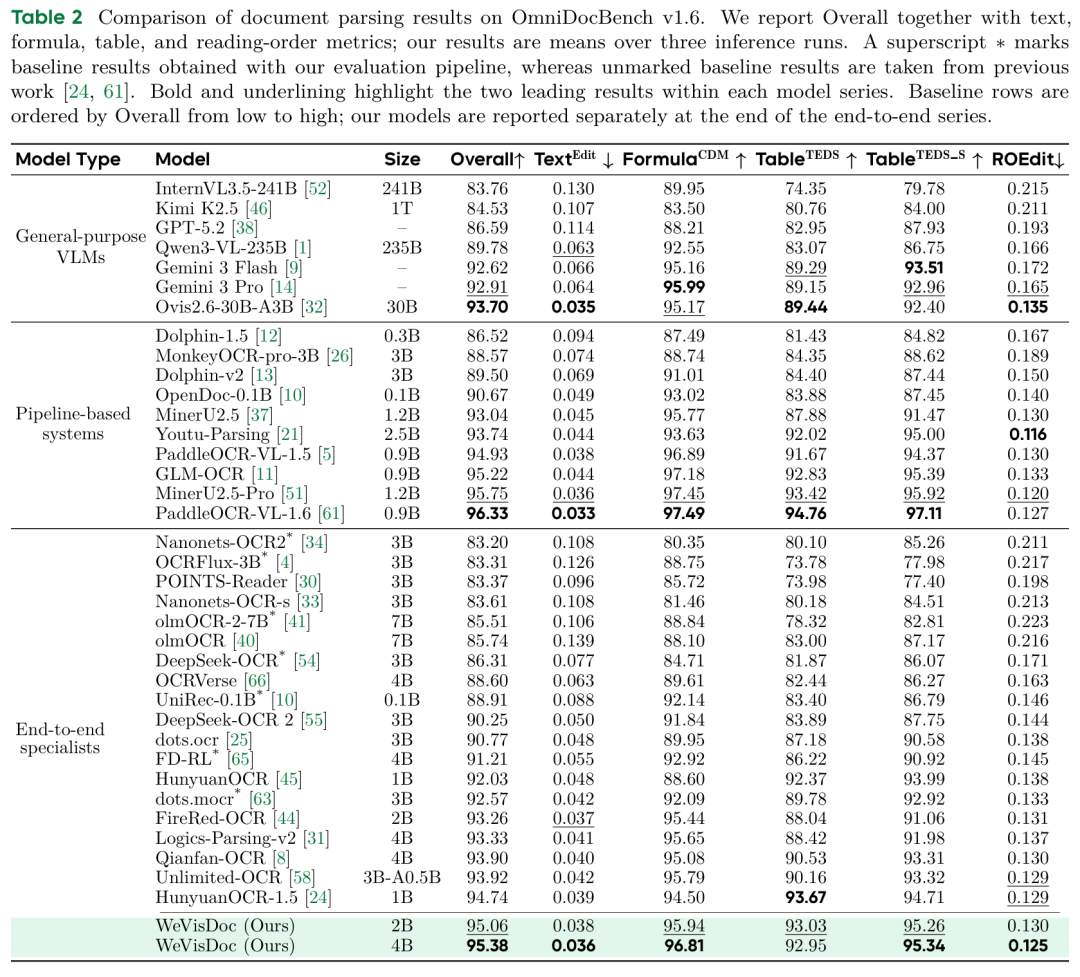
图6(a)OmniDocBench v1.6 完整榜单。
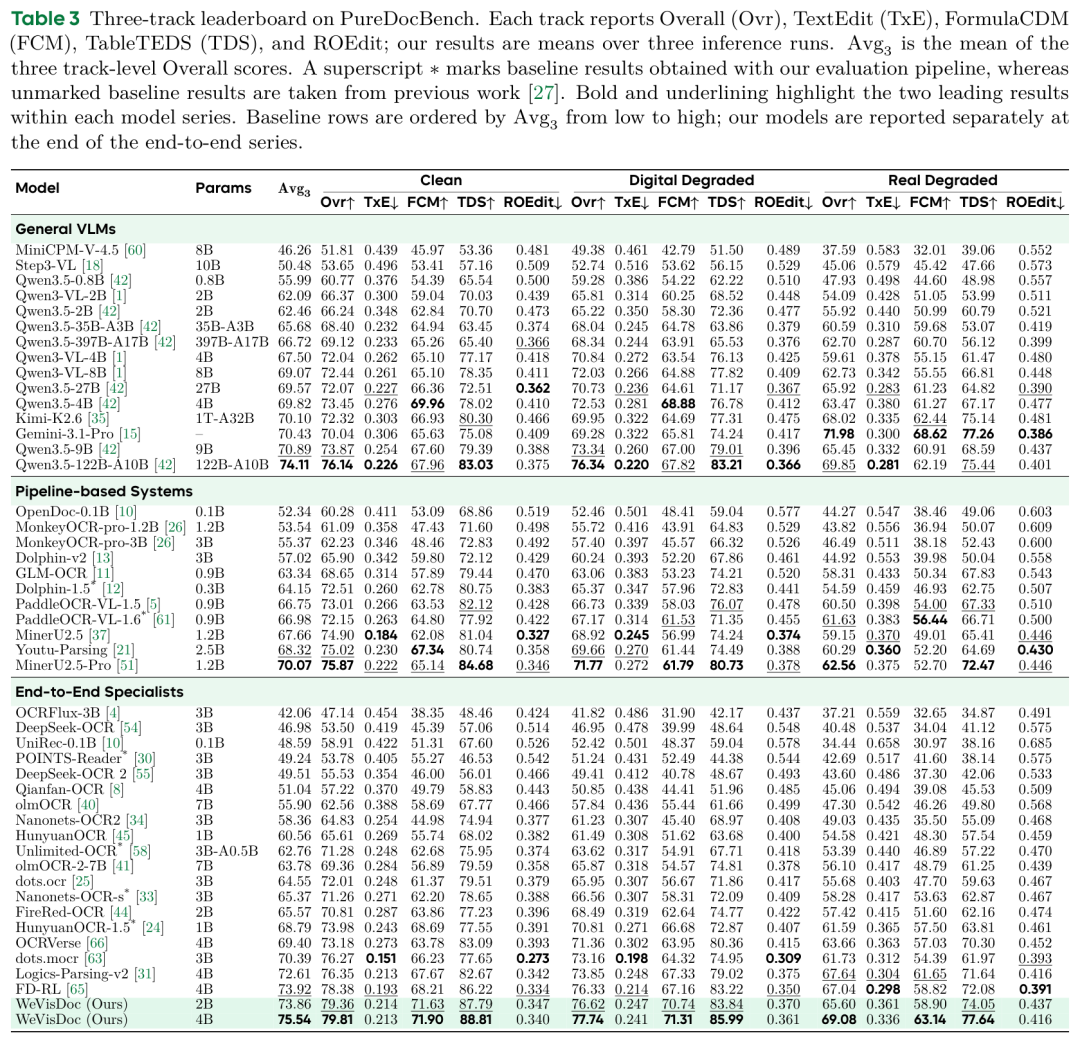
图6(b)PureDocBench 完整榜单。
两阶段训练对文档解析的改善效果
分阶段结果显示,Stage II 对退化场景的增益更为明显。以 4B 模型为例,PureDocBench 的 Clean、Digital Degraded 和 Real Degraded 三条赛道分别提升 0.49、2.55 和 4.03 分。下面选取两个案例,展示 Stage II 相对 Stage I 的具体改善。
案例一:表格结构缺失得到修正
在数独表格样例中,Stage I 未能完整恢复网格;Stage II 恢复了表格边界和单元格内容。该样例的 Overall 指标由 65.87 提升至 99.22,TableTEDS 由 0.333 提升至 1.000。
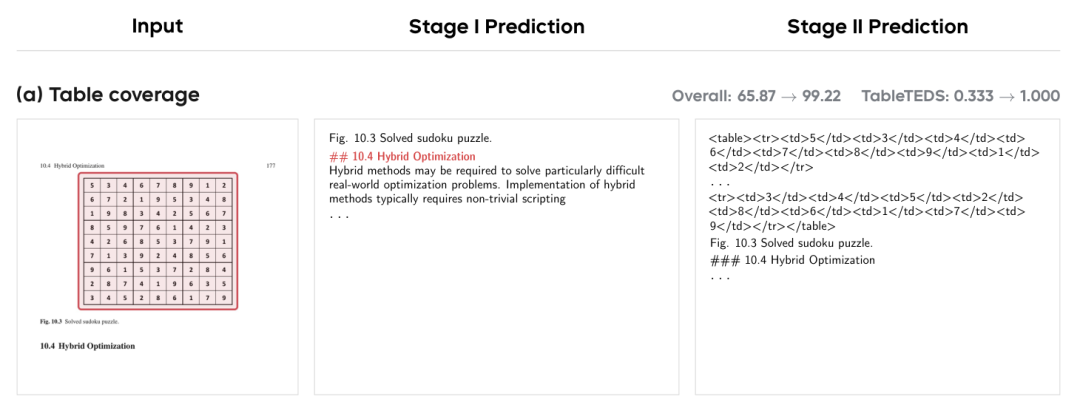
图7 输入、Stage I 预测与 Stage II 预测的静态并列对比。
案例二:文档层级与边界得到恢复
在法规类复杂版式样例中,Stage I 将页面结构误判为 HTML 表格;Stage II 更好地区分了标题层级、段落和表格边界。该样例的 Overall 指标由 3.46 提升至 98.30,TextEdit 由 0.996 降至 0.033。
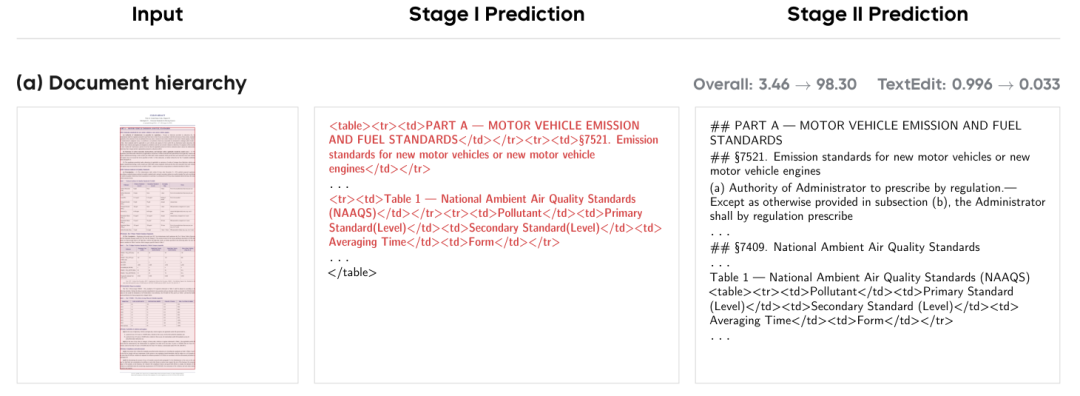
图8 对比
解析样例:从输入到结构化输出
除分阶段对比外,WeVisDoc 还给出了公式、扫描与拍摄文档、表格密集页面等代表性样例。每组样例依次展示输入图像、模型生成的结构化文本,以及渲染后的结果。WeVisDoc 将整页内容输出为保留阅读顺序的 Markdown,表格以 HTML 序列化,以保留行列及合并单元格结构;数学公式以 LaTeX 序列化,便于后续检索、编辑、知识抽取和内容再利用。
Figure 13 · Formula-rich
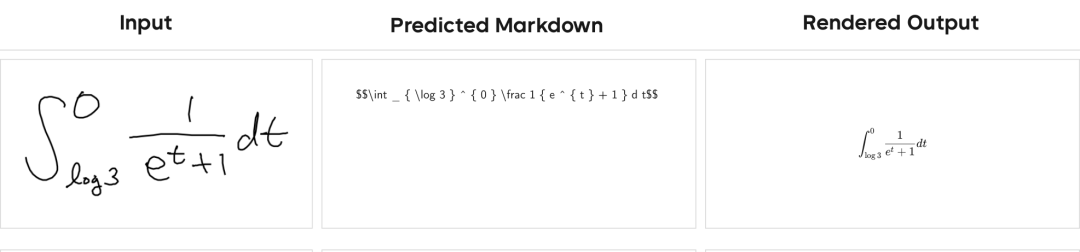
图9 手写积分公式:模型生成 LaTeX,并渲染为可复用的数学表达。
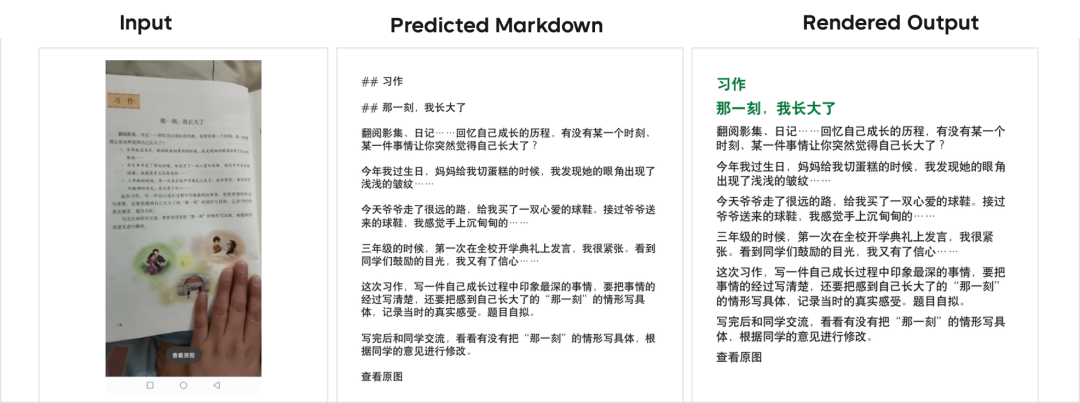
图10 手机拍摄的中文作文页面:模型输出标题、段落与正文内容,并恢复为可读版式。
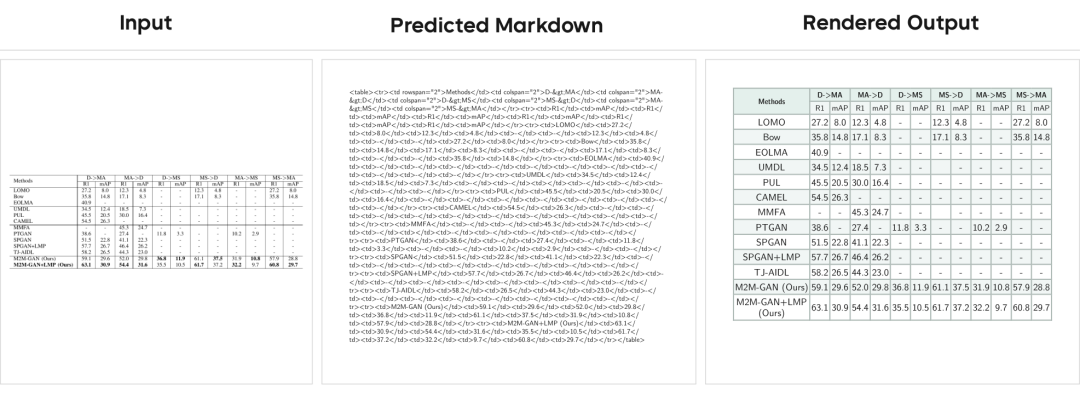
图11 表格密集页面:模型以 HTML 序列化表格,并恢复行列结构。
开源信息
WeVisDoc 现已正式上线,相关技术报告已公开,源代码和模型权重已在 GitHub 和 Hugging Face 上免费开放,欢迎大家下载和使用。
技术报告:https://arxiv.org/abs/2609.20423
项目主页:https://tencent.github.io/WeVisDoc/
GitHub地址:
https://github.com/Tencent/WeVisDoc
Hugging Face 合集:
https://huggingface.co/collections/tencent/wevisdoc
WeVisDoc-4B模型:
https://huggingface.co/tencent/WeVisDoc-4B
WeVisDoc-2B模型:
https://huggingface.co/tencent/WeVisDoc-2B
本文作者@腾讯开源。原文链接:https://mp.weixin.qq.com/s/Y7oW_2yLMRbeG4IE-EeB7Q