AI 编码 Agent 最贵的失败模式,不是写错代码,是它在没跑过任何验证的情况下告诉你改动已经完成。根源在于“完成”对模型来说只是一个可以输出的词,跟文件系统里那几条命令有没有真的被执行,没有任何强制绑定。
OpenAI Agents Python 仓库里有个东西专门盯这件事。它叫 code-change-verification,放在 .agents/skills/ 目录下,内容是一份给 Agent 读的 SKILL.md 加两个脚本。名字听着像 CI 说明书,实际做的事只有一件:重新定义什么叫改完了。
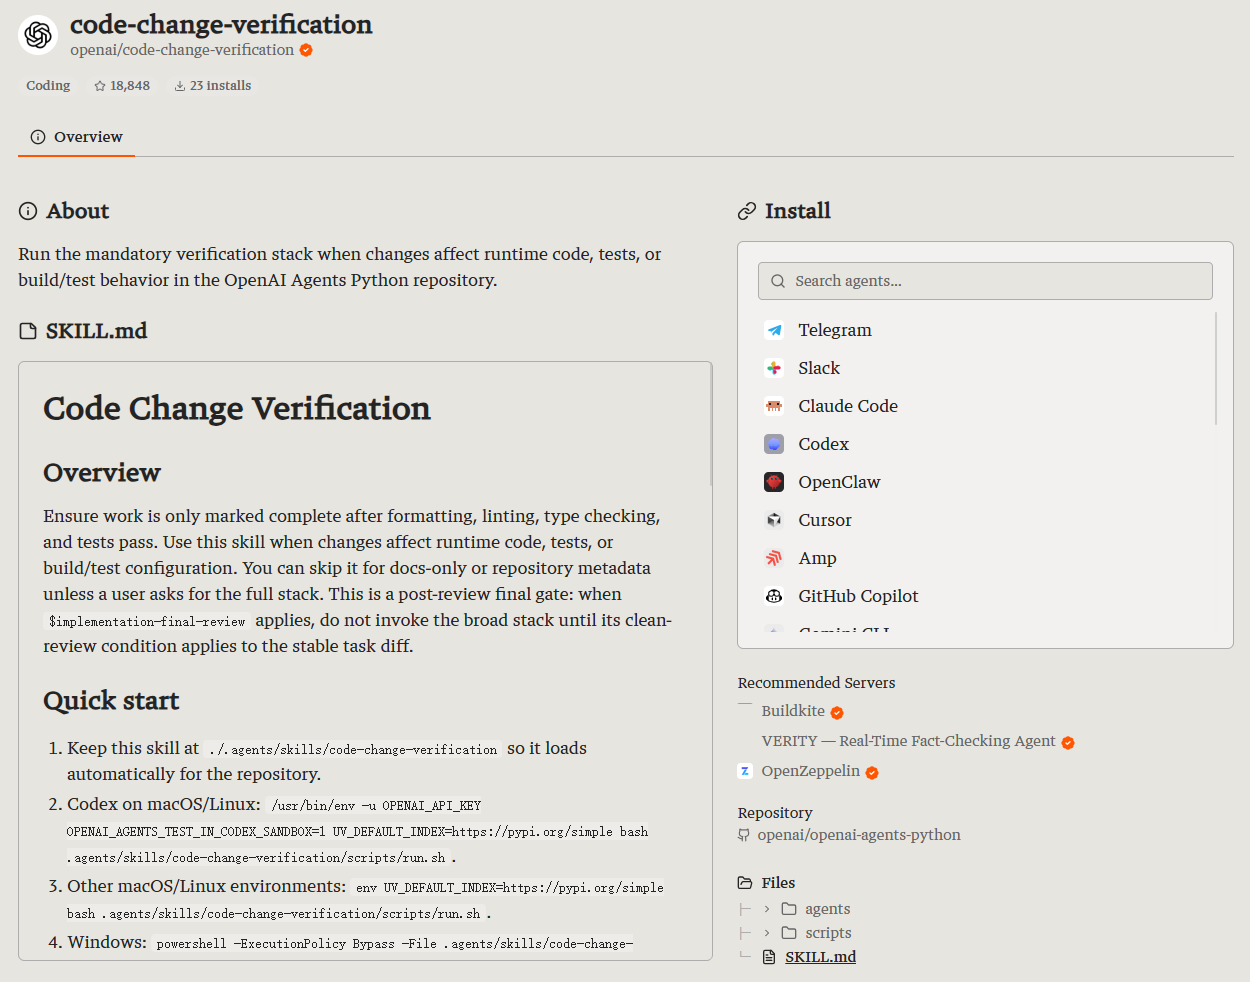
第一遍扫过去,我以为它就是“记得跑测试”四个字包装成了一页文档。看进去才发现问题没那么简单,真正有信息量的部分全在最容易被当成凑字数的限制条款里:什么时候不许启动全栈验证,遇到资源争用为什么禁止加锁,验证失败之后为什么禁止提权重试。
这篇把 code-change-verification 当成一份 Prompt 工程样本来拆,看四件事:指令怎么分层,触发条件怎么划边界,降配逻辑怎么落地,以及安全红线怎么写成没有商量余地的条款。
一份只做一件事的 SKILL.md
它的 Overview 只有三句话,每句都在收窄适用条件。适用条件是改动触达运行时代码、测试或者构建与测试配置;豁免条件是纯文档或仓库元数据改动,除非用户明确要求跑全栈;第三条把执行时机钉在 $implementation-final-review 这个前置 skill 之后。三条合起来只回答一个很窄的问题:这一堆 make 命令,现在该不该跑。
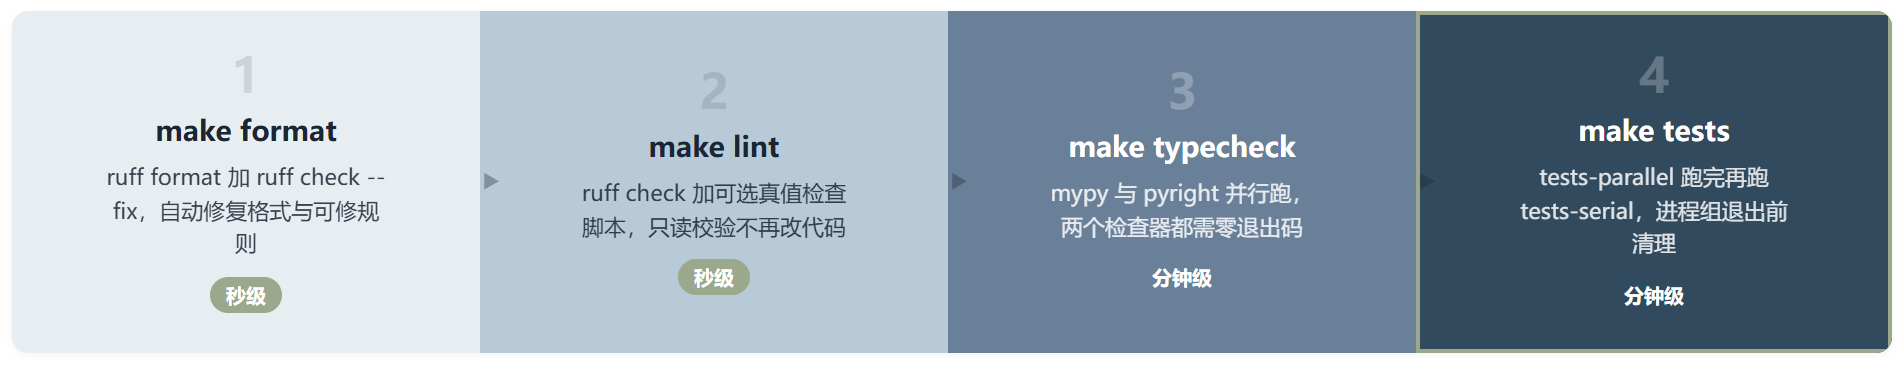
真正值钱的地方在于这份 SKILL.md 没有把自己写成检查清单。它没有讲怎么写好测试,没有讨论覆盖率怎么提,也没有比较 pyright 和 mypy 谁更准。整份文档唯一的动作是把四条命令按固定顺序串起来,并且规定任何一条失败就终止。
make format
make lint
make typecheck
make tests
这是仓库 AGENTS.md 里 Mandatory local run order 的原始顺序,四个目标的成本并不均匀。前两个是秒级的,后两个能吃满一台机器的核心跑好几分钟。把低成本排在前面,本质是用排序换失败发现的时机,格式没过就别浪费 CI 时间去跑类型检查。这条看着朴素,很多团队的顺序其实是反的。
结构与执行栈
这份 skill 的物理结构很薄,SKILL.md 加 scripts 目录下的 run.sh 和 run.ps1,两条脚本最终都落到同一个地方:仓库根目录的 Makefile,再由 Makefile 落到 uv 工具链。指令层负责决策什么时候跑,脚本层负责保证怎么跑不会走样。
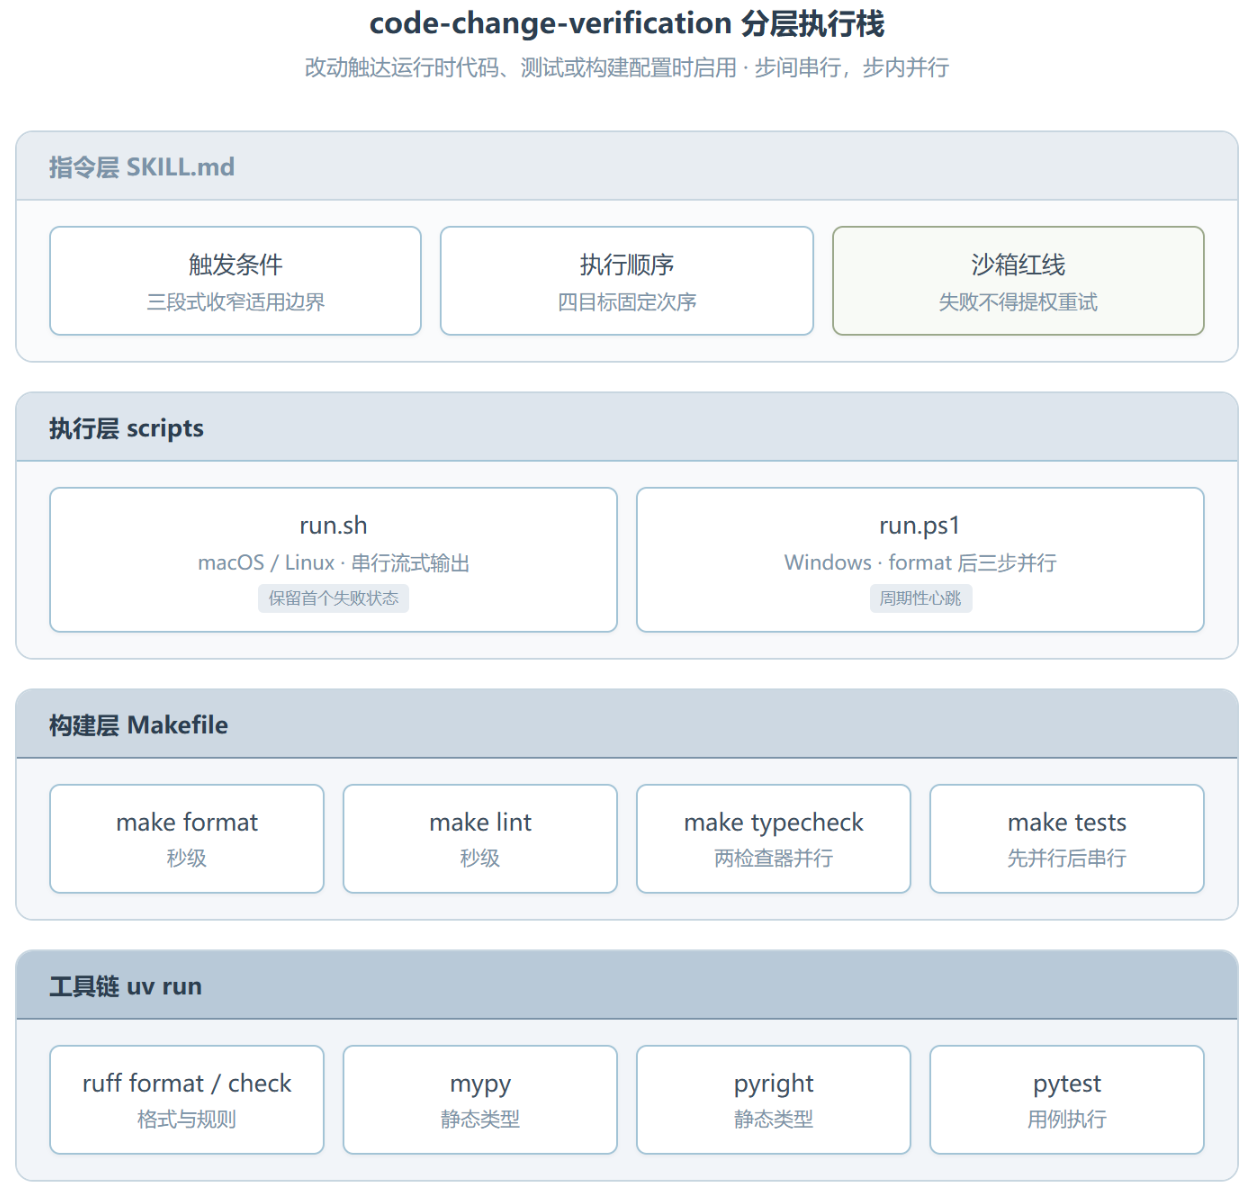
Makefile 里这四个目标实际展开是这样的,具体版本会随时间调整,以仓库为准:
| make 目标 | 实际执行内容 |
|---|---|
| format | uv run ruff format 加 uv run ruff check --fix |
| lint | uv run ruff check 加自定义脚本 check_optional_truthiness.py src/agents |
| typecheck | mypy 与 pyright 并行跑,两者都必须零退出码 |
| tests | 先 tests-parallel,完成后再跑 tests-serial |
typecheck 那一行藏着一个容易被跳过的细节。Makefile 用 shell 的 trap 加 wait 把 mypy 和 pyright 拉成两个并行子进程,两个都通过才算这一步通过。也就是说这一步内部并行,但这四步之间严格串行且 fail-fast。
粒度的区分很关键。跨步骤必须串行,因为后一步的输入依赖前一步的修正结果,被 ruff format 改过的代码必须重新被 ruff check 验证;步骤内部能并行就并行,因为 mypy 和 pyright 互不依赖。手写 Agent 提示词时最容易缺的就是这个区分,常见做法是把命令一股脑丢给 Agent 自由组合。
执行流程与启动条件
脚本层的职责是保序和保真。run.sh 从仓库根目录串行跑四个目标,把每条命令的输出原样流出来,遇到第一个失败或者用户中断就保留这个状态退出,退出前还会清掉当前步骤的进程组。最后这句是 bash 脚本里最常被省掉的:make 会处理自己的子进程,但 pytest worker 和 uv 拉起的临时进程不一定听话。
Windows 没有 bash 进程组可用,run.ps1 换了个策略。它先跑 make format,剩下三步并行执行并用 fail-fast 语义处理失败,同时在长时间执行期间周期性输出心跳。心跳这条是针对宿主环境设计的,不少执行器在一段时间没有任何输出后会判定任务卡死并中断,周期性输出是防止测试被误杀。
启动之前还有一道被单独拎出来写的门槛。SKILL.md 要求在发起全栈之前,先用只读的任务或进程证据确认宿主机上没有同类重型命令正在跑,具体要看的包括这几类:
- 仓库级 test 或 typecheck
- build 与 examples runner
- 集成测试命令
一旦看到争用,就转去做 review、修复、证据整理这类非重活,过一段时间再回来检查。这条规则看着顺理成章,真正奇怪的是紧跟着的下一句。
全栈启动被写成自动行为。文档明确写了不需要用户发一条 finalize 消息来触发,只要 review 干净、diff 稳定、宿主容量可观测,就该自己开始跑。这跟大多数“由人点头才启动”的流水线不太一样,它默认 Agent 有资格判断时机,人只需要看失败输出。
三种改动,三种成本
这套门禁对不同改动的反应差别很大,把它当成一刀切的开关会误判。把改动按类型摊开,差别主要体现在是否触发全栈、迭代期允许什么动作,以及单次成本大致落在什么量级。
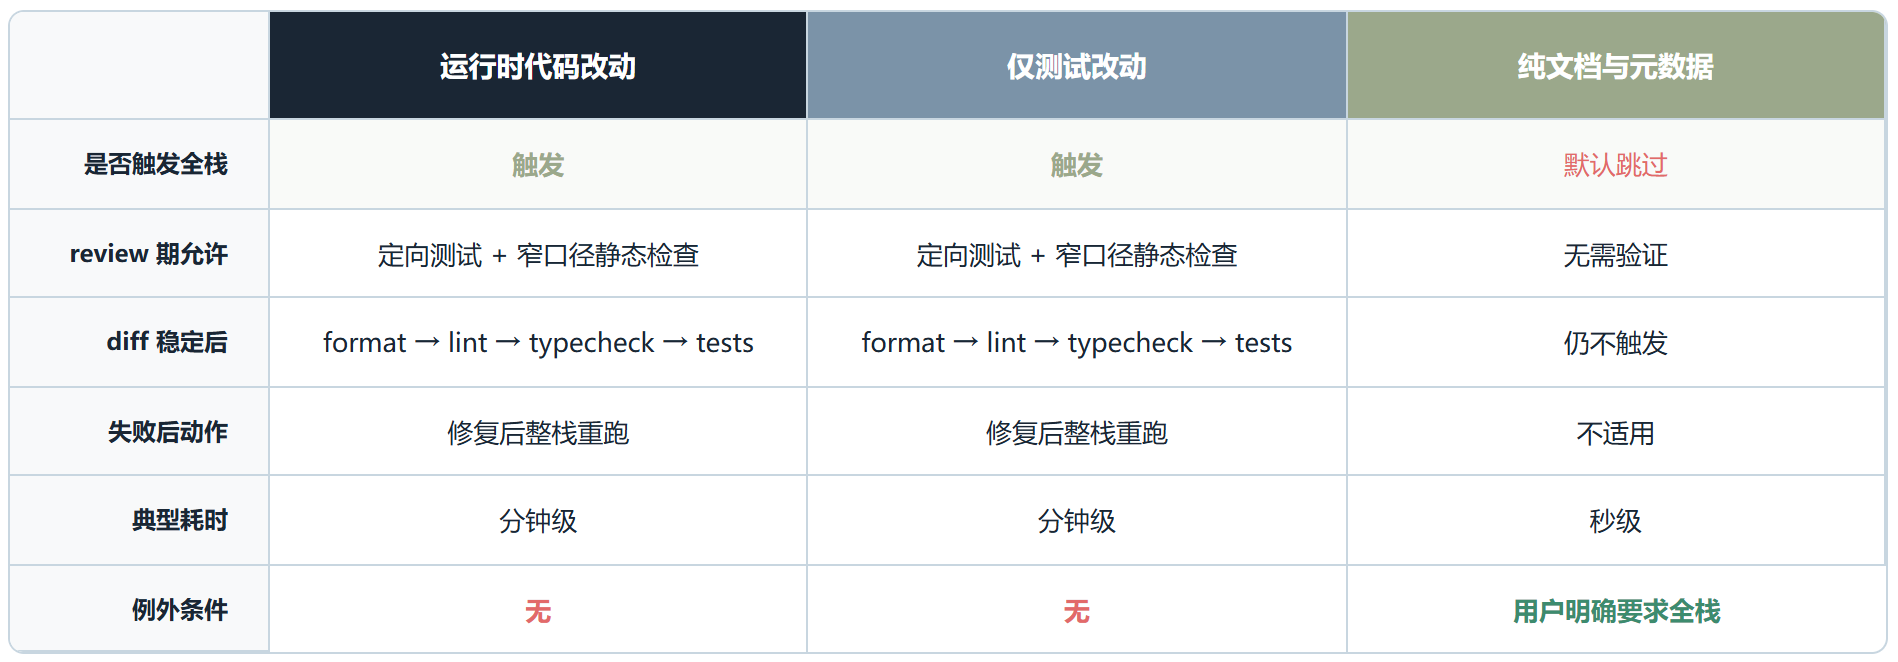
文档豁免那条值得单独说。很多 Agent workflow 的做法是无条件全跑,代价是每次改 README 都要付出一次完整测试的时间。这份 skill 明确允许跳过,但留了一个兜底条款:用户明确要求跑全栈时例外。豁免加兜底的组合,比单纯的硬性规则更容易在真实协作里活下来。
三个平台的入口命令长得完全不一样,差异里藏着三个各自独立的问题:
# Codex 环境(macOS / Linux)
/usr/bin/env -u OPENAI_API_KEY OPENAI_AGENTS_TEST_IN_CODEX_SANDBOX=1 \
  UV_DEFAULT_INDEX=https://pypi.org/simple \
  bash .agents/skills/code-change-verification/scripts/run.sh

# 普通 macOS / Linux 环境
env UV_DEFAULT_INDEX=https://pypi.org/simple \
  bash .agents/skills/code-change-verification/scripts/run.sh

# Windows
powershell -ExecutionPolicy Bypass -File .agents/skills/code-change-verification/scripts/run.ps1
-u OPENAI_API_KEY 是把密钥从环境里剥掉,防止测试过程中意外发出真实请求。OPENAI_AGENTS_TEST_IN_CODEX_SANDBOX=1 只跳过标记了 requires_native_macos_sandbox 的测试,其余全部保留。UV_DEFAULT_INDEX 指向官方 PyPI,避免内部镜像把依赖解析带偏。三条拆开看各有具体用途,混在一起就成了一串咒语。
洞察与反思
最反直觉的一条是明令禁止加锁。文档原话是不要创建或等待仓库锁、主机级互斥量或哨兵文件。理由不难推:Agent 进程本身不可靠,随时可能被中断或被杀,任何由它创建的锁都存在变成僵尸锁的风险,一条僵尸锁能把这个仓库后续所有自动化全部堵死。宁可用观察加退让的软策略,也不要引入需要清理的持久状态。
第二块是沙箱边界的写法。它规定验证过程与所有子进程必须留在常规 Codex 沙箱内,不得申请提权,失败后也不得用更宽的主机权限重试。这条把“任务完成率低于安全边界”写成了明文取舍,还补了一句:被跳过的原生 macOS 测试跑在一次性的 GitHub 托管 runner 上,runner 不可用时如实报告覆盖缺失,不许放宽沙箱来补偿。
第三块是迭代期的降配。review 还在进行时只允许跑定向测试和必要的窄口径静态检查,全栈 typecheck 要等到 review 干净、diff 稳定之后才启动。这条解决的是 AI 辅助开发里很实在的浪费:Agent 一边改一边跑全量,跑出来的结果每一轮都被新 diff 作废。
局限也清楚。所谓容量检测依赖“可用的只读任务或进程证据”,文档没有定义获取方式,还写明遥测不可用时不因无法测量而阻塞,这条大概率退化成尽力而为。另外 OPENAI_AGENTS_TEST_IN_CODEX_SANDBOX 这类变量把特定 Agent 平台硬编码进了测试代码,换宿主就得改;文档也没给整条栈的总时长上限,一次 make tests 打到什么时候为止完全取决于仓库自身。
资源地址
| 资源 | 地址 |
|---|---|
| Smithery 页面 | https://smithery.ai/skills/openai/code-change-verification |
| openai-agents-python 仓库 | https://github.com/openai/openai-agents-python |
| 仓库 Makefile | https://github.com/openai/openai-agents-python/blob/main/Makefile |
| 仓库 AGENTS.md | https://github.com/openai/openai-agents-python/blob/main/AGENTS.md |
总结
这是一份把“完成”从语义降级成布尔值的工程样本。它的价值不在那四条 make 命令,任何 Python 仓库都能写出差不多的组合。真正难抄的是它把下面这些原本留给 Agent 自由发挥的地方,全部改成了要么执行要么报错的硬条款:
- 触发条件
- 执行顺序
- 资源争用
- 权限边界
如果要抄,优先抄结构设计而不是四条命令。适用条件的三段式收窄、步进串行与步内并行的粒度区分,加上宁可失败也不扩权重试的红线写法,这三点换到别的语言栈照样成立。四条命令本身反而是最容易替换的部分。
留给后面想的问题是,这套东西能不能脱离 Codex 存在。当前版本里平台相关的环境变量和沙箱假设已经渗透进执行命令,真要做到跨宿主通用,得先把意图层和宿主层彻底拆开。这一步 OpenAI 自己还没做完。