Smithery 上挂着一条叫
openai/examples-auto-run的技能,一句话描述是“用自动模式跑 Python 示例,带日志、重跑助手和后台控制”。抓取时它的热度是 18,848,安装数只有 24。这个比例本身就说明问题:围观的人多,真装的人几乎没有,因为它压根不是给外部用户准备的,它是 OpenAI 用来维护自家 Agents SDK 仓库的内部工具,只是被放到了公开目录里。
我一开始以为这只是个“跑测试的壳子”。点进 SKILL.md 才发现不是那么回事。它真正的价值在于一次职责切分:哪些事交给脚本,哪些事必须留给模型。OpenAI 在那篇讲开源维护的官方博客里把这条线划得很直白,解释、比较、汇报归模型,确定性的重复 shell 劳动归 scripts/。
更值得琢磨的是它的演化轨迹。你今天在 Smithery 上看到的这份快照,是一个会启动进程、管理 pid 文件、自动批准 shell 和 MCP 调用的执行者。而 openai-agents-python 仓库 main 分支里,这个技能已经改名叫 examples-run-analysis,正文第一句就是“绝不执行或控制任何示例”。
一个技能从“能干活”退回到“只读分析”,在所有人都在给 Agent 加权限的当下,这是逆行的。我想拆的就是这件事:它原来怎么分层,为什么后来要把执行权收走,以及这套边界设计对你自己写技能有什么用。
架构解析
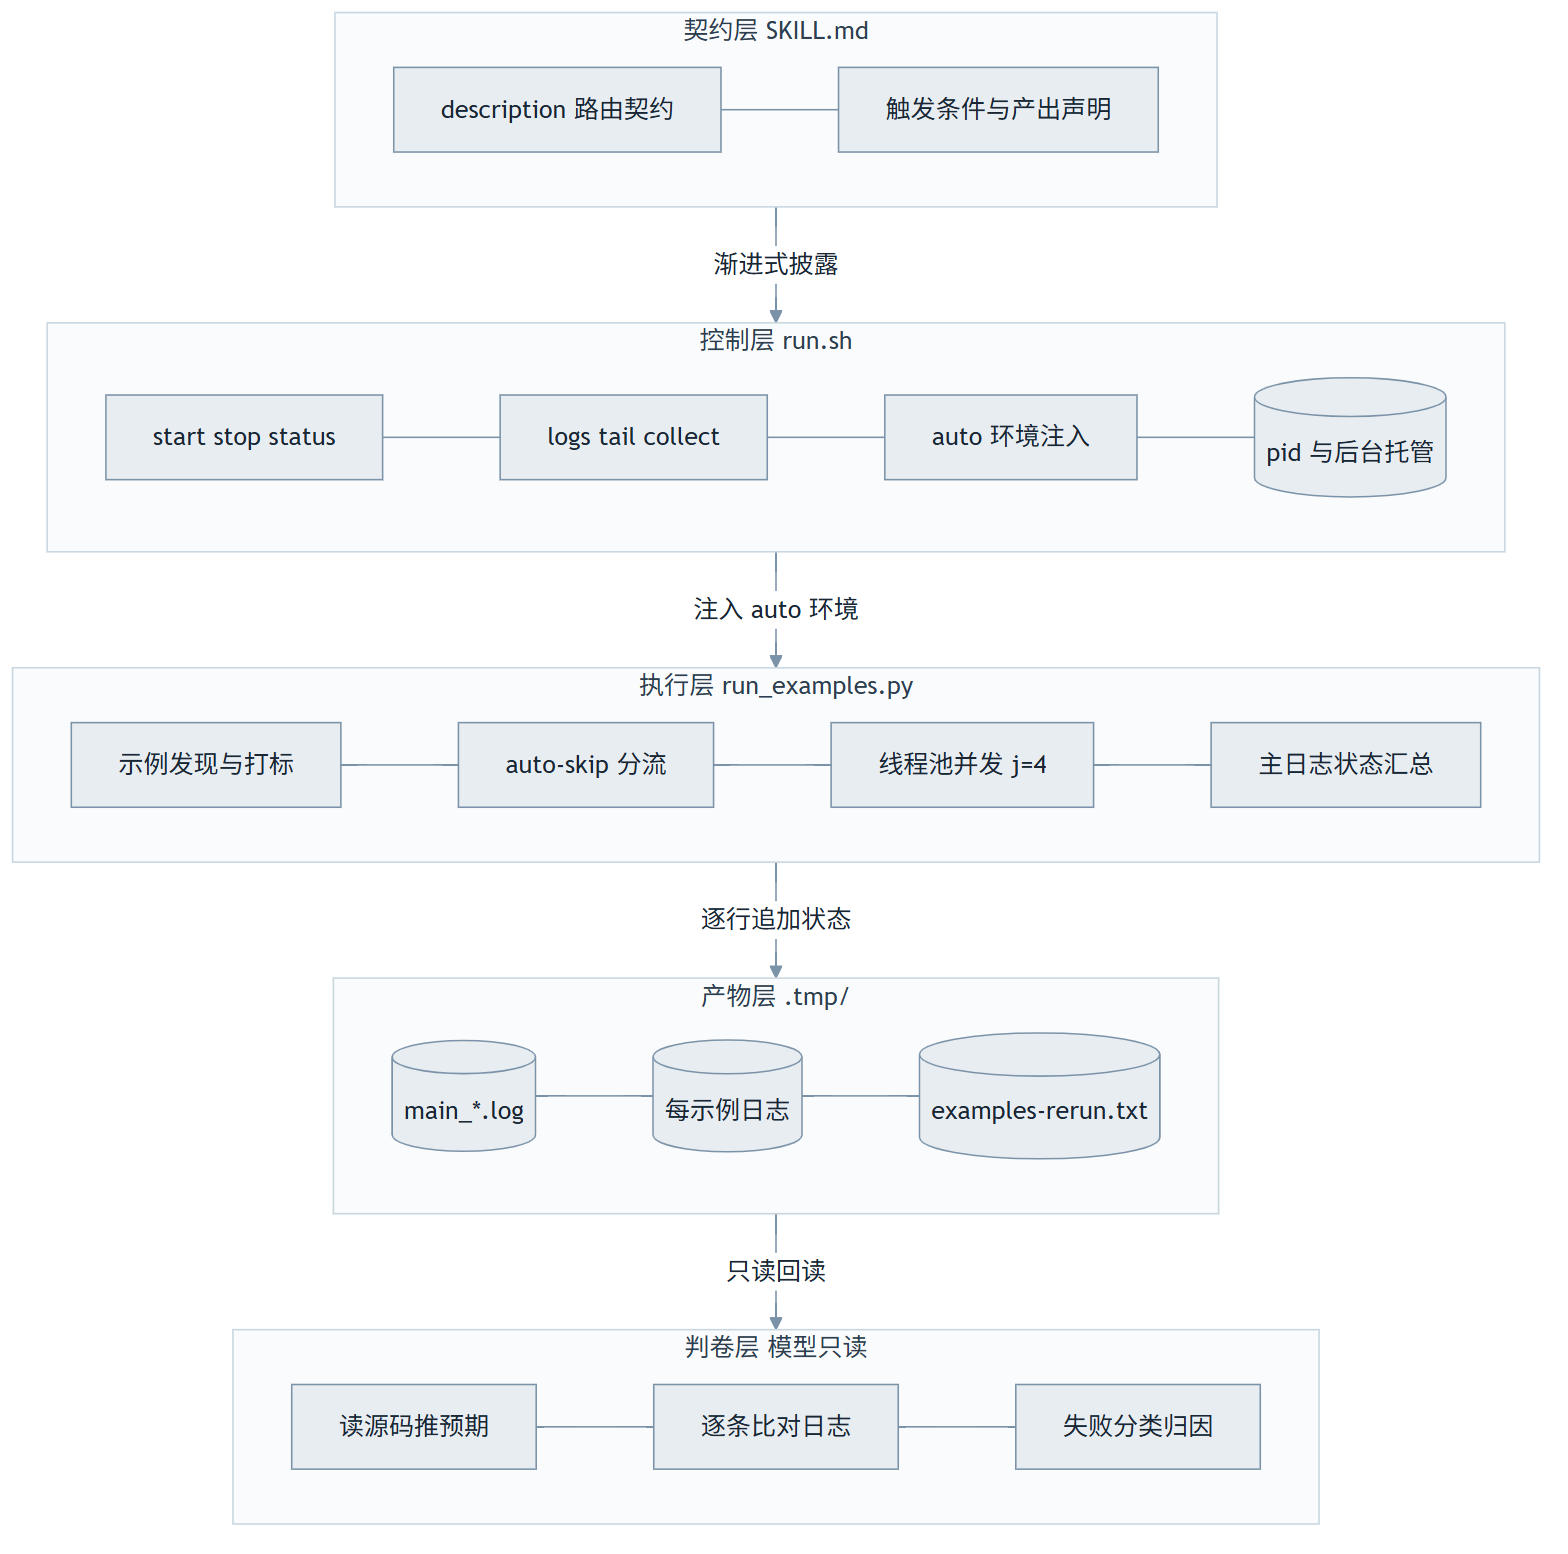
整个技能是三层套娃。最外层 SKILL.md 只做契约声明,不写实现。中间层是 shell 控制器,管进程生命周期和环境变量注入。最内层是 examples/run_examples.py,842 行 Python,真正干活的是它。Smithery 快照里中间层叫 scripts/run.sh,仓库里现在的等价物是 .github/scripts/run_examples.sh,功能一脉相承。
这三层不是随便切的。SKILL.md 的 frontmatter 里那句 description 就是路由契约,模型先只看到它,命中了才加载正文,正文命中了才去读脚本。OpenAI 在博客里专门强调过这种渐进式披露:短版本只说技能做什么,完整版本要说清何时触发、是否可选、产出什么,三件事缺一件模型就会乱调。
中间层的价值最容易被低估。run.sh 干的每件事单看都很碎:
- 建日志目录,拼
uv run --extra ...前缀 - 写 pid 文件,做前后台托管
- 后台模式用
trap '' HUP,防止终端断开把进程带走 - 停的时候先
kill,sleep 一秒确认,没死透再补kill -9
可这些碎事如果每次都让模型重新推理一遍,就纯粹是 token 浪费加不稳定来源,抽成脚本之后模型只需要知道七个动词。
# Smithery 版 SKILL.md 暴露的动作集
run.sh start [args]    # 前台 auto 模式跑示例
run.sh start --background
run.sh stop            # 按 pid 文件收尾
run.sh status
run.sh logs
run.sh tail [file]
run.sh collect         # 从主日志抽取 rerun 列表
最内层的 run_examples.py 才是有技术含量的部分。它扫 examples/ 下所有带 if __name__ == "__main__" 保护的文件,然后靠源码特征给每个示例打标签,标签决定这个示例在这次运行里是被执行、被默认跳过,还是必须显式加 --include-xxx 才跑。
打标签的逻辑写得非常实在,全是朴素的字符串匹配,没有任何魔法。触发特征就这么几行:
interactive   input( / input_with_fallback( / confirm_with_fallback(
              prompt_toolkit / questionary / human_in_the_loop / hitl
server        路径含 server / uvicorn / fastapi / websocket
audio         路径含 voice / realtime
好处是任何人都能一眼看懂为什么某个示例被跳过了,不用去猜模型的心思。
工作流分析
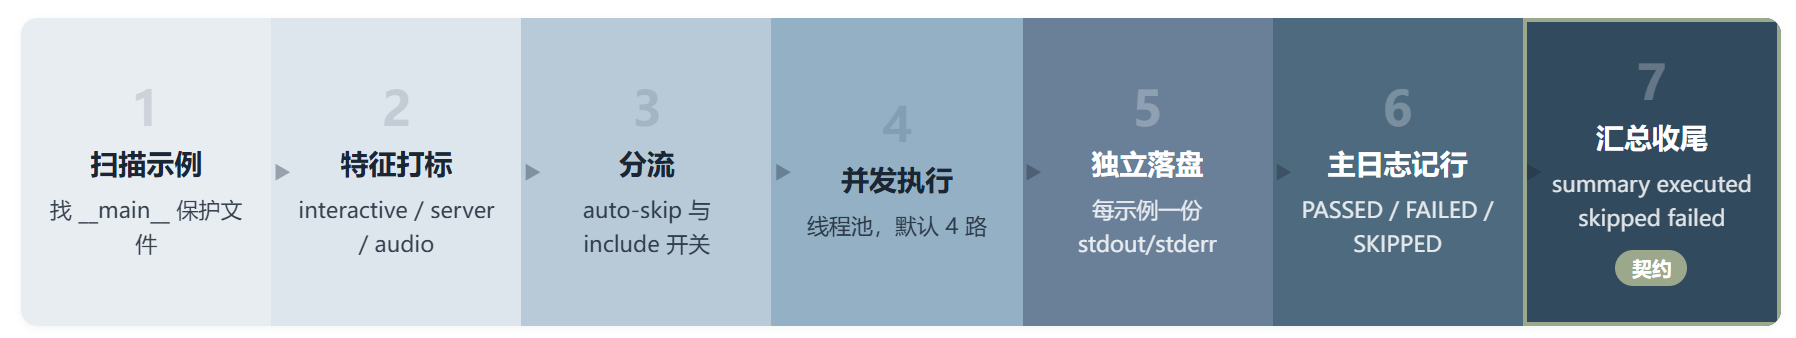
一次完整跑批的链路大致分三段。开头是发现与分流,扫目录、打标签、按 include 开关和 auto-skip 名单决定谁上场。中段是并发执行和独立落盘,每个示例拿一份自己的日志。收尾是写日志契约,往主日志追加状态,最后补一行汇总。并发度由 --jobs 控制,默认取环境变量 EXAMPLES_JOBS,没设就是 4,底层是 ThreadPoolExecutor。
分流那一步有个细节我特别喜欢。除了靠标签动态判断,源码里还硬编码了一个 DEFAULT_AUTO_SKIP 集合,四十来个条目,几乎每一条旁边都写了原因。blaxel_runner.py 旁边写着 Blaxel 0.3.2 还在 import 一个 MCP v2 已经删掉的模块,vercel_runner.py 旁边写着临时关掉因为凭据有问题,几个 MCP server 文件旁边的注释是“这些是守护进程或子进程组件,由同级示例调用”。这是把运维知识显式写进代码,而不是埋在一个模型永远猜不到的地方。
自动批准那段是整套设计里最需要胆量的地方。auto 模式会一次性设置四个环境变量:
EXAMPLES_INTERACTIVE_MODE=auto   # 交互式输入自动应答
APPLY_PATCH_AUTO_APPROVE=1       # apply_patch 自动通过
SHELL_AUTO_APPROVE=1             # shell 命令自动执行
AUTO_APPROVE_MCP=1               # MCP 调用自动批准
四个变量合起来的意思是,交互式输入免审,补丁应用免审,shell 命令免审,MCP 调用也免审。放在一个要跑几十个未知示例的进程里,这等于把护栏全拆了。旧版 SKILL.md 给出的配套措施很硬,要求 Codex 在沙箱之外执行,理由是这些示例会自己起嵌套沙箱和浏览器,还会拉起 npm 助手或本地服务进程,在沙箱里跑必然报出一批环境专属的假失败,比如 sandbox-exec: sandbox_apply: Operation not permitted 和 Playwright 缓存权限错误。
落盘的日志契约是整条链路真正的产出核心。每个示例跑完往主日志追加一行 PASSED 或 FAILED 或 SKIPPED,行里带上相对路径、退出码和该示例自己的日志文件名,最后再补一行 # summary executed=N skipped=N failed=N。格式极简,但对模型极其友好,它不用解析 JSON,直接按行读就能建立全局视图。
使用场景
最容易理解的场景是发版前回归。Agents SDK 的 examples/ 目录下挂着一大批示例,改一行运行时代码可能影响其中任何一个。人工全跑一遍不现实,写固定断言又覆盖不了“这个示例有没有真的调用它声称要调用的工具”这类问题。
这正是 OpenAI 给出的解法:脚本只负责把 stdout 和 stderr 原样录下来,判卷交给模型。Smithery 版 SKILL.md 的原文是,runner 不做任何自动化行为校验,模型必须对每一条 exit-0 记录读源码推导出预期流程和关键输出,再打开对应日志确认这些行为真的发生了,而且是对所有通过的示例做,不是抽样。
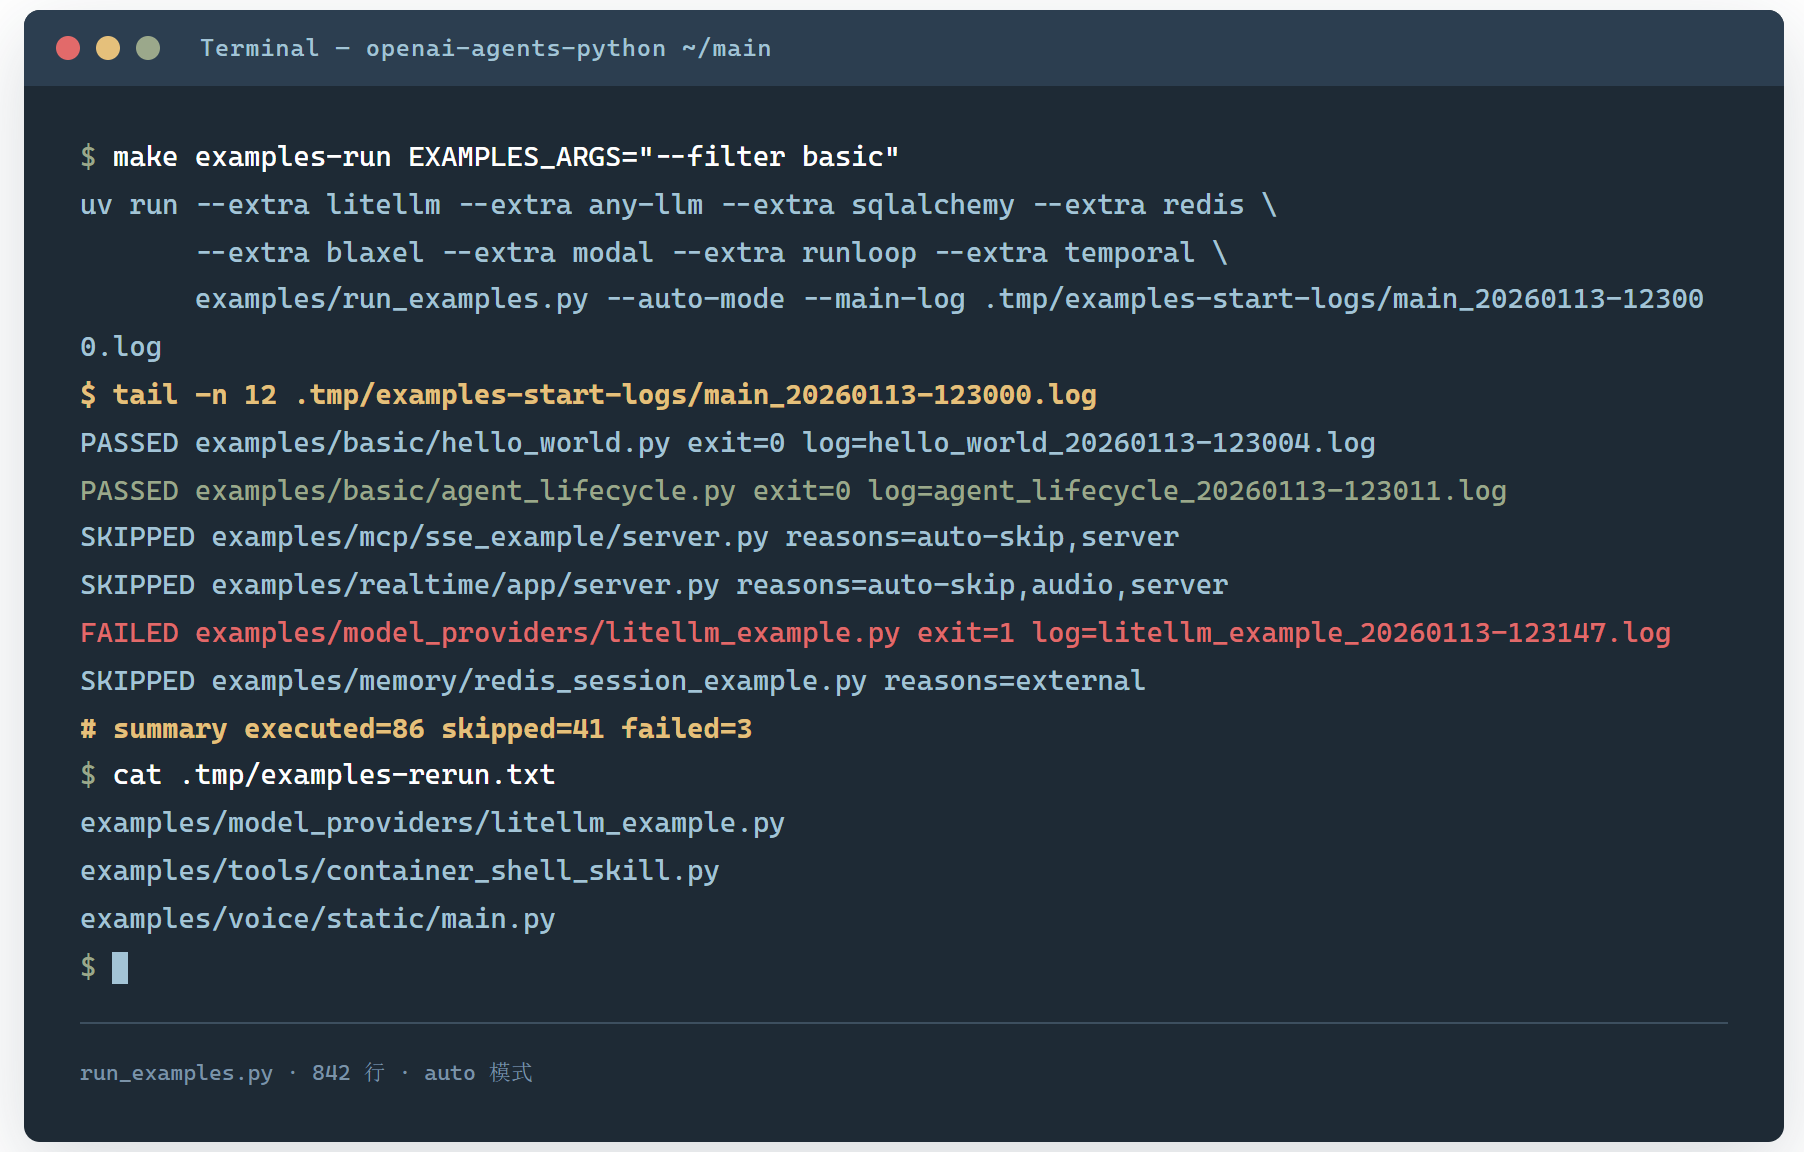
第二个场景是只重跑失败项。--write-rerun 会把失败的示例路径写进 .tmp/examples-rerun.txt,下次 run.sh rerun 只跑这批。更省事的是旧版留的一个默认行为:如果 rerun 文件存在且非空,不带任何参数调用技能就直接走 rerun 分支,连参数都省了。
但边界得说清楚。这个技能强绑定仓库结构,它认死了 examples/ 目录和 uv run 命令,.tmp/ 产物路径和 Make 目标同样是写死的。你把它装进自己的项目,大概率什么都跑不起来。它不是一个通用的示例测试框架,是 OpenAI 给自己仓库写的维护工具,碰巧开源而已。官方博客给出的数据也印证了这种内部工具的定位:引入这套技能体系后,两个仓库的合并 PR 数从 316 涨到 457,Python 侧 182 到 226,TypeScript 侧 134 到 231。
洞察与反思
回到开头那个演化。新版 examples-run-analysis 把硬边界写进了正文第一节,原文是一组“绝不”:
- 绝不启动、重试、停止或以任何方式执行示例
- 绝不调用 Make 目标或
.github/scripts/run_examples.sh - 绝不申请提权、改环境、删 pid 文件或给后台进程发信号
- 可用命令收敛到下面这几个只读操作
git status   git log   find   ls
stat   ps   sed   rg
一个能改状态或动进程的命令都不在白名单里,这条线划得比大多数沙箱策略都保守。
为什么要收权?从新版的分析流程能推出三条原因。日志可能来自一次还在跑的运行,模型拿半成品当结论会误判,所以必须先查进程表和主日志的完整性;源码在跑完之后又改了,日志就失效了,所以必须用 git 历史和时间戳校验新鲜度;还有最现实的一条,一个会自动批准 shell、apply_patch 和 MCP 的技能,被提示词注入利用的代价实在太高。
新版流程里有两段我觉得比旧版更值得抄走。一是“不满足条件就直接停”:没有可用的完整产物,就明确告诉用户去手动跑哪个 Make 命令,给出确切命令但不执行,绝不硬着头皮猜。二是失败分类,要求把每条失败归到下面几类里,把真 bug 和环境问题彻底分开:
- 产品缺陷
- 依赖或凭据问题
- 供应商或网络故障
- 本地服务或平台限制
- runner 主动跳过
- 未定
这一层在大多数 CI 里都是缺的,大家只看红绿,不看红的原因归属。
对我自己写技能的启发浓缩成一句话:把“能做什么”写清楚,不如把“绝不能做什么”写清楚。多数技能文档都在堆能力清单,可真正的可靠性来自边界。OpenAI 用一次重命名演示了这件事,从执行者退回分析者,功能表变短了,可用性反而上去了。
资源地址
| 资源 | 链接 |
|---|---|
| Smithery 技能页 | https://smithery.ai/skills/openai/examples-auto-run |
| 源码仓库 | https://github.com/openai/openai-agents-python |
| 现行技能(只读分析版) | .agents/skills/examples-run-analysis/SKILL.md |
| 示例执行器源码 | examples/run_examples.py(842 行) |
| OpenAI 官方博客 | https://developers.openai.com/blog/skills-agents-sdk |
总结
这套技能的内核不是“自动跑示例”,而是把一次回归测试拆成两段:机械的部分用脚本锁死,判断的部分留给模型。脚本给出确定性的日志契约,模型拿着源码意图去对账,两边各干各擅长的事,中间靠一行行 PASSED/FAILED 文本衔接。
它适合谁?适合维护大型 SDK、示例目录动辄上百个文件、且改动频繁影响面的团队。它不适合谁?不适合想找个开箱即用测试框架的个人项目,那份 DEFAULT_AUTO_SKIP 名单和 uv extras 列表已经把仓库绑定写在脸上了。
至于从 examples-auto-run 到 examples-run-analysis 的那次转身,我的判断是它代表了一种正在成形的共识:Agent 的能力边界不该由它能调多少工具来定义,而该由它明确拒绝做什么来定义。这个转向可能比技能本身更值得关注。