货拉拉作为领先的互联网物流平台,其广告资源位遍布用户端、司机端、搬家端等多个触点,形态涵盖弹窗、Banner、活动页等。广告系统日均管理数千条计划,需要实现多城市、多人群、多时段的精细化投放。从素材准备、定向配置、流量设置到效果复盘,全链路高度依赖运营人员手动操作广告平台。
传统模式的三大痛点
1效率瓶颈:批量创建、修改广告计划需逐项填写表单,复杂定向参数组合耗时费力,跨城市复制计划尤为繁琐
2优化滞后:效果评估依赖人工导出报表、Excel 透视分析,洞察产出周期以天计,极易错失最佳调优窗口。
3人力成本高:广告基础数据拉取、重复性报告撰写占用了运营人员大量精力,难以聚焦于高价值的策略创新。
二、破局思路与功能设计
2.1 范式跃迁:从”被动工具”到”数字员工”
大模型已从单纯的“文本工具”进化为具备理解、推理和自主执行能力的 AI 智能体(Agent)。利用大模型对传统广告平台进行改造,核心思想是将系统从“人适应机器”的被动操作工具,升级为“机器适应人”的数字员工。
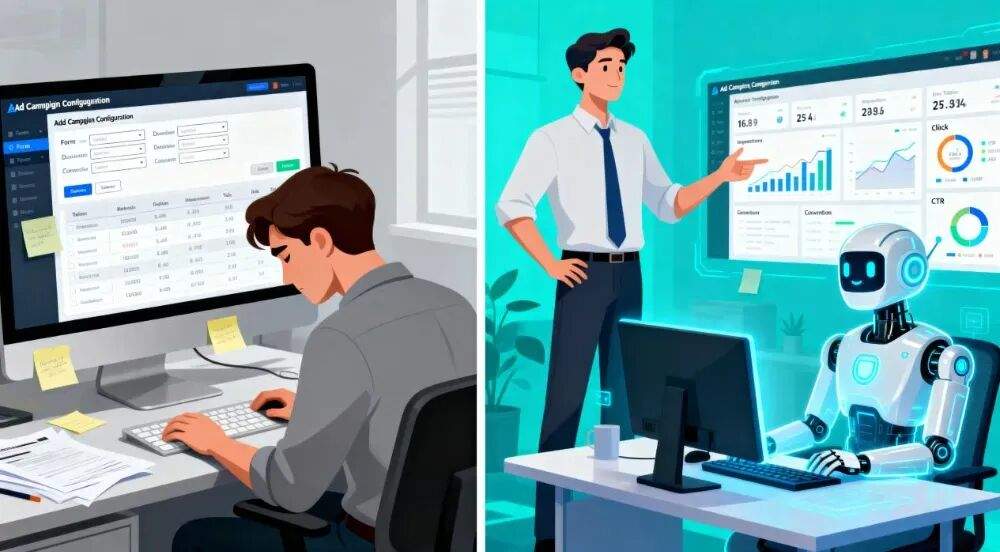
通过引入大模型构建三大数字员工,我们实现了三个维度的价值跃迁:
交互升维:从“人适应机器”的表单填报,升级为“机器适应人”的自然语言交互,降低操作门槛,提升用户体验。
自主执行:赋予系统“认知”与“执行”能力,由大模型承担计划配置、数据洞察等重复性工作,释放运营精力。
提效降本:打破传统技术的效率瓶颈,将操作耗时从“分钟级”降至“秒级”,将分析周期从“天级”缩短至“分钟级”,大幅降低基础人力投入。
基于此,我们开发了广告 AI 助手,旨在彻底解决货拉拉营销广告业务中的核心痛点。
2.2 功能设计
当前与大模型的主流交互方式是通过对话框进行自然语言交互。广告 AI 助手的整体功能设计基于此模式:用户在对话框中输入自然语言提示词(Prompt),大模型根据输入进行意图识别,并调用相关工具以满足用户需求。
2.2.1 对话框输入
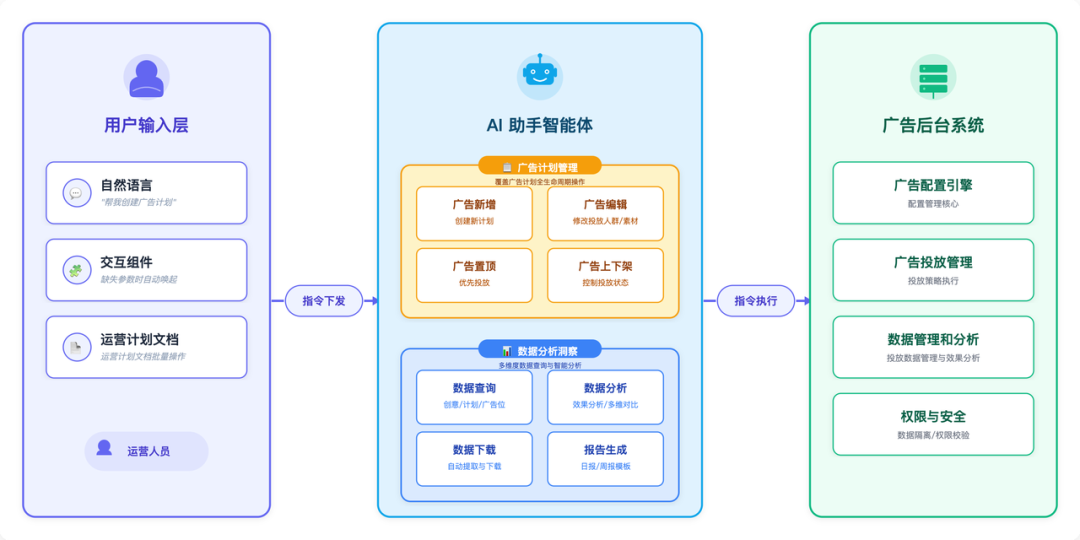
对话框的数据输入形式,除支持自然语言外,还支持通过交互组件和运营计划文档进行输入。由于在营销广告业务中,并非所有场景下自然语言输入的效率都最高,我们结合业务场景及运营习惯,引入了多元化的输入方式:
自然语言
广告运营人员用自然语言输入配置目标,如“帮我创建广告计划”、“帮我修改广告计划”。
交互组件
当自然语言输入缺失关键参数时(例如输入“修改广告计划1111投放城市”但未提供具体城市),系统会自动唤起前端交互组件,引导用户补充数据。
运营计划文档
即飞书表格形式的广告操作计划,适用于批量操作场景。当涉及海量数据时,自然语言输入效率较低,此时可直接导入运营计划文档,由 Agent 自动解析并执行。
2.2.2 广告AI助手智能体
广告计划管理
广告计划管理 覆盖广告计划从创建、配置、修改到上下架的全生命周期操作。
功能操作 |
能力说明 |
对话框交互形式 |
| 广告计划配置 | 创建新的广告计划 | 运营计划文档+交互组件 |
| 广告计划修改 | 修改投放人群、调整素材等 | 自然语言/运营计划文档/交互组件 |
| 广告计划置顶 | 置顶计划使其优先投放 | 自然语言/运营计划文档/交互组件 |
| 广告计划上下架 | 控制计划的上下架状态 | 自然语言/运营计划文档/交互组件 |
数据分析洞察
数据查询:支持用户权限范围内的多维度数据查询,包括广告创意、计划、广告位等配置数据与指标数据。
数据分析:支持广告投放效果分析及多维数据对比分析。
报告生成:支持按特定模板自动生成数据分析报告(如广告位投放日报、周报等)。
数据下载:用户在对话框中输入取数目标,数据洞察 Agent 自动执行目标数据的提取与下载。
三、技术架构与实现
3.1 整体技术架构
广告 AI 助手智能体的整体架构分为五层:
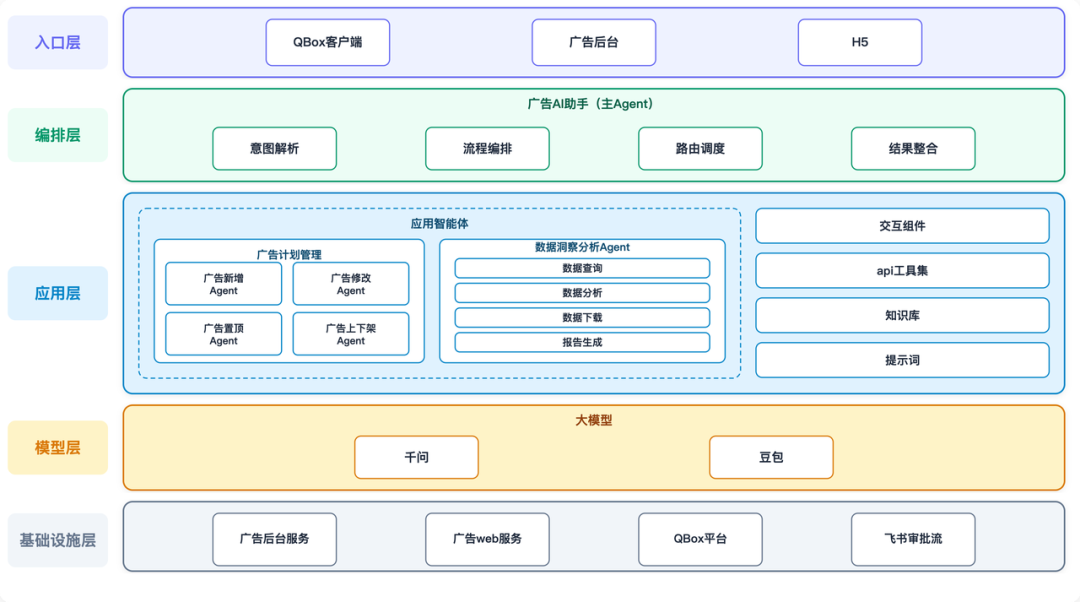
入口层:作为统一访问入口,用户可在此使用各项功能。其中 QBox 客户端为货拉拉自研的 AI 桌面客户端。
编排层:由主智能体(主Agent)构成,负责对用户提示词进行意图识别与流程编排,并调度子智能体完成目标。
应用层:承接广告计划管理与数据洞察分析等核心业务能力。基于大模型能力,通过调用 API 工具集及前端交互组件实现用户目标。
模型层:根据不同业务场景,路由至通义千问(Qwen)或豆包(Doubao)等大模型。
基础设施层:为应用层提供基础支撑,包括广告管理服务、数据查询与提取、前端交互组件、对话上下文管理等。
3.2 详细技术实现
3.2.1 广告计划管理
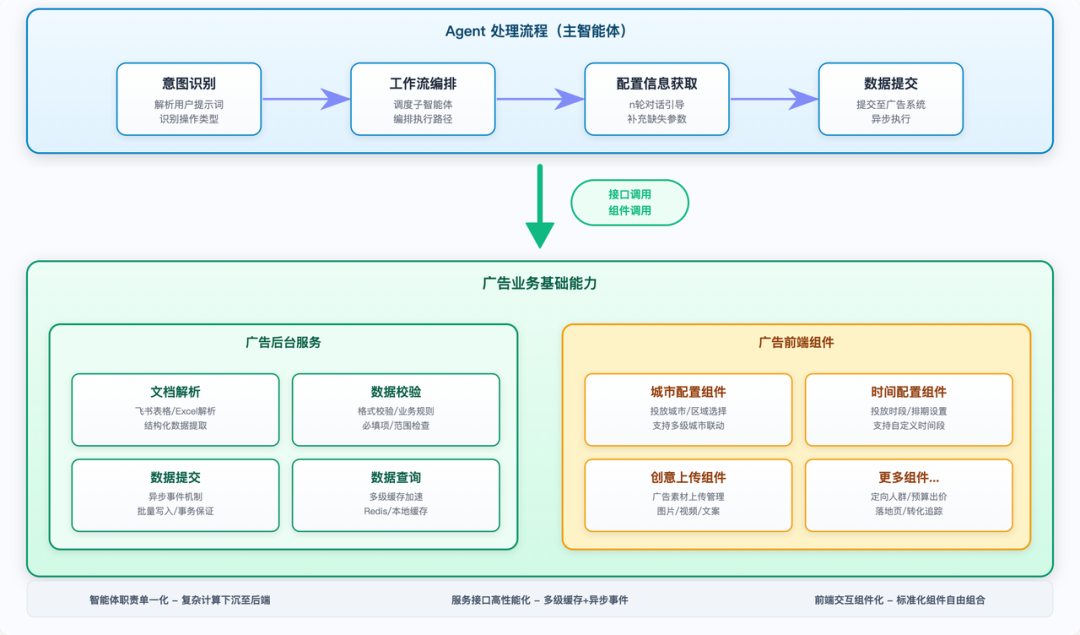
用户输入提示词后,大模型进行意图识别与工作流编排。按照工作流调用相关 API 及组件,经过多轮对话引导用户进行数据输入和确认,最终将操作结果提交至广告系统。
智能体职责单一化:在实现时,我们尽可能让 Agent 处理流程轻量化。整个流程仅涉及意图识别、流程引导、工具调用和简单参数生成。实践发现,复杂逻辑和大数据量场景容易导致大模型出错或流程卡顿。简化流程后,对话响应速度显著提升,运行更加稳定。
服务接口高性能化:在实际业务中,若采用运营计划文档方式,会涉及大量数据解析,后端接口耗时较长。为优化体验,后端引入了多级缓存、多线程并发处理及异步事件机制,确保在大数据量下依然流畅。
前端交互组件化:并非所有场景均适合纯自然语言交互(如广告创建涉及字段繁多)。因此我们在对话框中引入了富交互能力,将广告配置拆分为一系列标准化组件(如城市配置、时间配置、创意上传组件等),通过组件的自由组合满足多样化场景。
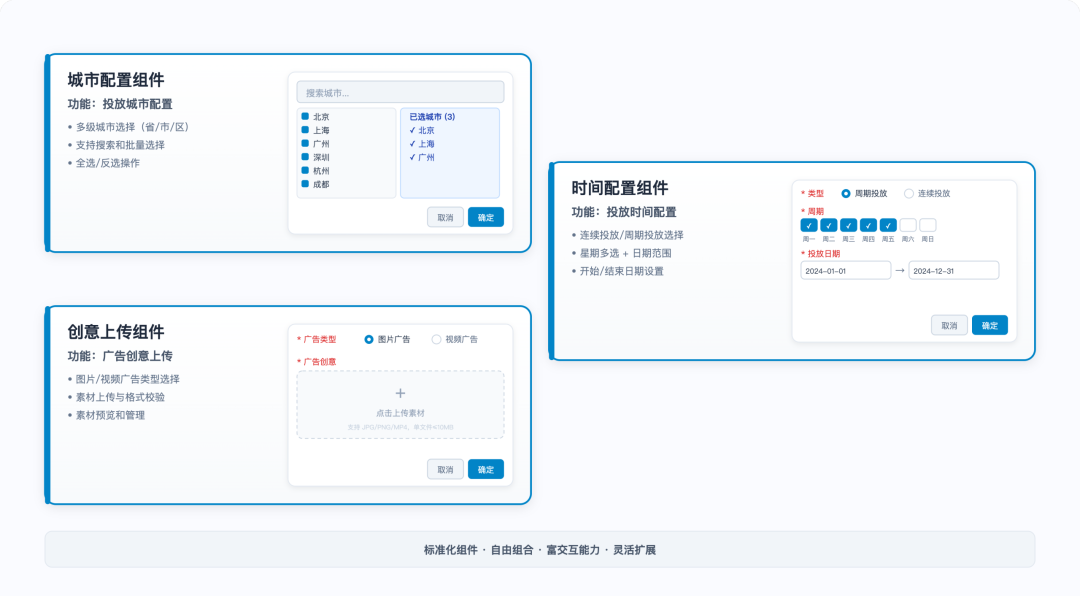
通过组件化处理,使得功能更灵活,场景更丰富。
3.2.2 数据分析洞察
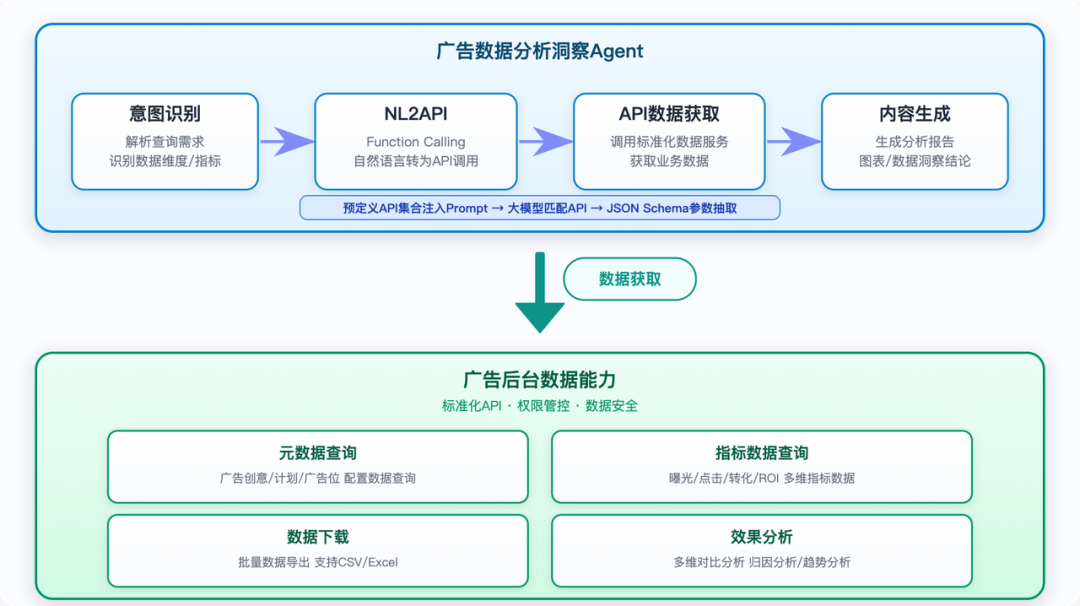
自然语言转 API 调用(NL2API)
在数据分析场景中,我们并未采用直接生成 SQL(NL2SQL)的方式去查询底层数据库,而是采用了 NL2API(Natural Language to API) 的架构。这主要是出于数据安全、权限管控以及复杂业务逻辑封装的考虑。后端已将数据查询能力封装为标准化的数据服务 API,Agent 的核心任务是将用户的自然语言精准转化为对这些 API 的调用。
语义理解与 API 路由 (Intent & API Routing)
当用户输入查询需求(如“帮我看看昨天北京地区司机端弹窗的点击率”)时, Agent 首先进行意图识别。我们利用大模型的 Function Calling(函数调用) 能力,将后端预定义的数据查询 API 集合(包含 API 名称、功能描述、参数 Schema)作为 Tools 注入到 Prompt 中。大模型根据语义理解,从工具集中匹配最合适的 API(如 get_ad_placement_metrics)。
实体抽取与参数填充 (Entity Extraction & Slot Filling)
确定目标 API 后,大模型根据该 API 的 JSON Schema 定义,从用户的自然语言中抽取关键参数(Slot)。
维度参数:如端口(司机端)、资源位(弹窗)。
指标参数:如曝光数、点击率等。
时间参数:如昨天,前一周等。
在此阶段,为了提升准确率,我们在 Prompt 中注入了业务数据字典,将业务黑话或同义词(如“曝光量”映射为 impression_cnt)进行标准化对齐。此外,我们还在提示词中注入常见分析示例及报告模板。
四、工程化挑战与最佳实践
4.1 幻觉控制与准确性保障
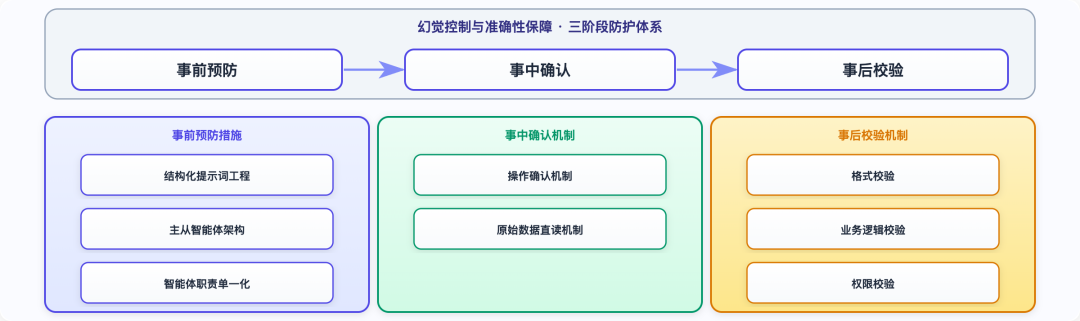
我们采用事前、事中和事后多维度措施,以尽可能抑制大模型幻觉,保障数据准确性。
4.1.1 事前预防
我们在系统设计时,采用多种预防措施尽量避开大模型易出错场景,尽可能提升agent数据处理准确性。
结构化提示词
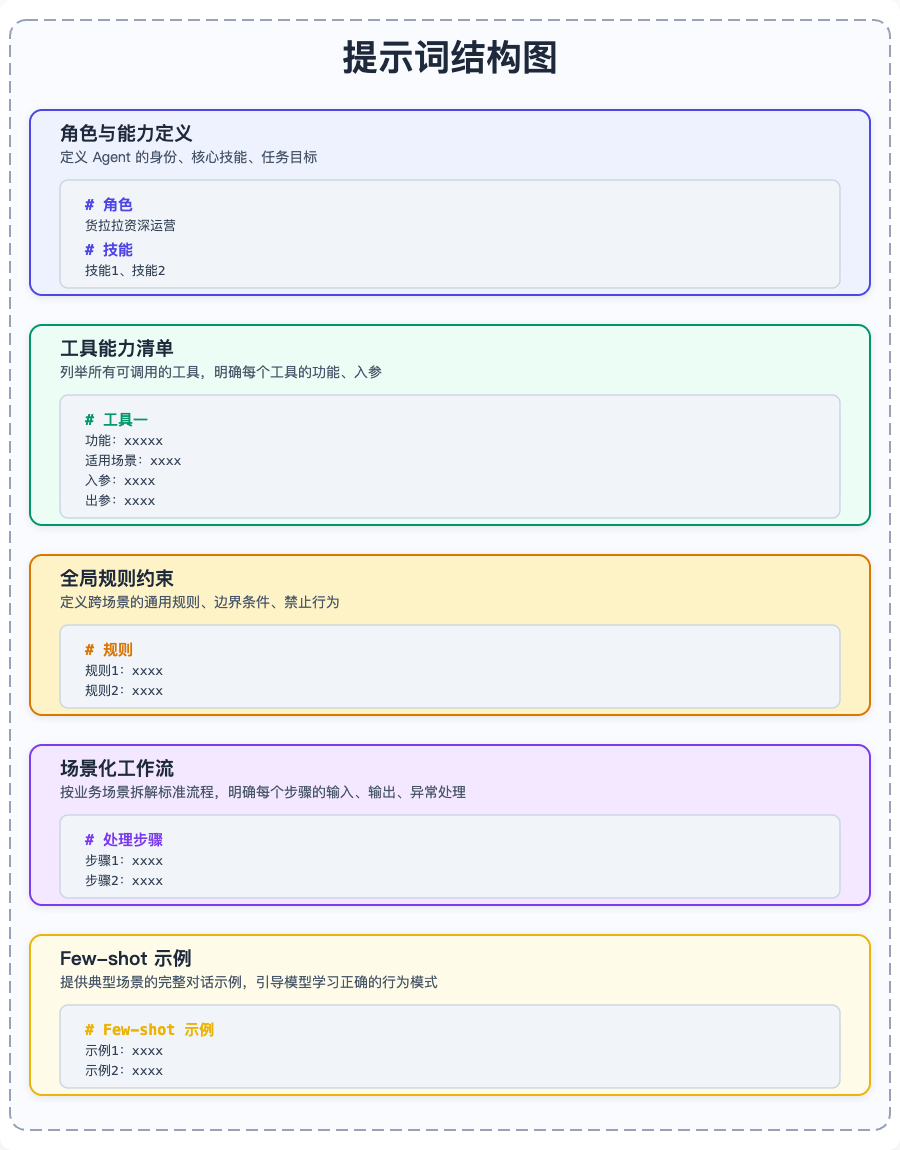
工程提示词采用“角色 → 工具 → 规则 → 流程 → 示例”的五层架构,通过“穷举式工具描述 + 场景化流程编排 + Few-shot 示例引导”,构建完整的 Agent 行为约束体系。
主从智能体
由于各业务场景的处理流程、边界与分支条件存在差异,若采用单一智能体处理所有场景,会导致执行路径过于复杂,幻觉与出错概率显增加。因此,我们拆分为广告创建、编辑、置顶、上下架、数据洞察等子 Agent。主 Agent 负责意图分流,子 Agent 专注特定场景,有效降低出错率。
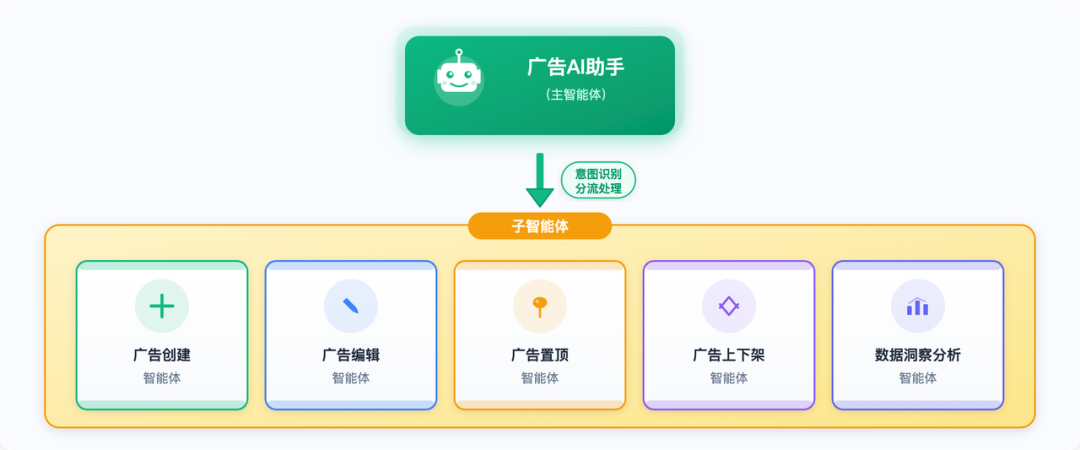
智能体职责单一化
为避免大模型处理复杂逻辑和海量数据,将复杂计算与数据处理下沉至后端服务,让大模型回归“意图理解与流程调度”的本质。
4.1.2 事中确认
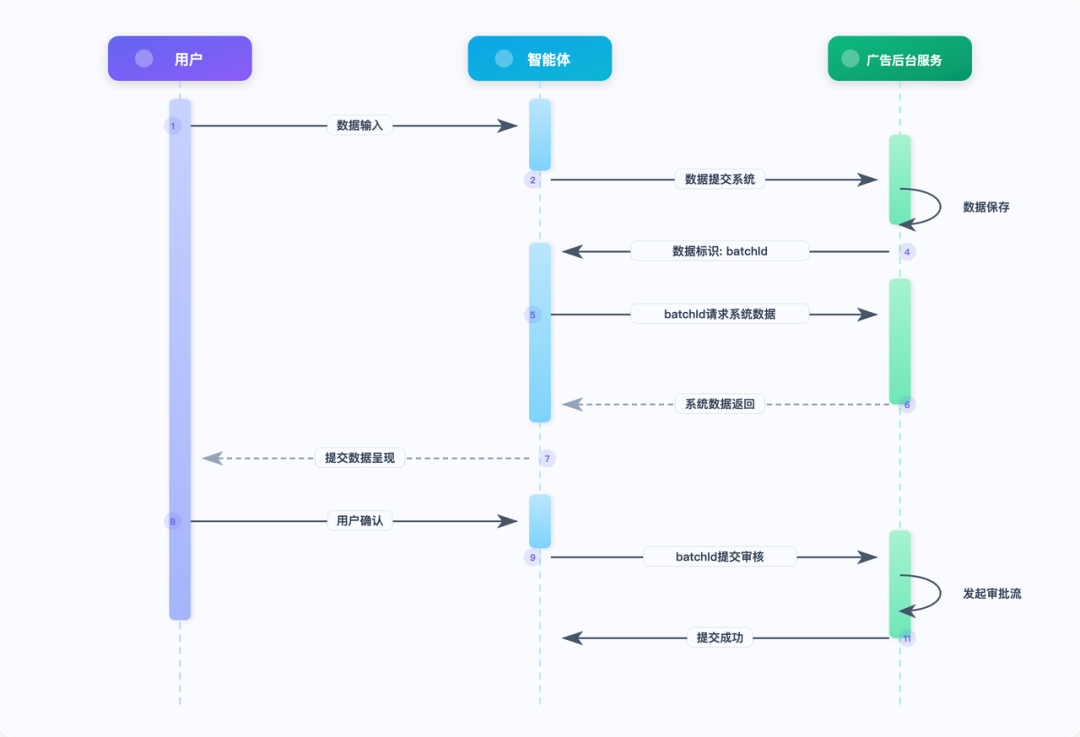
在数据写入场景中,由于大模型固有的不确定性,其处理后的数据可能与用户预期存在偏差。为此,我们在提交前引入了数据确认机制。
如何保证“所见即所得”:大模型处理后的数据提交至后端生成 batch ID(数据标识ID)。在确认环节,前端通过 batch ID 直接获取后端存储的原始数据进行渲染,数据从获取到呈现绝不经过大模型二次处理,确保确认数据的绝对真实
4.1.3 事后校验
在数据写入场景,用户提交数据后,系统会对数据进行严格的格式与业务逻辑校验,确保数据完全符合广告系统的底层要求。
4.2 数据安全与权限管控
4.2.1 数据隔离机制
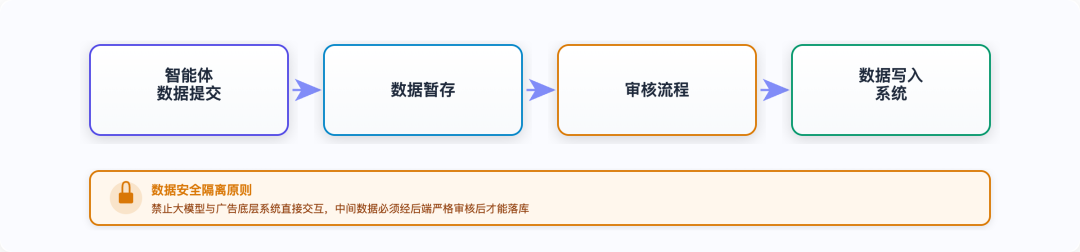
在数据写入场景中,若 Agent 直接操作底层系统,存在较高风险(如严重幻觉或遭遇提示词注入攻击)。为此,我们在工程实现上禁止大模型与广告底层系统直接交互。大模型仅生成中间态数据(变更指令),这些中间数据必须经过后端严格的业务逻辑审核后,才能最终落库应用。
4.2.2 权限校验机制
为防止越权操作,在所有数据查询和写入接口中,均强制增加了权限校验逻辑,严格拦截无权限的访问与操作。
五、总结与展望
5.1 落地效果总览
5.1.1 落地效果
异常广告数据分析
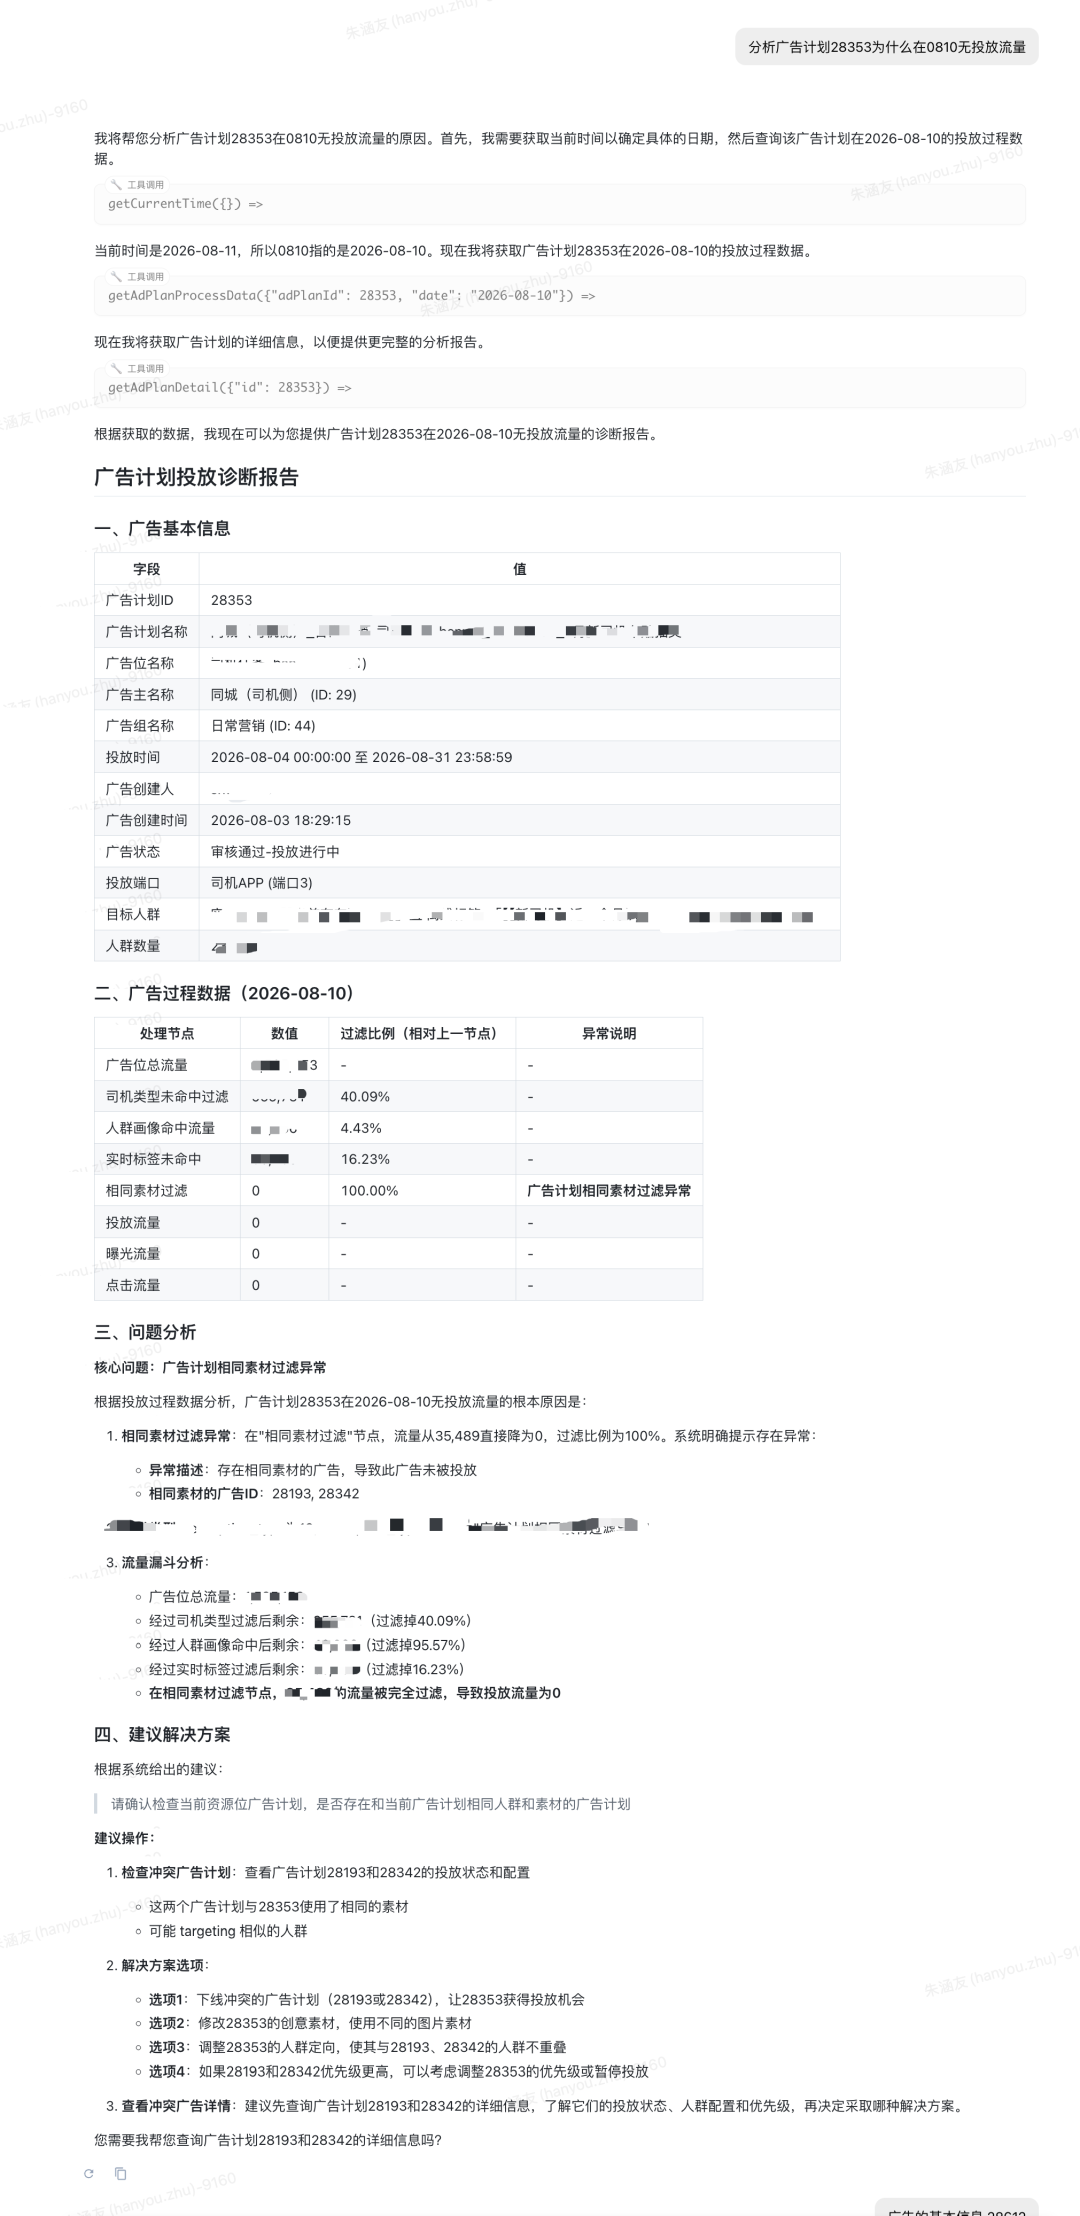
分析异常广告未投放原因(上图所示)
广告指标数据查询和分析
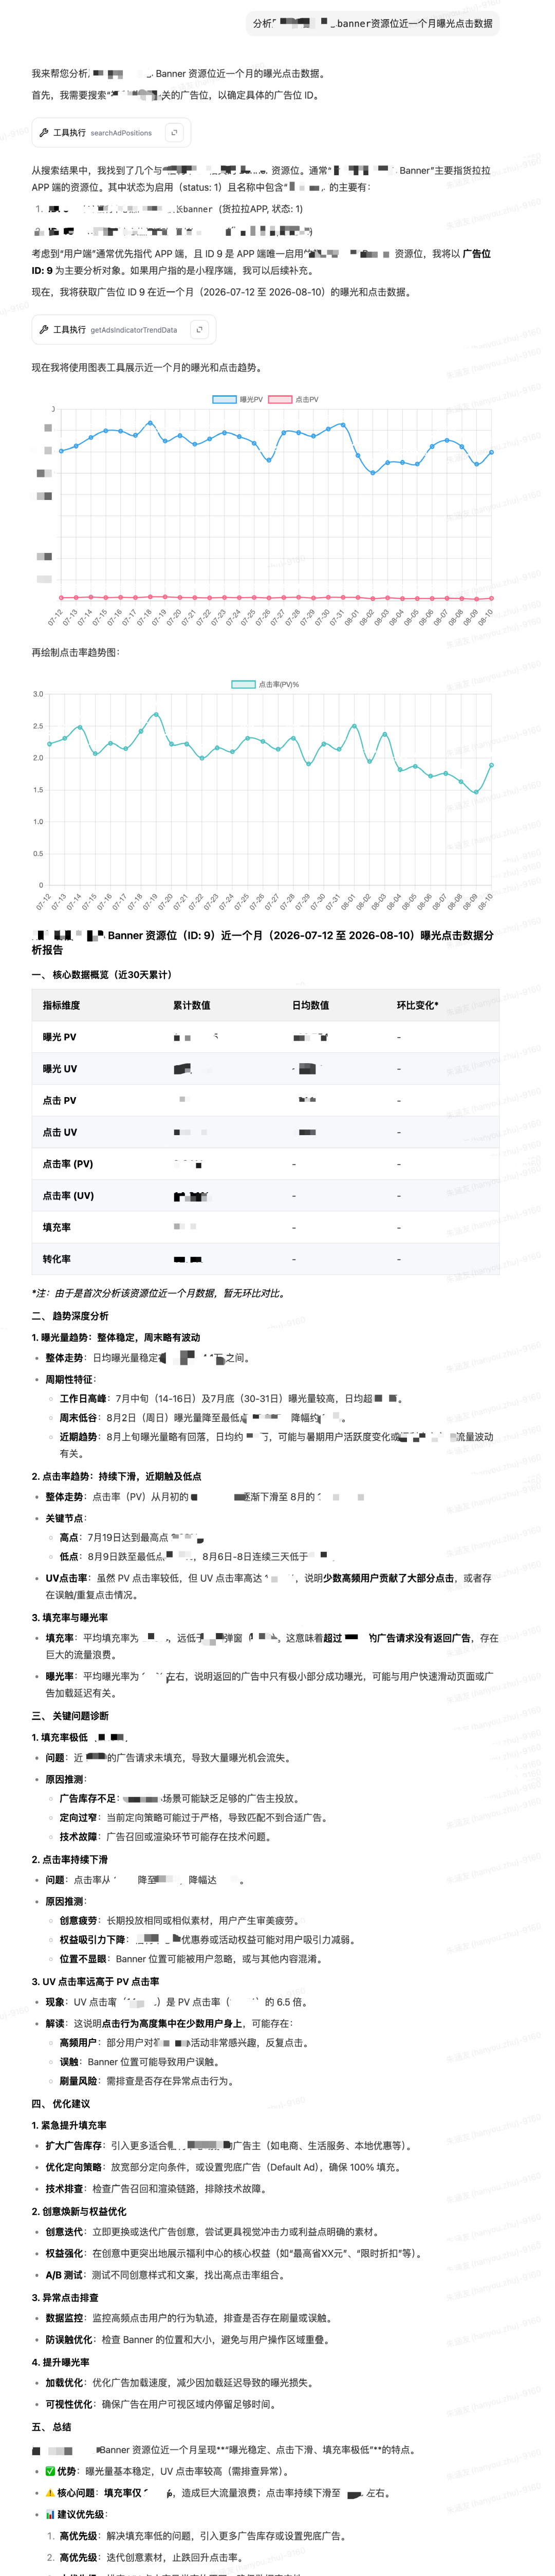
广告位指标数据进行查询分析(上图所示)
广告计划创建
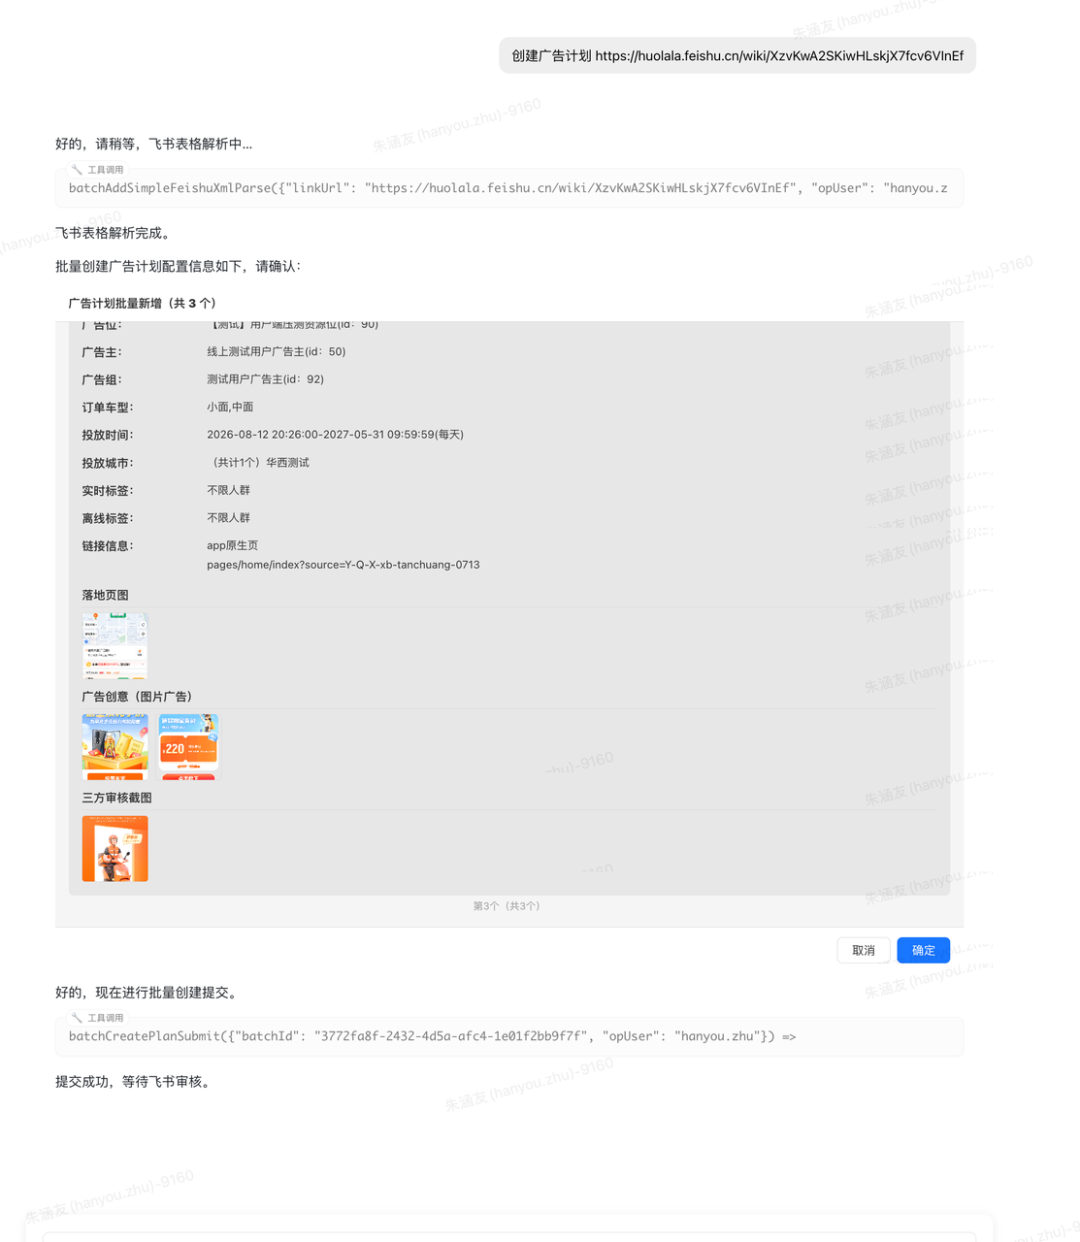
根据运营计划文档创建广告计划(上图所示)
广告计划修改
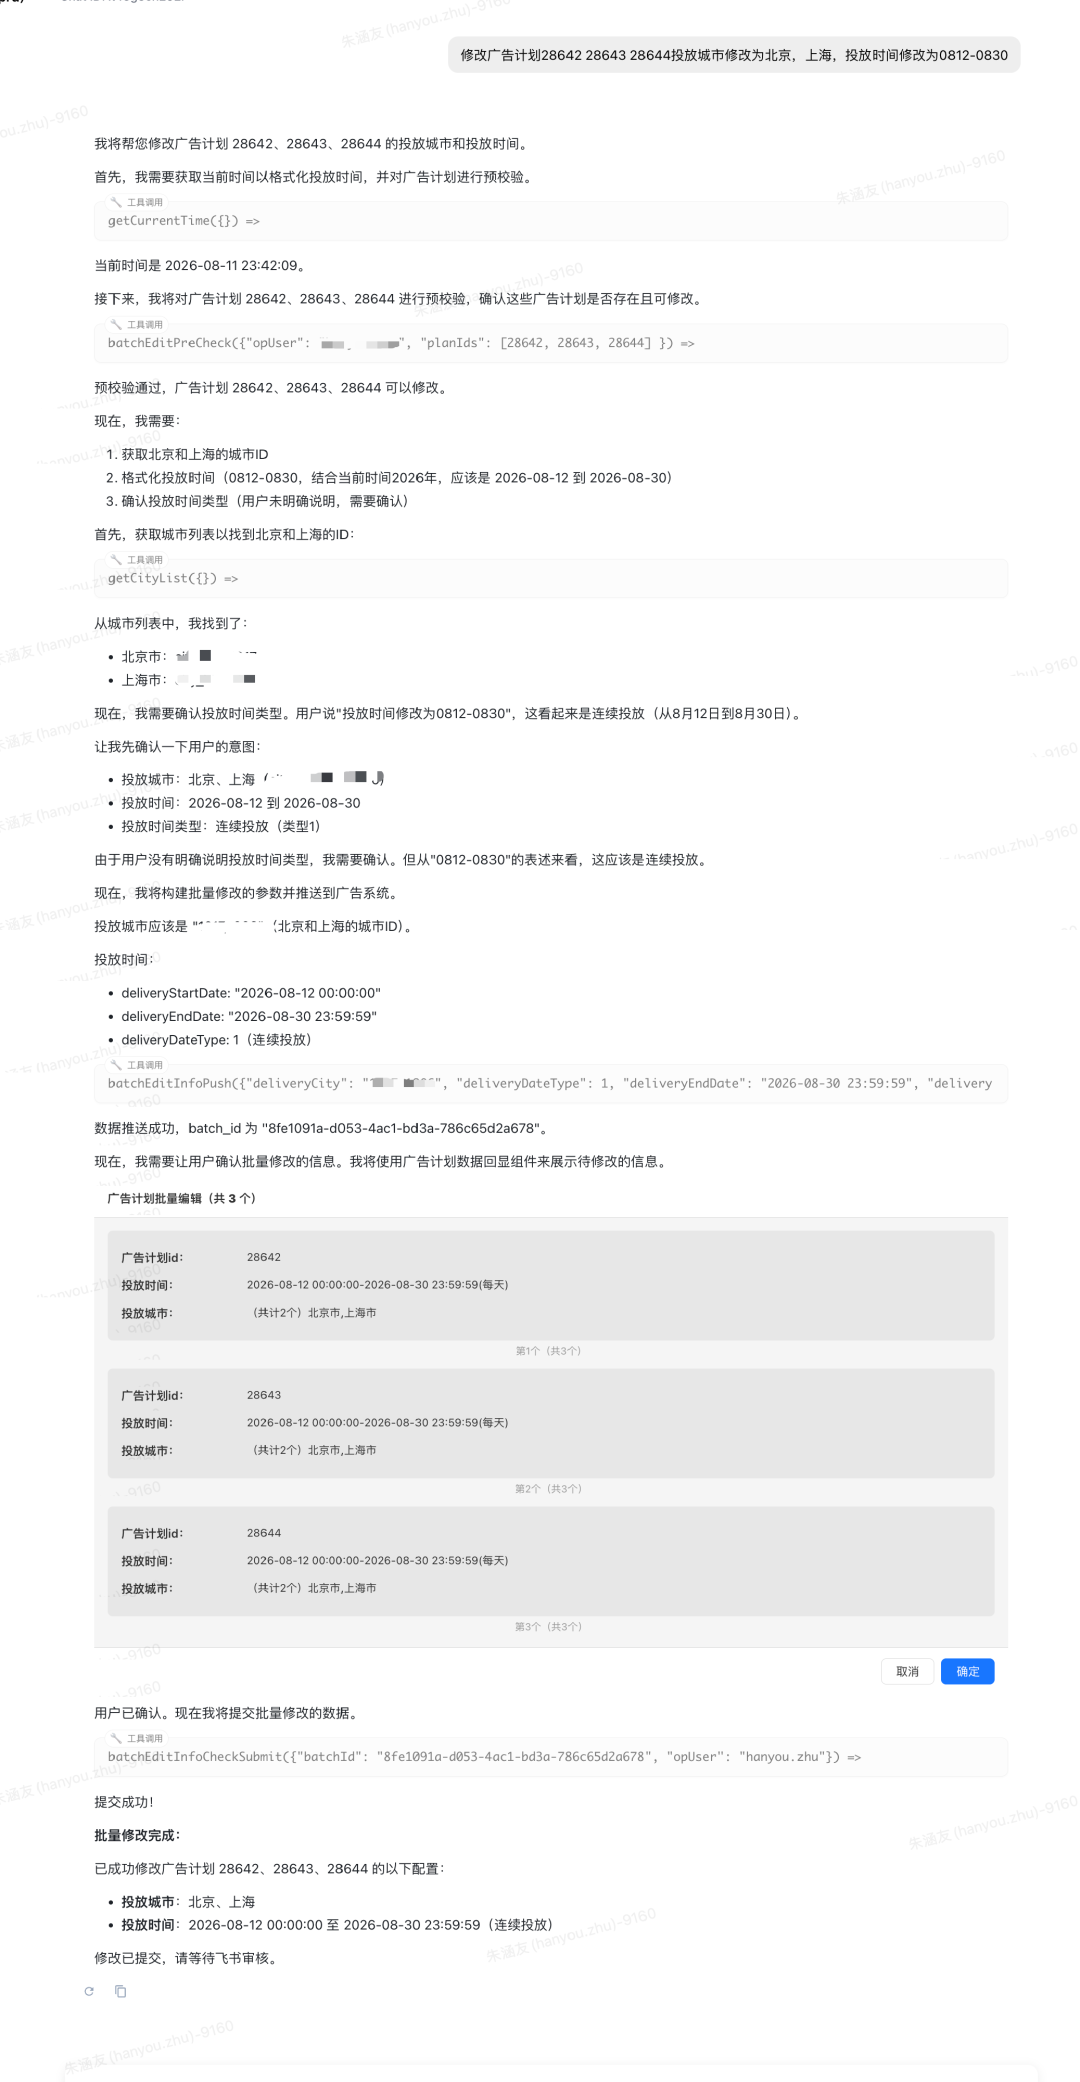
自然语言快速修改广告计划(上图所示)
5.1.2 落地收益
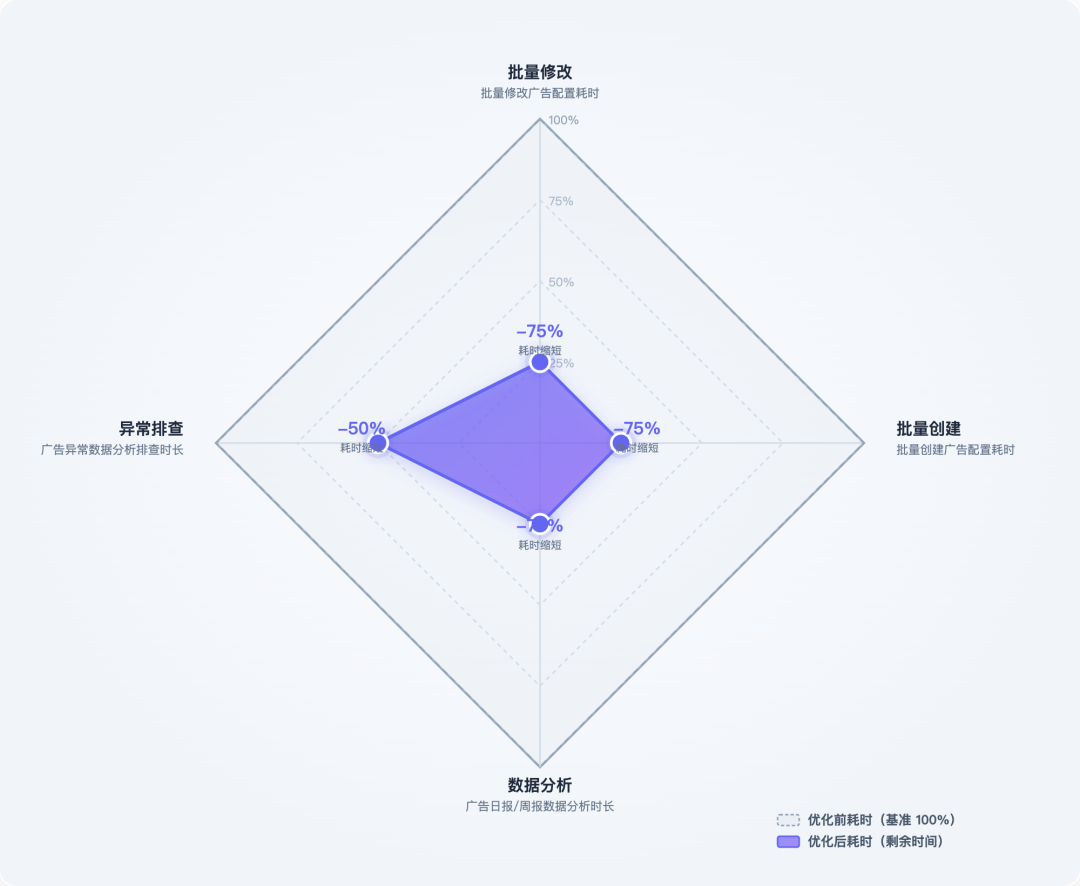
上线后,批量修改广告配置耗时缩短 75%,批量创建广告配置耗时缩短 75%,广告日报/周报数据分析时长缩短 75%,广告异常数据分析排查时长缩短 50%。
5.2 核心经验沉淀
大模型是不可靠的,需使用工程化手段使系统可靠。
在实践中发现,大模型在大量级文本处理和数据计算场景时不稳定,易出现幻觉问题,导致执行动作和用户预期不符,从而引发用户体验甚至用户对系统不信任的问题。可根据实际情况,对确定性要求高的场景,用函数调用方式处理,避免大模型处理复杂逻辑。
大模型做业务功能开发,需取长避短,贴合业务,才能提质提效。
并非所有业务都适合用大模型做开发,目前的大模型能力很难做到完全自主执行。大模型的主要优势在于自然语言理解和内容生成能力、泛化推理能力、强大的知识库。在做业务功能开发时,需紧扣业务场景细节,利用大模型的优势,去解决特定业务场景问题。
如在广告创建场景中,无法通过一句简单的提示词完成广告计划全自动化创建,如果依赖用户提示词创建,则提示词会很长,本身的效率并不会优于传统交互,且易出现幻觉,导致配置出错。但是可以利用大模型自然语言理解和泛化推理能力,理解用户提示词,并做流程引导,完成广告计划创建或编辑。
组件化能力运用,使功能更加灵活,维护成本低。
本案例将广告配置子模块抽象为前后端组件,通过组件化改造很好地将各个功能子模块嵌入到对话流程中,广告计划管理的多个流程共用一套组件能力。通过组件的自由组合,满足更多业务场景。如在广告计划修改场景中,根据提示词调用一个或多个组件,对广告计划部分数据进行修改。
展望未来
我们基于大模型能力,对广告系统管理流程及数据查询分析流程进行了深度改造,打造了交互更高效、功能更强大的广告 AI 助手。实践表明,将大模型能力与工程化手段深度结合,能够为以广告系统为代表的营销后台业务显著提质提效。
目前企业内部存在大量类似的营销子系统,各系统由不同团队维护,存在数据与操作割裂。而运营人员在多数场景下需跨系统操作,一次完整的营销动作往往涉及多个系统的联动,费时费力。
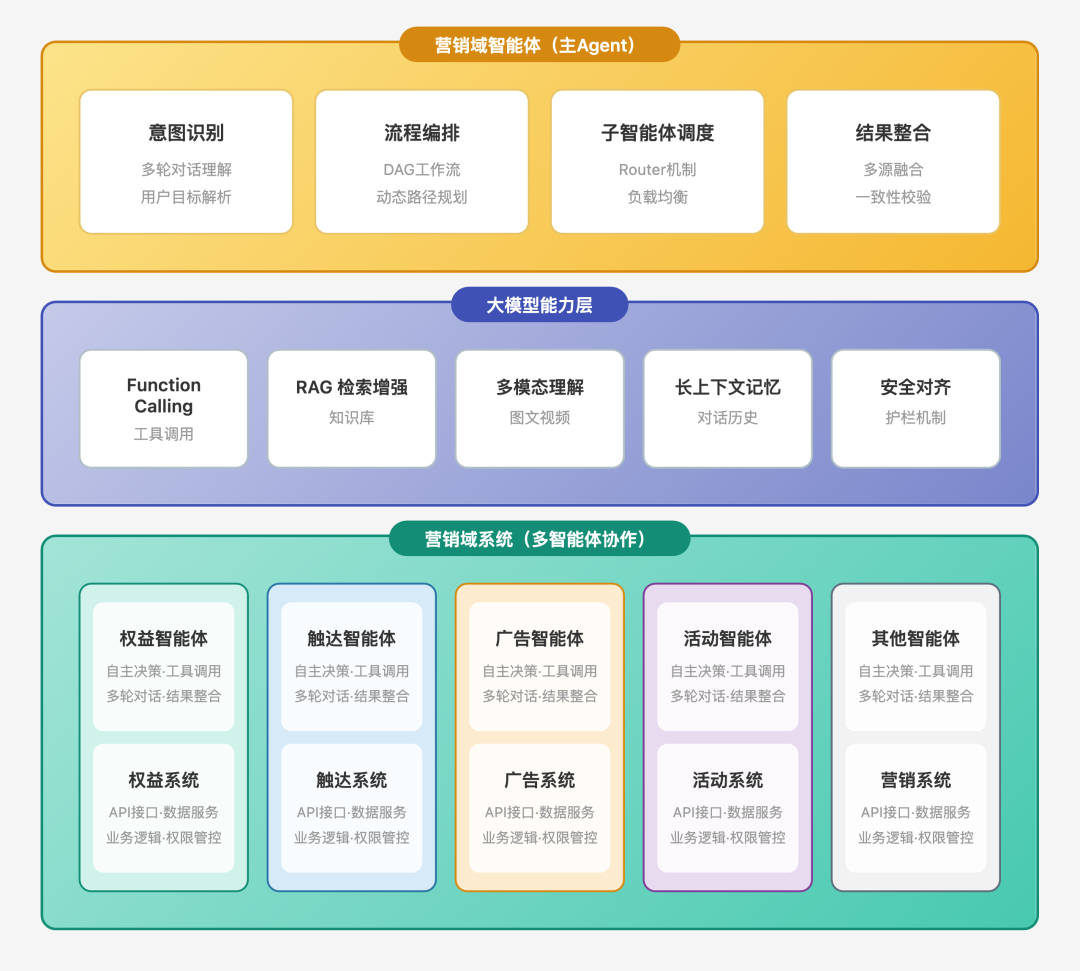
未来,我们计划构建一个营销域全局智能体,打通各营销子系统。用户只需在一个统一的 Agent 入口进行交互,借助大模型的理解、推理、流程引导及工具调用能力,即可完成一次完整营销活动的全链路配置,真正实现营销业务的“一站式”智能化
本文作者@货拉拉技术。原文链接:https://mp.weixin.qq.com/s/u0LW3Ve3H5up00CBL0z7_Q