因为代码数据上传风波闹了十来天,智谱 ZCode 的新一轮补偿方案终于来了。
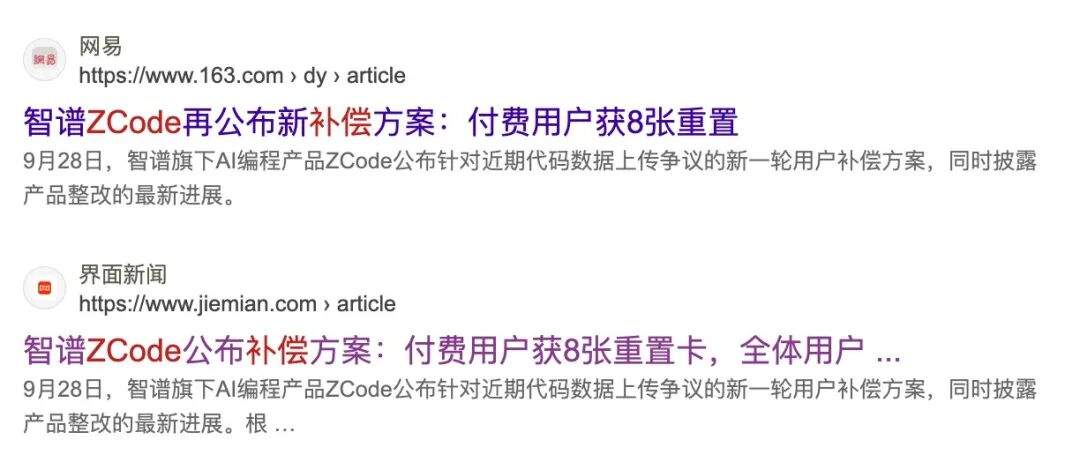
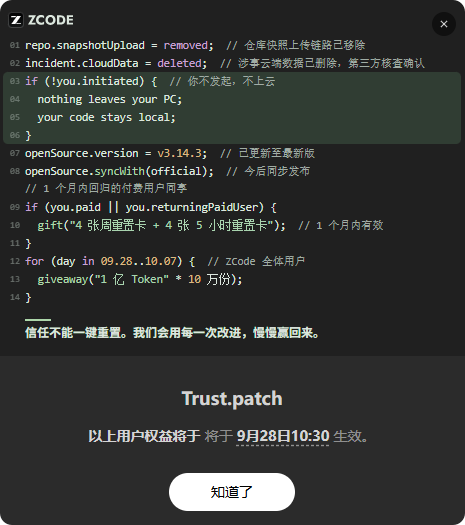
付费用户,以及未来一个月内回归的付费用户,可以拿到 4 张周额度重置卡 + 4 张 5 小时额度重置卡,一共 8 张,有效期一个月。
免费用户也有。从 9 月 28 日到 10 月 7 日,ZCode 连续发 Token,单份额度 1 亿 Token,不过数量有限,需要抢。
看到“1 亿 Token”,第一眼确实挺唬人。但经常用 AI Coding 的人应该知道,现在 Agent 扫项目、读文件、反复修改、跑多轮推理,Token 消耗起来非常快。1 亿额度拿来体验当然够用,真把它当主力生产力工具,也谈不上多夸张。
至于付费用户这边,8 张重置卡只能说是有补偿。毕竟这次捅出来的是代码和数据安全问题,对一款AI Coding产品来说已经碰到了信任底线。真要表达诚意,多送几十张卡我都觉得不过分。
这个评价点到为止。
因为比“送多少”更有意思的,其实是这场风波本身。它可能提前暴露了一个所有 AI Agent 厂商接下来都会遇到的问题:
当 AI 开始接管我们的电脑,它到底能拿走多少东西?
01.一个313MB的加密包,把ZCode送上了风口浪尖
这场事情的起点,其实很有戏剧性。
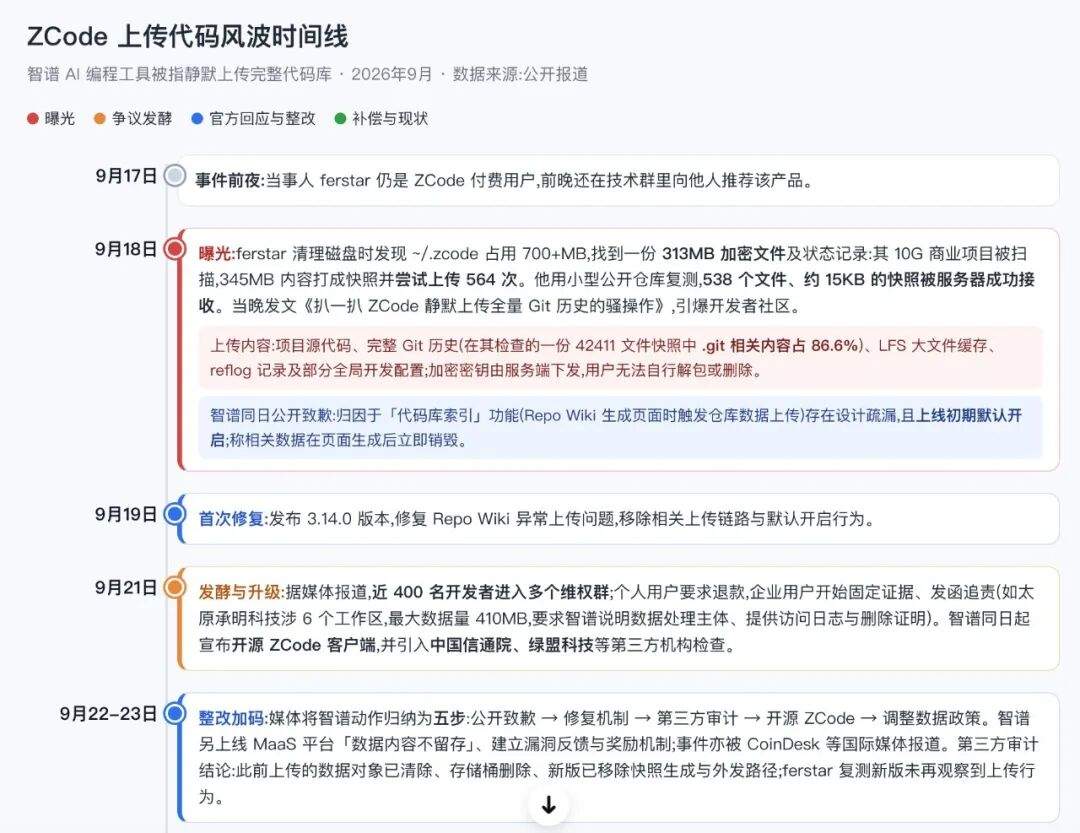
9月18日,一位 ZCode 付费用户在清理自己 256GB MacBook Air 的磁盘空间时,发现 ZCode 的目录占用了 700MB 以上。
继续往里面翻,他找到了一个大约 313MB 的加密文件。
这就很奇怪了。
一个 AI 编程工具,为什么会在本地产生这么大的加密文件?
顺着这个文件继续排查,开发者发现,它和自己的代码工作区有关。随后越来越多开发者开始检查 ZCode 的运行逻辑,并在 GitHub 上提交 Issue。有人发现客户端存在工作区快照打包及上传链路,还有用户反馈,在相关设置没有主动开启的情况下,也观察到了仓库快照记录。
这一下,事情的性质就变了。
如果只是 AI Coding 在运行过程中读取当前代码,开发者其实早有心理准备。你让 Agent 修 Bug,它当然得看代码。
但读取本地代码和把代码打包后传到云端,在开发者眼里完全是两个风险等级。
尤其 Git 仓库这个东西,比很多人想象得还要“脏”。
当前代码可能看着没什么问题,但 .git 里还保存着历史提交。你三个月前误传过一个 API Key,后来删掉了;某个测试数据库密码曾经写进配置文件,后来换掉了;已经下线的业务代码、内部域名、接口结构,也可能继续躺在历史版本里。
对普通用户来说,一个项目就是几个文件夹。
对一家公司来说,一个完整 Git 仓库可能就是最核心的一批数字资产。
所以开发者看到“整个工作区快照”几个字,反应会比普通 AI 用户激烈得多。
你想象一下,如果一款 AI 办公软件偷偷把你整个“公司资料”文件夹压缩了一份,然后告诉你“放心,只是为了帮你生成摘要,用完就删”,估计你也很难淡定。
02 智谱这次反应其实不算慢
事情发酵后,ZCode 很快给出了解释。
按照智谱的说法,问题来自“代码库索引”功能。这套机制原本服务于会话检查点恢复、历史版本回退以及 Repo Wiki 等能力,其中 Repo Wiki 在云端生成代码仓库说明页面时,可能触发仓库数据上传。
麻烦就出在这里。
这个功能上线初期默认开启,部分用户因此受到了影响。智谱随后表示,上传的数据在 Wiki 页面生成后会销毁,不进行保存。
但在数据安全问题上,“我们已经删了”这句话天然说服力有限。
尤其面对程序员。
这群人最大的特点就是:你最好让我自己看。
于是智谱后面做了几件比送 Token 更重要的事情。
9 月 19 日,ZCode 推出 v3.14.0,移除 Repo Wiki,同时切断本地仓库快照生成和上传链路。随后智谱邀请中国信通院和绿盟科技进行安全审查。中国信通院确认相关阿里云 OSS 存储桶处于“云端零数据”状态;绿盟科技确认相关数据对象和存储桶已经删除,新版客户端也没有发现能够触发本地仓库快照或文件外发的路径。
9 月 21 日,ZCode 又把源代码直接扔到了 GitHub。
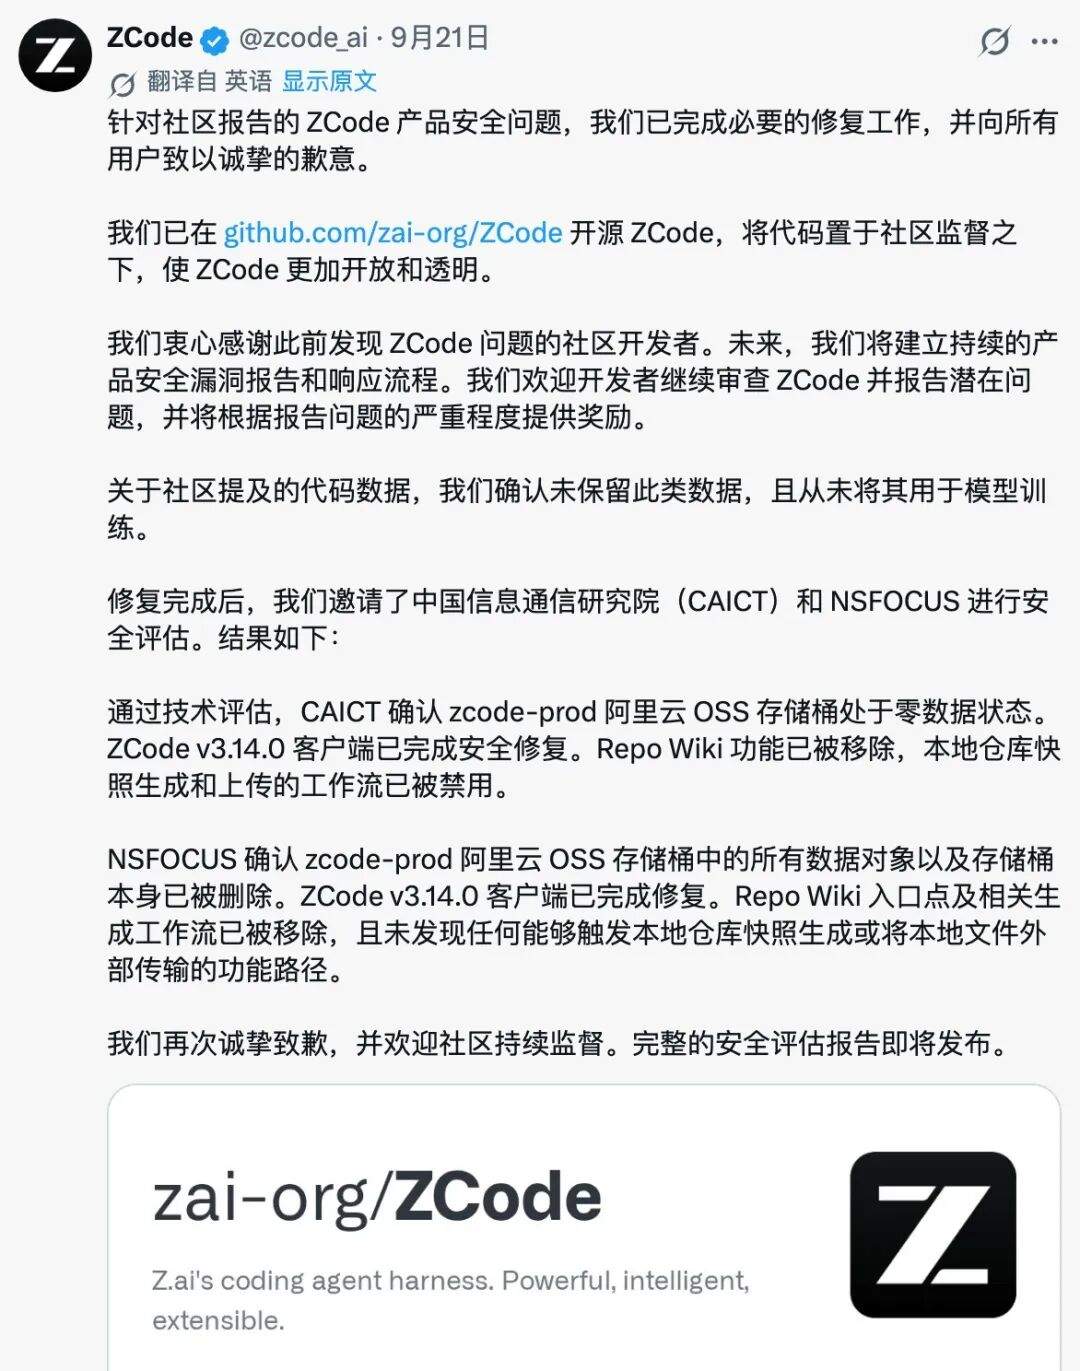
截至目前,ZCode 的客户端、后端服务、共享 UI,以及 Agent CLI 和运行时源码都已经公开。
我觉得这一步其实挺关键。
因为对于这种事情,最有效的公关文案永远干不过一句:
代码在这,你自己看。
当然,开源也没法让已经发生的事情消失。但至少以后再有人怀疑 ZCode 后台偷偷做了什么,不需要完全依赖厂商自己解释,开发者可以直接审代码、抓网络请求、提交 Issue。
某种程度上,这场危机反而逼着 ZCode 把产品透明度往前推了一大步。
03.AI Coding最危险的地方,恰恰是它太能干了
这件事如果只停留在 ZCode,其实有点可惜。
因为未来类似争议大概率还会出现,而且未必只发生在 Coding 产品上。
过去使用 ChatGPT、Kimi、豆包的时候,用户和 AI 之间的边界很好理解。我复制了一段文字给你,你就看到了这段文字;我上传一份 PDF,你就处理这份 PDF。
Agent 把这个逻辑彻底打乱了。
现在你跟 Coding Agent 说一句:
“帮我看看这个项目为什么跑不起来。”
它可能自己打开几十个文件,搜索整个项目,检查配置文件,查看 Git 记录,跑终端命令,再去网上查文档。
用户只说了一句话,AI 背后已经干了几十件事。
办公 Agent 以后也是一样。
“帮我准备明天和客户开会的材料。”
这句话背后可能意味着读取邮件、日历、聊天记录、网盘文件、历史会议纪要,甚至登录 CRM。
Agent 越能干,用户越难知道它这一秒到底在访问什么。
这才是接下来最麻烦的地方。
我们过去讨论软件权限,通常是“允许访问相册”“允许使用麦克风”。
Agent 时代的权限会细得多:
它能不能读这个文件夹?能不能读 Git 历史?能不能上传云端?能不能把数据发给第三方模型?能保存多久?一次授权管一次任务,还是以后都能访问?
这里任何一个地方含糊,最后都有可能变成安全事故。
04 隐私保护,正在从法律条款变成产品功能
其实海外几家 AI Coding 产品已经开始往这个方向卷了。
Cursor 现在专门提供 Privacy Mode。开启后,Cursor 表示客户代码不会用于训练,并与模型供应商签有零数据留存协议;团队版和企业版还可以由管理员统一强制开启。Cursor 的企业产品甚至已经提供审计日志、模型访问控制以及 Agent 权限管理等功能。
GitHub Copilot 对企业用户也把不同使用场景的数据保留期限直接写了出来。比如 Business 和 Enterprise 用户通过 IDE 使用 Chat 和代码补全时,默认不保留 Prompt 和 Suggestion;其他部分场景则会有明确的保留周期。
这里当然不是说谁就绝对安全。
我更感兴趣的是一个趋势:
以前隐私政策藏在几十页用户协议里,现在它开始变成产品界面上的一个开关。
甚至会慢慢变成卖点。
以后企业采购 AI Coding 工具,问的问题可能不再只有“你家模型写代码有多强”“一个月多少钱”。
安全负责人可能会直接问:
代码出不出公司?经过几个服务器?用了哪些第三方模型?日志留多久?管理员能不能禁止某个模型?员工调用 AI 的记录能不能审计?
这些问题答不上来,模型 Benchmark 再高也未必进得了公司。
这也是为什么我觉得 ZCode 这次风波挺有代表性。
现在 AI 厂商都在想尽办法让 Agent 获得更多权限,因为权限越大,AI 能做的事情越多,Demo 也越震撼。
但对用户来说,另一条线也会越来越重要:
你可以很聪明,但别背着我干活。
尤其别背着我动数据。
ZCode 这次已经把仓库快照上传链路砍掉,也把代码开源接受社区监督。从处理动作上看,该补的技术措施基本都在补。
剩下的事情更慢。
官方这次自己写了一句话:
“信任不能一键重置。”
我觉得这句话比“送 1 亿 Token”更值得记住。
Token 用完还能继续买。
AI Agent 一旦让用户开始怀疑“它是不是背着我拿了什么东西”,下一次再弹出“允许访问整个项目”的时候,人的手就会迟疑一下。
对于一款每天都要深入代码仓库的产品来说,这一下迟疑,可能比少几百万 Token 贵多了。
本文由作者@人人都是产品经理,授权发布于平台,未经许可禁止转载。