

2026年,字节Seed完成一轮面向产品化的组织调整。30岁不到,博士毕业2年的秦禹嘉接过大旗,成为Product Posttrain-Work团队负责人。
Product Posttrain-Work面向B端与办公场景,要把Agentic模型整合进产品,并把任务规划、工具使用和最终交付做得更稳定。客户需求简洁明了:把资料丢给Agent,模型能够明确任务、做好长程规划、自动补全信息、精准调用工具,并交付出一份能够直接使用的结果。
在过去的学习与研究中,秦禹嘉都在围绕这一目标不断前进。2023年,秦禹嘉发表的WebCPM让模型像人一样去搜索和组织材料的;同年,又发布ToolLLM让模型学习选择、组合16,000多个API;2025年,他作为第一作者的UI-TARS,把模型带到人每天使用的电脑界面前,要求它看懂屏幕、移动鼠标、敲下键盘。
从检搜索到调用工具,再到操作电脑界面,秦禹嘉一直在关注同一件事:模型是否能在外部环境中连续采取正确行动。
校园时代的秦禹嘉:让大模型从“读懂解释”走向“自主探索”
一句餐厅评价写”价格fair”,标注者把它判为正面评价。但只给模型一个“正面”标签,它并不知道判断依据;换成“reasonable price”,原来的文字匹配规则可能就认不出来了。秦禹嘉参与的一项早期研究,处理的正是这个问题:能不能把人用自然语言写下的判断理由,也变成模型学习的材料?模型是否能够借助这条解释做判断,而不必等人再次标注?
2016年,秦禹嘉进入清华大学电子信息科学与技术专业,2019年夏天,他到南加州大学做访问研究,参与完成了ICLR 2020 论文Learning from Explanations with Neural Execution Tree,研究的正是尝试把标注者的自然语言解释转成模型可使用的规则,再让规则适用于措辞不同、意思相近的新句子。
论文中还标注了一个十分有意思的点:秦禹嘉与另一位作者王子祺贡献相同,共同第一作者的署名顺序是抛硬币决定的。
那枚硬币决定了署名顺序,没有决定秦禹嘉接下来的研究方向。本科毕业后,秦禹嘉在清华继续攻读计算机博士,同时在微信Pattern Recognition Group担任研究实习生。在后续的研究中,秦禹嘉尝试去解决一个更基础的问题:模型已经学过的知识,能否在下一次训练中留下来?当新数据不断出现时,能否不从头训练,就让模型跟上变化?
2021年提交的Knowledge Inheritance,研究如何让已有模型的知识帮助训练新模型;2022年的ELLE,则尝试让模型持续吸收新数据。这些论文距离今天的电脑操作还很遥远,但能看出他研究方向在不断深入:让模型充分理解自然语言解释,到让模型更有效地获得、更新知识。
到2022年,秦禹嘉在个人主页上列出的研究方向变成了“工具学习”。新的问题是:如果模型缺少完成任务所需的信息或能力,能否让它走出去,自己寻找并使用工具?
2023年,秦禹嘉作为第一作者发表了WebCPM论文。这项研究没有只把问题和标准答案交给模型,而是把人寻找答案的过程也记录了下来
设想有人提出一个需要查阅多份资料才能回答的问题。模型直接写答案,可能写得流畅,却无法保证是否有充分的依据来确保答案的正确性。
WebCPM采取了一种新的办法:让标注者使用网页搜索界面,一边寻找支持事实,一边留下搜索、浏览和组织答案的操作记录,再让模型学习这个过程。论文整理了5,500组问答、125,954条支持事实,以及121,330次网页搜索动作,将原本藏在研究者脑中的检索过程,变成了一系列可观察、可训练、可评测的行为。
模型需要先意识到自己缺什么信息,才能进入寻找环节;找回材料以后,还需判断哪些内容值得放入最后的答案当中。WebCPM解决的是其中一步:当答案不在模型已经掌握的信息里,模型要学着走出去找。
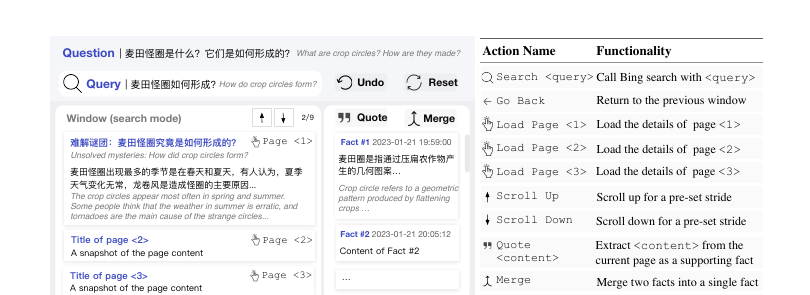
图片来源:WebCPM论文中的人工搜索界面,ACL Anthology
问题随之又往前推了一层:找到信息以后,模型能否调用外部服务,真正完成一项操作?
秦禹嘉的创业路
如果WebCPM解决的是“模型怎样找到信息”,ToolLLM推进的就是下一步:找到信息之后,模型能不能真的调用外部服务去完成任务?
2023年,秦禹嘉与梁时浩共同第一作者的ToolLLM,搭建了一套从数据构建、模型训练、API检索到评测的工具学习框架,覆盖16,464个真实世界REST API、49个类别。论文还提出工具检索等组件,帮助模型从大量候选接口中找到可能用得上的工具。
工具学习最关键的时刻,往往不是第一次调用成功,而是第一次调用没有成功之后。ToolLLM论文专门设计了搜索不同执行路径的方法:当一个调用没有把任务向前推进,模型可以退回来尝试另一条路。
秦禹嘉在一次工具学习分享中,提出”工具是人的能力延伸“,一个完整流程可被概括为:理解指令、制定计划、调用工具、接收环境反馈,再修正下一步行动。
发出一次调用并不难,关键在于第一次调用没有完成任务时,模型是否还知道接下来该怎么办。
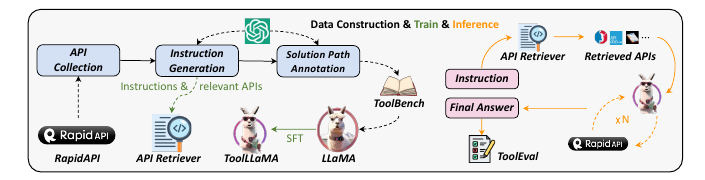
图片来源:ToolLLM论文中的ToolBench构建与训练流程
ToolLLM为模型打开了一扇通往外部软件的门。API通常有说明文档,写明需要输入什么参数、调用后会返回什么结果。模型可以据此选择工具、读取反馈,再决定下一步。但普通人使用电脑时,很少先寻找某个服务的API:他们看到的是网页上的搜索框、表格里的单元格、文件夹中的文档,以及随时可能弹出的新窗口。
要让AI真正替人完成这些任务,光会调用接口还不够。它得看懂屏幕上发生了什么,找到该点击的位置,操作之后再根据变化继续判断。秦禹嘉参与的下一项研究UI-TARS,便把模型从为程序准备的接口,带到了为人设计的电脑界面前。
UI-TARS的出现,把模型的行动空间从结构化API推进到图形界面。模型以屏幕截图为输入,不依赖预先写好的页面结构;它需要识别界面元素,判断下一步,再通过鼠标和键盘完成任务。作为原生Agent,UI-TARS在感知、定位与图形界面任务执行等10多个基准上取得领先表现。
能力向前一步,约束也随之变重。GUI Agent的风险不再只是答错一道题,也可能是点错按钮、误读权限,或在不该行动的地方行动。秦禹嘉的公开账号曾提到,GUI能力的后训练数据需要与潜在滥用风险一起权衡。当模型真正接近操作能力,问题不再只是它能做什么,也包括它能否在用户授权的范围内行动。
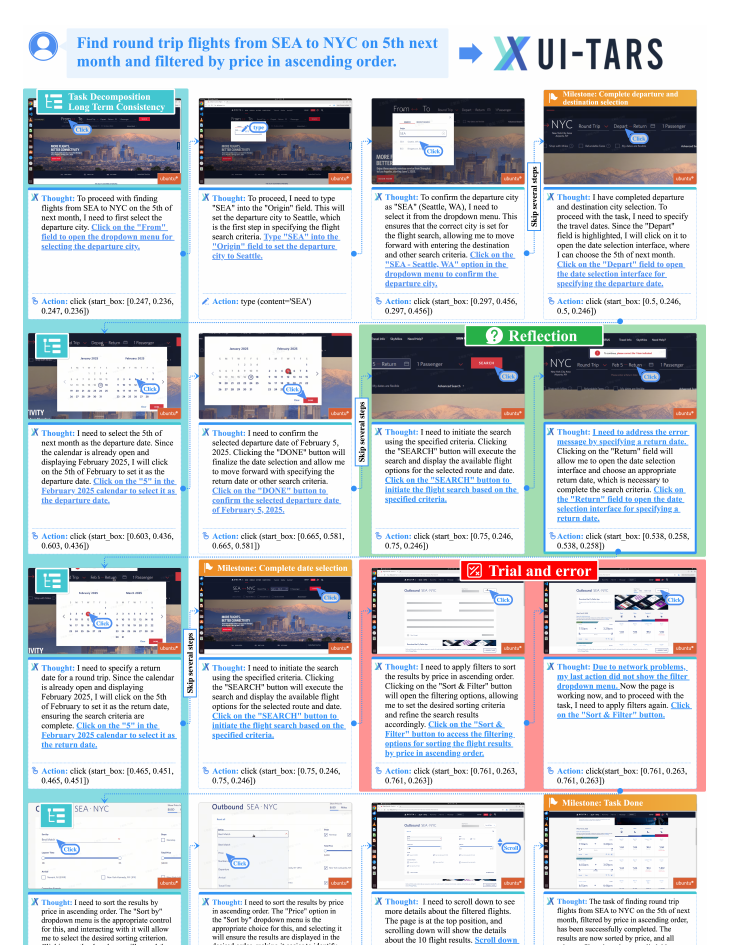
图片来源:UI-TARS论文中的GUI任务执行示例
2024年1月18日,北京序智科技有限责任公司成立,秦禹嘉为法定代表人。此次创业秦禹嘉想做的是把专家的工作方法变成能执行任务的Agent。
以撰写行业研究报告为例。资深研究员会先确定问题,再比较不同来源,剔除过时数据,发现证据不足时继续追查,最后才组织成文。序智科技的设想,是让专家将这套方法教给Agent,使其他人不必每次都从头指导。它要解决的痛点不是“写得不够快”,而是专业经验难传授、复杂任务仍需人反复拆解和盯着执行。公司还希望让专家创建的Agent和工作流可以被分享、复用,甚至交易。这个从“知识创作”走向“行为创作”的想法,在公司成立不久后获得了资本支持:序智科技完成千万级人民币天使轮融资,投资方包括英诺天使基金和水木清华校友种子基金。
研究里,任务成功通常由benchmark判定;产品里,用户只会问更直接的一句:它到底替我完成了什么?这两种检验标准之间的距离,后来会贯穿他的Seed工作。
进入Seed,执掌工作Agent业务
2024年7月,秦禹嘉加入字节Seed。在个人主页中,他将研究方向概括为基于大语言模型和视觉语言模型的Agent。
到2026年8月,Seed调整组织结构,秦禹嘉担任新成立的Product Posttrain-Work团队负责人。该团队主要服务B端应用,负责Agentic模型的整合与发布,并针对办公场景优化模型能力,支持豆包、Dola(豆包海外版)等产品的任务模式。与主要面向C端对话应用的Chat团队相比,Work要处理的是用户发出指令之后,模型如何继续执行的问题。
这支团队面对的不是单独增加一个办公功能,而是让模型在办公任务里更稳定地规划、执行并交付。对秦禹嘉而言,这也是此前几条研究线第一次在同一个产品问题里交汇:模型既要理解资料,也要使用工具、应对界面变化,这些能力能否进入真实产品,让用户真正敢把任务交给模型?
这也与Seed近期发布的模型方向相互印证。Seed2.1的发布介绍中,把项目规划、文档处理、工具使用和结果整合放进复杂职业任务中衡量,强调的是现实工作流里的交付质量,而不只是静态基准上的分数。
回头看,秦禹嘉的路线并不是从“研究”突然跳到“产品”。WebCPM让模型学习人的检索过程;ToolLLM让模型学习调用外部服务;UI-TARS让模型开始操作人类的数字界面;Product Posttrain-Work则把问题推到最难的一层:模型能否在任务模糊、工具会失败、结果要被人接手的环境里,把一件工作真的做完。
过去的论文和开源系统可以被benchmark、引用量和社区采用衡量;真实工作流没有这样的一键答案。模型是否理解目标、会不会在失败后调整、交付物能否被用户信任,都需要在一次次实际任务里检验。其公开账号在介绍豆包Agent时也表达过相近的看法:相比只汇报benchmark,实际使用才是更有意义的评测。
对Agent来说,真正重要的不只是完成一次漂亮演示,而是能在复杂的工作流程里交出用户敢直接使用的结果。
References
[1] TheInsight Asia, *ByteDance reshuffles AI team as model race intensifies*, https://theinsight.asia/bytedance-revamps-seed-team-structure-as-it-prepares-for-larger-ai-models/
[2] TechNode, *ByteDance reorganizes Seed foundation-model team amid reported 5 trillion-parameter model plans*, https://technode.com/2026/08/20/bytedance-reorganizes-seed-foundation-model-team-amid-reported-5-trillion-parameter-model-plans/
[3] Yujia Qin et al., *ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs*, https://arxiv.org/abs/2307.16789
[4] Yujia Qin et al., *UI-TARS: Pioneering Automated GUI Interaction with Native Agents*, https://arxiv.org/abs/2501.12326
[5] Yujia Qin et al., *WebCPM: Interactive Web Search for Chinese Long-form Question Answering*, https://aclanthology.org/2023.acl-long.499/
[6] Yujia Qin, *Personal Homepage*, https://yujia-qin.github.io/
[7] ICLR 2024, *ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs*, https://proceedings.iclr.cc/paper_files/paper/2024/file/28e50ee5b72e90b50e7196fde8ea260e-Paper-Conference.pdf
[8] DataFun, *工具学习:大模型走向通用人工智能的重要一步*, https://hub.baai.ac.cn/view/33819
[9] TsingYoga public-account mirror, https://twstalker.com/TsingYoga
[10] MiraclePlus Gallery, *XAgent*, https://mplus-gallery.nimbus-nimo.com/project/2024S-021
[11] AIbase, *字节 Seed 团队架构调整相关报道*, https://news.aibase.com/news/30487
[12] ByteDance Seed, *Seed2.1 Officially Released: Advancing AI Productivity*, https://seed.bytedance.com/en/blog/seed2-1-officially-released-advancing-ai-productivity
[13] PaperWeekly, *自然语言解释如何帮助数据增强:清华大学秦禹嘉等人提出基于神经执行树的解释学习方法*, https://www.sohu.com/a/386446595_500659
[14] 腾讯云开发者社区, *犀牛鸟精英计划获奖信息*, https://developer.cloud.tencent.com/article/2052107?from=15425&frompage=seopage
[15] 清华计算机系 1984 级创新未来奖学金相关报道, https://m.tech.china.com/redian/2023/1218/122023_1457217.html
本文由作者@Z Finance,授权发布于平台,未经许可禁止转载。