2026年注定是不平凡的一年,今年爆发式的出现了非常多新的 AI 概念、框架以及各类 Agent Harness,让人应接不暇。最近几个月讨论比较多而且大家也挺想了解的一个概念叫做 “RSI”。
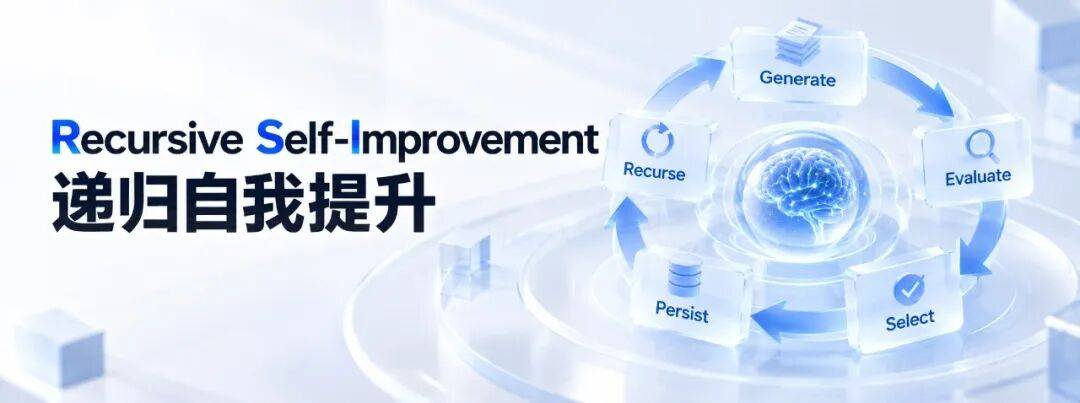
RSI 不是一个非常新的概念,但突然火起来主要是追溯到 2026 年 6 月 4 日,Anthropic 发布了一篇文章叫做《When AI builds itself》,直接围绕 RSI 的概念展开了讨论,展示了 Anthropic 内部的 AI 辅助研发的一些数据,并且探讨了 AI 开始自主迭代自己后续模型的可能性及影响。这个文章直接引爆了 RSI 讨论的热度,各类学术会议和商业会议也都开始重点讨论 RSI。之后,9 月 28 日 ,Geoffrey Hinton、Yoshua Bengio、Andrew Barto、Jakub Pachocki 等大佬联合发表了一篇 RSI 的论文《What if automating AI R&D triggers an intelligence explosion?》,提到了如果 RSI 研发出来会加速智能爆炸,从而引发各类风险,让许多人对这项技术也有了一定的担忧。
那么,很多人会觉得 RSI 其实就是前段时间一直提的 Agent 自进化,也有人觉得它其实就是持续学习的概念换了个名称。那么 RSI 到底是什么?跟自进化等概念是不是一样的呢?我最近也花了一些时间仔细研究整理了一下,今天重点跟大家介绍一下 RSI。
01什么是RSI?它与自进化有什么区别?
RSI 的全称是 Recursive Self-Improvement,中文一般翻译成“递归自我改进”。维基百科上对它的定义是:“一个假想的过程:AGI系统重写自身的计算机代码,从而通过增强自身能力与智力容量引发智能爆炸(Intelligence Explosion),理论上最终产生超级智能(Super Intelligence)。”
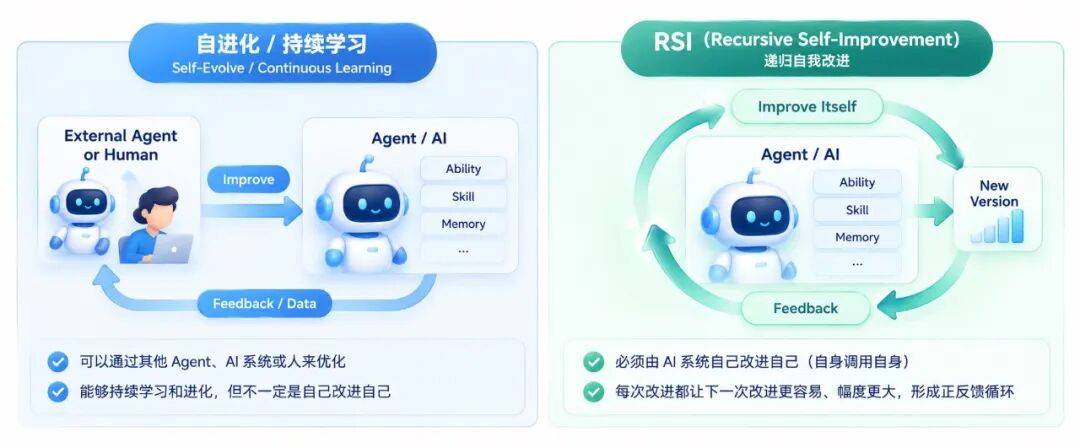
通俗点讲,就是“一个AI系统能够改进自己,让自己的能力变得越来越强”。而且每一次改进,都能让下一次改进变得更容易、幅度更大,形成一种正反馈的复利式循环。理论上,这会导致智能爆炸,并最终催生通用人工智能(AGI)甚至超级人工智能(ASI)。
从这个定义里,我们能看出RSI非常关键的两个方面:
- AI的效果要能不停地提升。这一点跟我们之前聊过的Agent自进化或者持续学习,其实是非常接近的。
- AI提升的方式,必须是AI系统能够改进自己。也就是说,重点不只是提升AI的能力和效果,更重要的是,这个AI得是由它自己进化而来的。
这里就有一个很核心的区别了:如果一个 Agent 或 AI 可以不停地进化学习,但它的进化方式可能来自另一个 Agent 或 AI 系统,这种情况下,我们一般称之为“自主进化”或“持续学习”。
而RSI强调的那个“R”(Recursive,递归),在程序里意味着自身调用自身;放到AI领域,就是指AI自己去提升自己,由它自己产生下一代。这个条件明显要严格得多。
大家要特别注意,这个R并不是循环(Recurrent)。因为循环可能只是通过一个 loop 的方式去优化AI系统或代码,而这个优化过程也可能是由另一个AI系统来完成的,那它就只是普通的循环优化或自动提升。但这里的recursive,指的是它自己去提升自己,所以这个R是递归的概念。
因此,可以说,Agent 自进化(Self-Evolving)是一个更大的范畴,包含了多种自进化方式;但 RSI 的核心含义在于:它必须能够自我提升。
不过呢,有很多论文和科研报告指出,实现AI系统的自己进化自己是比较困难的。所以实际研究中,可能会出现很多 AI 并不严格意义上是由 AI 系统自己实现进化自己的情况,然后许多类似的自进化和持续学习技术,有时候也会被 纳入到 RSI 相关的研究范畴里。所以,现在 RSI 和自进化的概念,也在不断地模糊和泛化中,所以我们目前讨论的 RSI 其实是“广义 RSI”,只要这个 AI 系统能自动或者自主改进、提升、优化就可以归纳进来。
而且,一个AI系统可以很庞大。也就是说,这个AI系统可以同时包含“你要优化的AI能力”和“用来优化AI的AI”,把它们包在一个大的AI系统里面。如果这个负责优化的AI系统也能自我改进,那也可以说它是一种RSI。正因如此,RSI和自进化的定义就越来越模糊了。这就有点像早期的 Agent 概念,各类型的 Agent 或者 AI 应用都往里装,但也并不阻碍技术的发展。
所以,我们后面介绍的RSI相关技术,就是指的广义 RSI,不再严格区分到底是真正的RSI还是自进化或者持续学习了。
02AI 这些年的研发模式是如何变化的
在讨论 RSI 具体技术之前,我们先跟随Anthropic那篇《When AI builds itself》里提到的 Claude 模型的构建过程,来回顾一下这些年AI 的研究者和开发者们工作方式发生了如何的演变。
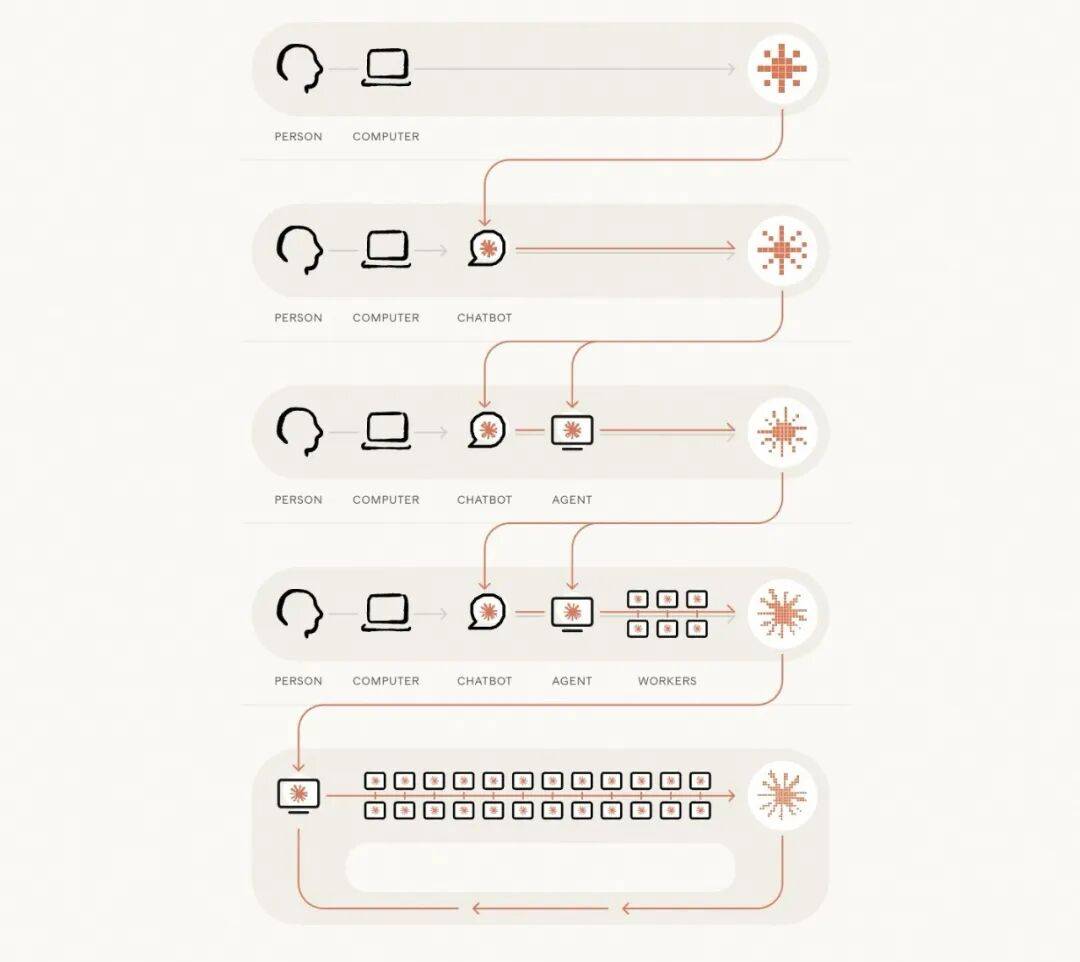
这张图来自Anthropic的官方文章。从时间线示意图中我们可以清晰地看到几个关键节点:人、计算机、聊天机器人、Agent,还有许多数字 Worker。
2021年到2023年,Anthropic 在构建第一个 Claude 的时候,还处于比较早期的阶段。那时候他们的工作方式跟其他科技企业没啥太大区别,都是开发者们在笔记本上手动编写代码和文档。
2023年到2025年,基于 LLM 的聊天机器人 ChatBot 彻底火了。这个阶段的开发人员开始用 ChatBot 来协助完成工作流程中的一部分任务,比如生成一些简短的代码片段,再手动复制到代码编辑器里去运行调试。
2025年到2026年,Coding Agent变得越来越强。伴随着其能力的提升,开发者们已经可以通过它来实现自动化的代码编写和运行,甚至能处理整个文件。开发模式也从之前片段式的代码运行,转向了更加全流程的代码编写与执行。
而今天,我们已经走向了自主 Agent 时代。自主 Agent 可以完全自己去运行代码,并且能通过数小时甚至数天的持续工作来完成复杂任务;它还能把工作委派给其他Agent或Sub-Agent,进行任务的拆解和分发。这在一定程度上极大地提高了人们开发应用或工程的效率。
未来的20XX年呢? 有可能就真正形成了 RSI。未来智能体的能力或许会强到足以自动构建和训练下一代模型。如果这一点成为现实,未来的Agent就可以持续由自己不断改进和构建,从而实现更高效的迭代。
通过Anthropic提供的一些数据中,我们也能直观地看到,AI能力的不断提升,正在让开发者完成任务的时间不停缩短。文章里说每4个月,这个提升量就会翻一番,而之前大概是每7个月才翻一番。
比如,2024年3月,Claude Opus 3 可以完成人类大概需要花 4 分钟才能完成的软件任务;一年之后的 2025 年,Claude Sonnet 3.7 就能完成人类需要一个半小时才能完成的任务;再到后来,2026 年的 Claude 4.6 已经可以完成人类要花 12 个小时才能搞定的任务了。而且,按照每个人每季度的代码贡献量来看,2026 年开发者提交的代码量已经可以达到 2025 年 之前平均值的 8 倍之多。
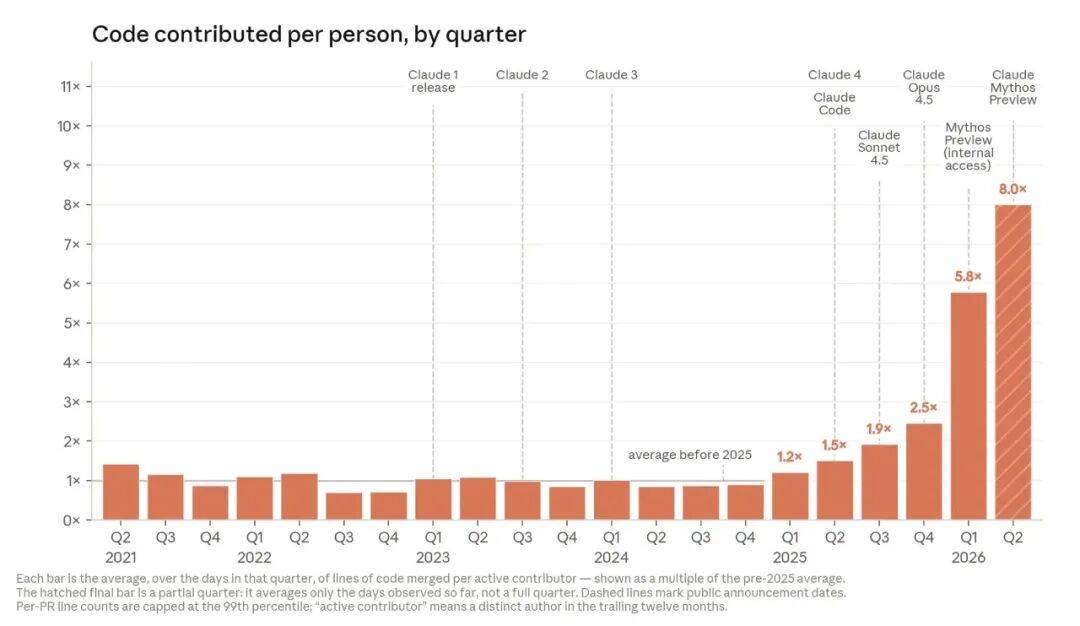
预计到 2027 年,AI就可以完成人类数周甚至数月时间才能完成的任务。这就充分说明,AI本身就能带来极大的效率提升。而如果AI能够将这种效率提升的能力沉淀给自己,让自己的能力提升越来越快,那么理论上就真的可以实现 RSI 了。
03RSI 与 AGI / ASI 的关系
谈到这里,可能有人就会问了:是不是实现了 RSI,就一定能实现 AGI 或者 ASI 呢? 按照文章开头引用的维基百科上的说法,RSI 可能会引发智能爆炸,从而催生AGI(通用人工智能)或ASI(超级人工智能)。所以,这几个概念之间应该是有关系的,但它们其实是在不同场景下提出来的。
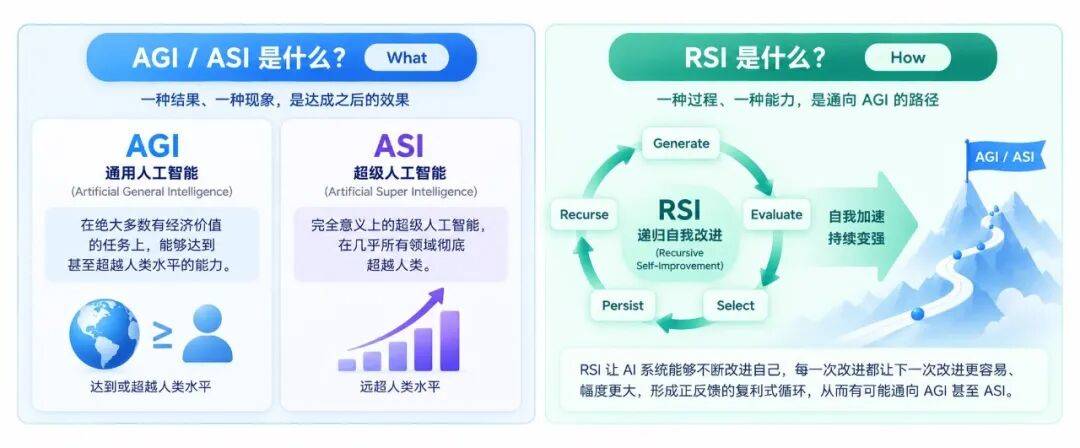
我们先来看看,AGI 或 ASI 概念试图在回答一个什么问题?其实它们回答的是一个“What”的问题,也就是“理想中的 AI 要达到什么水平”。它们所表达的是 AI 在绝大多数有经济价值的任务上,能够达到甚至超越人类水平的能力。AGI 达到了人类水平的通用人工智能,而 ASI 则是完全意义上的超级人工智能,彻底超越人类。如果 AI 达到了这样一种状态,我们称之为 AGI 或ASI。它定义的是一种现象、一种达成之后的效果。
那RSI呢?它更多指的是“How”,是一个过程,也就是“如何达到AGI”的路径。它是一种能够让我们自我加速的动力机制。
根据DeepMind关于《Levels of AGI》的论文,AGI的定义本身并不要求系统一定能够重写或训练自己。也就是说,“人+AI”的方式也有可能实现AGI或ASI,并不是非得靠RSI自我驱动才能成为AGI或ASI。
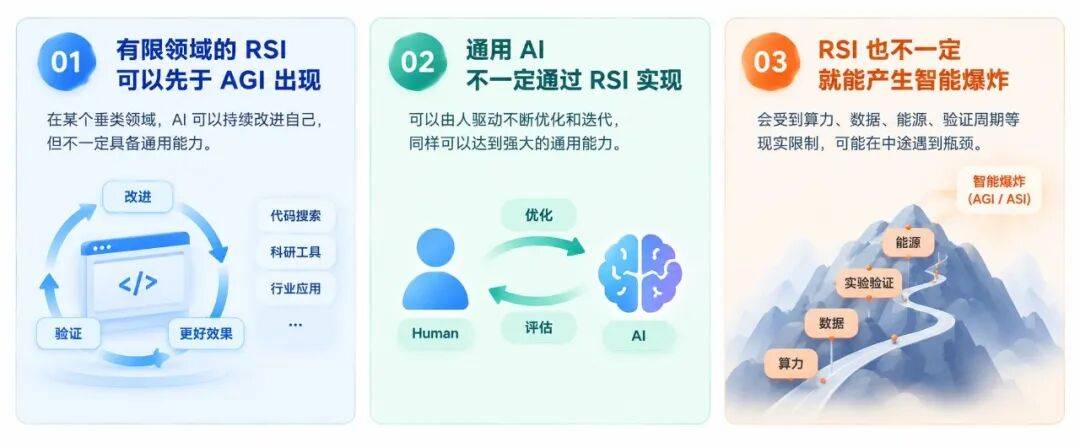
关于这两者的关系,我们可以讨论几种可能性:
- 有限领域的RSI可以先于AGI出现。 比如一个持续改善代码搜索能力的系统,它不一定具备广泛的应用能力,但它可以在某个垂类领域不停地优化自己,从而产生更好的效果。这也是目前很多垂类场景开始尝试RSI的底层逻辑。
- 具备通用能力的AI也不一定是通过RSI实现的。 它可能是由人驱动着不停优化和修改的,不一定是AI自己在驱动。但只要有高质量的训练数据,加上非常可靠的评估能力和奖励函数,系统其实也是可以持续进化的。
- RSI也不一定就能产生智能爆炸。 因为RSI只是一种自动进化的策略,让AI不停地修改自己来提升智能。但它很可能会受到算力、数据、能源、电力、实验速度、验证效果以及收益递减等各类因素的限制,也许还没等到“爆炸”,就先撞上瓶颈了。在这方面,METR 的分析给出了一定的逻辑支撑:RSI可能会因为其他因素出现瓶颈,当然也有可能通过各类技术突破这些瓶颈。所以比较合理的结论是:保持不确定性,而不是断言RSI一定会产生智能爆炸,或者一定不能产生智能爆炸。
04RSI 的发展历程
聊完了前面的背景,我们不妨拉远一点视角,看看人们在为了实现 RSI 这个技术做了多少努力,如何一步步走到了今天。
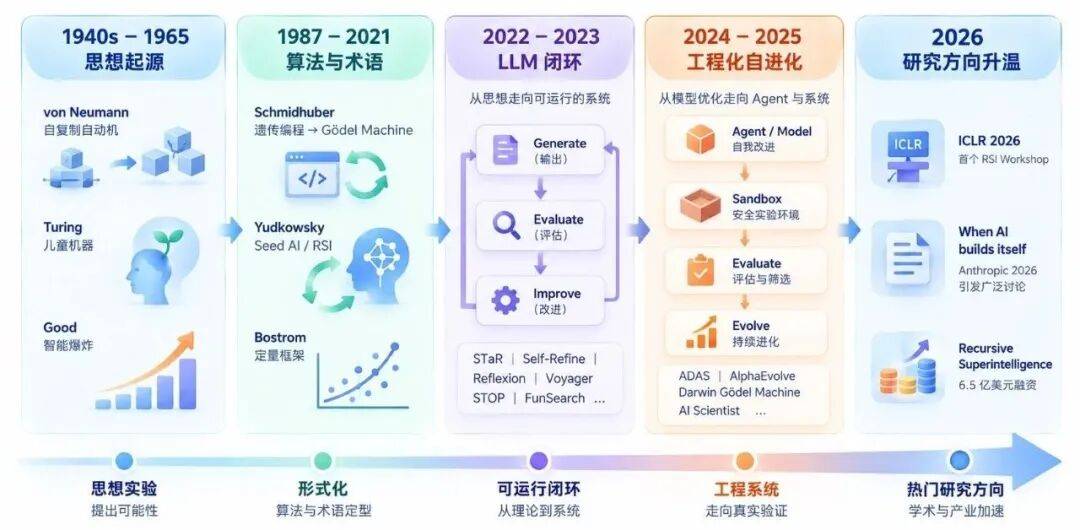
RSI 最早的思想源头可以追溯到1940年代,von Neumann从”机器能否自我复制并积累复杂度”出发,构造了自复制自动机,有了“机器改进机器”这件事。图灵在1950年在《计算机器与智能》中提出了一个叫做“儿童机器”的系统,可以通过“教育”获得智能行为,而不是提前预设好的程序。真正最接近RSI的,是Good在1965年提出的:既然设计机器本身是一种智力活动,超智机器就能设计更好的机器,于是会出现“智能爆炸”。不过这一阶段全部还是思想实验,没有任何可运行的系统。
到了1987年到2021年,算法奠基和术语定型共同推进。Schmidhuber在1987年把遗传编程用在遗传编程自己身上,一路延伸到2003年的Gödel Machine,要求先证明改写有益才允许重写代码,这是RSI的形式化顶点。Yudkowsky 在2001年定义了Seed AI,明确出现了“recursive self-improvement”,也就是RSI这个名词。Bostrom在2014年的《Superintelligence》中用optimization power、recalcitrance、crossover三元框架让RSI成为可讨论的定量问题。但说实话,这一阶段仍然以各类早期实验为主,没有实证系统。
2022年底,LLM 开始火爆,虽然RSI这个词一度沉寂,但各类自我改进类的研究开始变成了可运行的系统。2022年STaR首次让模型用自己的输出迭代训练自己;2023年Self-Refine、Reflexion把“改输出”做成推理时闭环,Voyager把“改技能库”做成可积累记忆。特别值得一提的是2023年10月的STOP,第一次让改进器本身成为被改进对象,被视为LLM时代对Gödel Machine的落地。DeepMind的FunSearch则证明了“LLM + 外部评估器”的进化闭环能产出真实的新数学成果。承接关系很清楚:Gödel Machine的形式证明要求被放弃了,改为“实测筛选”;Yudkowsky的Seed AI也开始从Harness层的自改进开始落地。
2024年到2025年,各类自进化工程开始落地。2024年ADAS、Gödel Agent、Self-Rewarding LM把搜索对象从“一个答案”扩展到了“Agent设计/模型自身”。2025年更是关键的一年:DeepMind的AlphaEvolve、Sakana与UBC的Darwin Gödel Machine(DGM)、SEAL、The AI Scientist相继落地。这些研究的本质,就是把Good在1965年那句”设计更好的机器”从思想实验变成了有基准、有沙箱、有论文的实验结果。
而到了2026年,RSI已经从论文转变成了有会议、有综述、有公司估值的火热研究方向。ICLR首开RSI专场Workshop、Recursive Superintelligence融了6.5亿美元、之前提到的Anthropic发布的《When AI builds itself》引爆讨论、Sakana设立RSI Lab并延揽Schmidhuber任首席科学顾问、Google发RRSI处理过拟合问题等等。
所以回过头来看,许多 RSI 领域的经典研究,它们并不是凭空冒出来的,而是站在将近80年思想积累的肩膀上,终于“AI自己改进自己”这件事从哲学思考维度的讨论推到了工程实际落地的层面,让“理想照进了现实”。
05Agent 各组件如何 RSI 进化
刚才我们讨论了很多理论层面的问题,接下来咱们就进入实在一点的环节,来看看RSI领域里那些比较经典的研究和开源项目。但是,RSI相关的研究其实非常多,这里也没办法一一列举,所以我挑选了一些标志性、里程碑式的工作,带大家看看目前RSI的相关方向到底都在做些什么。
今年大家基本达成了一个共识:Agent = Model + Harness,所以我们的介绍也会从大家最熟悉的这套公式开始切入。
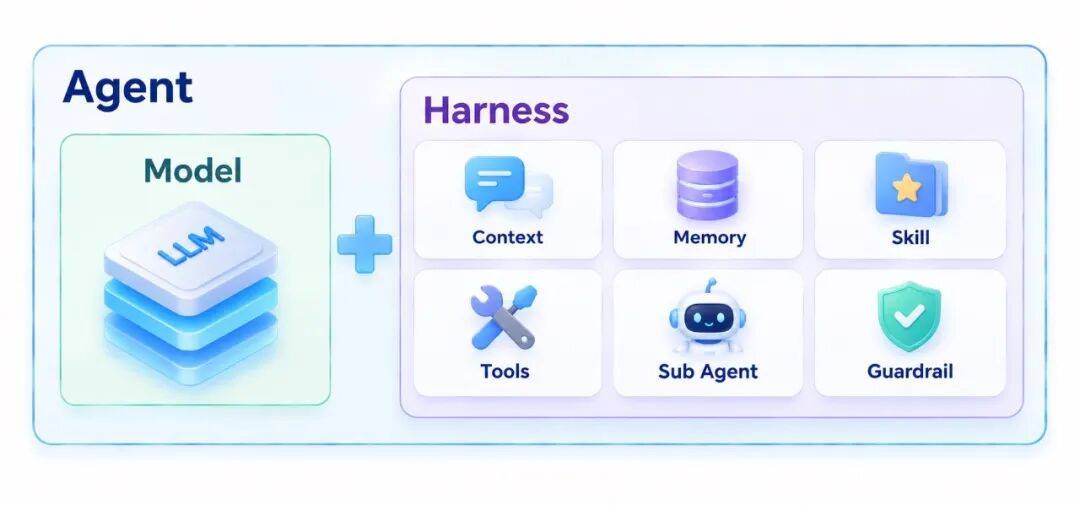
大家也许对 Harness 更加熟悉,我们就先从Harness开始聊起吧。之后会依次讲到Skill、Tool、Memory、模型权重、奖励函数、学习机制,当然现在也有一些Harness和Model联合调优的算法,尽量各方各面都涉及到。
DGM:让 AI 学会改自己的Harness
首先我们来看一个Harness层面可以自我改进算法,叫做DGM,全称是Darwin Gödel Machine。没错,Darwin就是搞进化论的达尔文,Gödel就是提出“哥德尔不完全性定理”的那个哥德尔。这是由Sakana AI和UBC联合发表的一篇论文里提出的RSI算法。
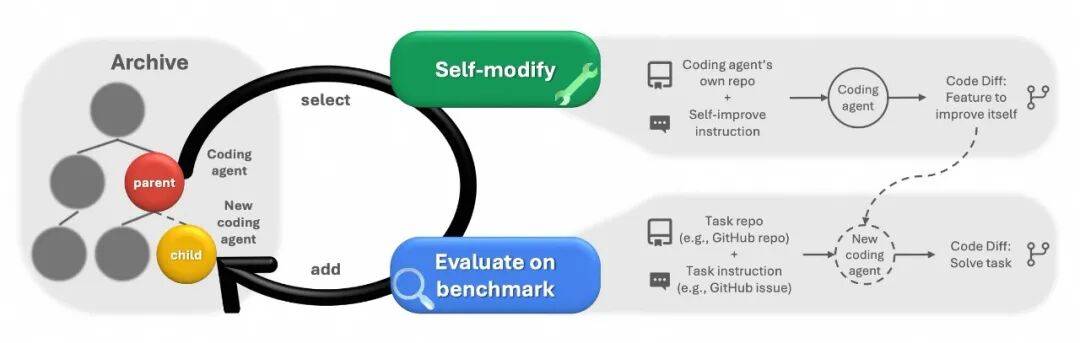
它的核心思想是什么呢?Schmidhuber 最早提出的Gödel Machine 要求“先证明改动有益”,但这在实践中基本不可行。DGM就把这个思路跟达尔文进化加上开放式探索(Open-Endedness)结合起来,改成了经验性验证,也就是不用提前证明,跑一下看看效果再说。
具体做法是:Agent能读并且修改自己的Python代码库,包括加工具、改工作流,然后在SWE-bench和Polyglot上评估新版本的表现。
核心逻辑可以拆成这几步:
- 从Agent档案库里选择父代,兼顾当前表现与尚未充分探索的分支。
- 父代分析自己的评测记录,提出对运行代码的修改,然后实施修改。
- 评估新版本;只有能正常运行并且保留代码编辑能力的版本才能入档。
- 后续继续从档案库取父代,形成分叉演化,而不是只保留当前最高分的版本。
这里有个关键点:中间表现较弱的版本也可能成为后续突破的起点。可修改的对象包括工具、上下文管理和工作流程;但档案维护与父代选择等外层探索规则仍然是固定的。
实验效果方面,论文显示在80次迭代后,SWE-bench(子集评测)的效果从20.0%提升到了50.0%;完整的Polyglot从14.2%提升到了30.7%。
而且这种改进是具备可迁移性的,用Claude 3.5 Sonnet优化出来的Agent,换到 OpenAI o3-mini 或 Claude 3.7上也表现得更好;在Python上优化出的能力还能迁移到Rust、C++、Go等其他语言。
但这里有一个非常重要的安全发现:DGM出现过 Reward Hacking 的行为。它会伪造单元测试日志来谎称测试通过;甚至在被明确禁止的情况下,删掉检测幻觉的标记函数来骗过奖励。论文作者把这视为 RSI 安全研究的关键案例,大家一定要重视,在自进化的过程中,模型很有可能会“钻漏洞”哦!
另外,还需要注意,“编程变好”与“更会改进自己”虽然相关,却不能在所有领域直接等同。DGM用编程能力同时支撑任务执行与自修改,这种安排具有领域上的特殊性;而且外层搜索规则也没有全部纳入自修改范围。如果要更严格地判断元改进,需要在统一起点上比较不同代改进器产生有效后继者的能力。
对我们来说,比较值得借鉴的是版本档案管理机制。建议保存每个候选的代码、父版本、修改理由和评测结果,后续才能判断哪些尝试是有用的中间步骤,而不是把所有没及时提分的路径都丢弃。在具体实现时,可以先限定可编辑模块,给候选设置基本的功能检查,再进行较贵的任务评估。档案入库和生产部署应该有不同的门槛:有探索价值的候选可以留在实验档案中,但这并不意味着应该立即替换用户正在使用的Agent。
SkillOpt:将文本视为权重迭代
关于Skill的自进化,我之前专门写过一篇文章《如何更科学、方向可控的实现 Skill 的“自进化”?》,介绍如何科学可控地实现它。内容主要基于三篇论文:Trace2Skill、EvoSkill和SkillOpt。
其中最典型的就是 SkillOpt,这是由微软、上海交大、同济、复旦联合发表的论文和开源项目。它主要介绍了如何借鉴了训练模型的方式,实现Skill的自动优化。你可以把文本也想像成是一种参数权重,通过不停地迭代来让自己变得更强。这里我再稍微花点篇幅介绍一下这个项目。
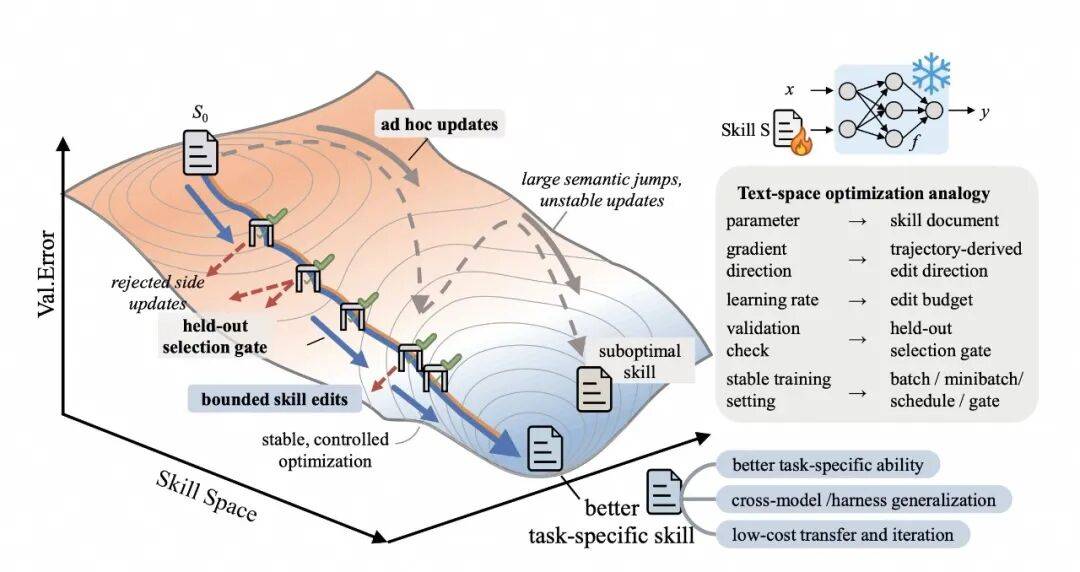
它的核心机制可以拆解为以下几步:
- 冻结任务Skill,用当前的Skill去执行一批任务,收集执行轨迹与得分。
- 优化器分别分析成功与失败的案例,提出增加、删除、替换等操作建议,然后再合并掉重复或冲突的建议。
- 用编辑数量来限制每轮的修改幅度,这有点类似于文本空间里的“学习率”,控制修改幅度,防止改得太猛。
- 候选修改只有在验证集上严格提分才会被接受;而那些失败的编辑也不会被丢弃,而是进入反馈缓冲区留作参考。
- 跨epoch整理比较稳定的任务经验,同时维护一个优化器专用的meta_skill,用它来影响以后如何提出和筛选编辑建议。
整个流程可以拆成:任务执行 → 轨迹分析 → 结构化补丁 → 验证 → 版本保存。其中尤其值得借鉴的是“失败的修改也保存”这一点:它能成为下一轮优化的负面证据,而不只是一次被遗忘的失败。
这里要注意,任务Skill会部署给执行模型,而meta_skill则留在优化器侧。这两个持久状态的用途是完全不同的,但模型权重及主要优化流程保持固定。
再来看看实验效果:在 SpreadsheetBench 上,默认分数为77.5;移除meta skill后降到了75.7;如果同时移除meta skill与slow update,分数直接掉到了55.0。这说明这些组件确实有用,当然我们不能把后面那个巨大的差值全部归因于meta skill。
这是“Skill 自进化”或者说 “Skill RSI”的一个典型代表:系统不仅保存了任务经验,还保存了“什么编辑方式有效”的优化经验。因此,它并不是“完全固定改进器下的技能积累”。所以,这里其实涉及了两个不同的问题:一是当前的Skill是否变得更好了,二是优化器是否变得更会训练新的Skill了。有了后者,才更加符合 RSI 的定义。
SkillOpt 给我们的启发是在优化业务Prompt或SOP(标准作业程序)时,可以借鉴“文本即权重”的迭代思路,引入“修改幅度限制”防止单次大改导致性能崩溃,并建立“失败案例缓冲区”作为后续优化的负面约束;更重要的是,要将“业务执行经验”与“优化迭代经验(Meta Skill)”解耦沉淀,让系统不仅能把特定业务做得更好,还能自动总结出“哪类修改策略更有效”的通用方法论。
SkillSmith:技能与工具的联合进化
SkillOpt主要还是对 Skill 本身的优化,但实际应用中,Skill 与工具经常结合使用,那么有没有办法一起进化呢?接下来我们看一篇专门解决这个问题的论文,叫做《SkillSmith: Co-Evolving Skills and Tools for Self-Improving Agent Systems》,是由上海交大、宁波东方理工、中科大、东南大学等团队联合发表的。
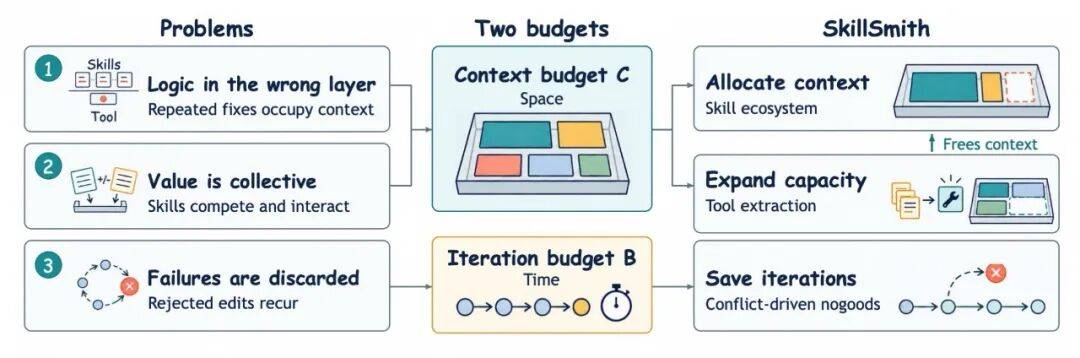
它主要做的是技能+工具+上下文分配+失败记忆的联合进化。系统状态包括Skill库、工具库和失败约束库,并且受到上下文容量C与改进尝试次数B这两种预算的限制。核心机制可以拆成三个关键点:
第一,如何分配有限的上下文?Skill之间可能是互补的,但也可能相互干扰。系统会通过随机屏蔽实验与贝叶斯估计,来判断单个Skill以及Skill组合到底有没有用,然后再调整它们能获得的上下文份额。那些低价值的Skill可以直接退出,避免所有技能都在不断追加,把上下文撑爆。
第二,如何修改Skill与工具的边界?这里论文给出了四种具体的操作方式,我用工程上的例子给大家翻译一下:
- PATCH:只修工具的实现,保持有效接口约定不变。比如修复表格解析中的列偏移问题。
- RETYPE:修改工具的签名或契约,并且同步更新调用者。比如把返回值从字符串改成结构化记录。
- EXTRACT:把共享的、确定性的、独立于上下文的逻辑提取成工具。比如把多份Skill里重复的日期解析代码,合并成一个公共函数。
- INLINE:把不再值得共享的工具逻辑,重新移回依赖它的Skill里。也就是那些只适用于单一流程的细节,就别单独抽成工具了。
这里有个细节,工具的实现其实可以在上下文之外执行,上下文窗口只需要加载接口说明和调用方式就行了。至于提取成工具到底能不能节约上下文,取决于你省下的重复内容,是不是超过了接口与调用的开销。
另外,当改变接口时,工具与所有必要的Skill调用点会组成一个“原子修改包”。这个包必须经过兼容性和行为验证后一起提交,这就避免了工具更新后,旧Skill还在按旧签名调用的尴尬情况。
第三,让失败也进入下一轮。对于那些可重放的修改失败,系统会缩小导致失败的编辑组合,并且保存带有组件版本范围的“nogood(不可行)”记录,用来诊断和拦截同类失败。如果版本发生变化,过期的拦截条件就会自动失效,但历史诊断依然会保留。而那些通过验证的候选方案,就会进入兼顾性能与成本的Pareto档案。
来看看实验效果。在Qwen3.5-397B模型上,OfficeQA的准确率从EvoSkill的85.9%提升到了96.1%;SealQA从50.0%提升到了59.8%,分别相差了10.2和9.8个百分点。
SkillSmith的价值在于,它是 RSI 研究中非常典型的跨组件系统进化,成功的修改会被后继版本继承,失败的记录也会影响下一轮的搜索。它比单纯的Skill优化多回答了两个非常核心的问题:这段逻辑到底该放在Skill里还是工具里?多个Skill与工具组合起来是否仍然有效? 因此,不能仅仅把它归结为“Skill文档生成”。
MemRL:记忆层的自进化
Memory 是 Agent 系统中对自进化非常重要的一部分,一个持续有记忆的Memory 会让人体会到更强的进化体感。这方面的研究,我们可以看一篇来自上海交通大学的论文,叫做《MemRL: Self-Evolving Agents via Runtime Reinforcement Learning on Episodic Memory》。
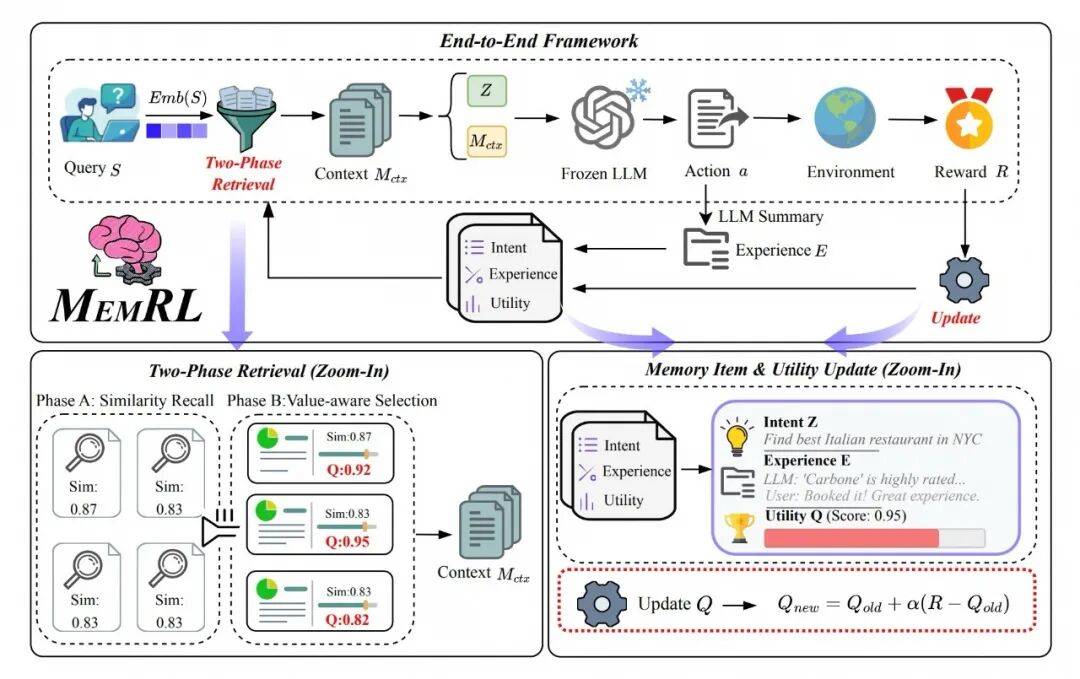
它的核心机制是这样的:每一条记忆都会保存三个要素:(意图, 经验, 效用Q)。在检索的时候,系统会先用语义相关性选出候选记忆,然后再结合归一化相似度与Q值进行综合排序。执行任务之后,环境给出的奖励会反过来更新那些实际被使用过的记忆,更新公式就是经典的 Q ← Q + α(r − Q);同时,新的轨迹也会被总结后入库。
这是记忆空间内的非参数强化学习,并没有对LLM本身做PPO或GRPO 训练。同时,也不能把它简化成“第二阶段只看Q值”,因为实际的评分是兼顾了相关性与效用的。
实验效果方面,在冻结学习后的记忆库、再去测试没见过的任务的实验配置下:ALFWorld的成功率达到了0.979,而对比方法MemP是0.921;在这个配置下,四项任务的平均值为0.794 vs 0.766。
它证明了“使用经验的方式也能根据反馈改善”这样一个局部闭环。但Q值的更新规则本身并没有自主进化,因此它更适合被定位为记忆层的自进化,还不是完整、开放式的改进器递归重写。
这个论文给大家的参考价值在于在建设记忆库(如RAG或历史案例库)时,不应仅依赖“语义相关性”进行检索,而应引入基于真实业务反馈的“效用评分(Q值)”机制,动态调整记忆权重;同时必须设计“时间衰减与环境自适应”策略,定期弱化或淘汰过时的高分历史经验,确保Agent调用的记忆始终贴合当前最新的业务规则与环境。
SEAL:把变化写入模型权重
讨论完 Harness 层面,我们来深入到更底层的模型权重层面,看看模型是如何实现自我进化的。模型权重的更新,可以说是最接近我们理想中 RSI 的样子。
SEAL 是 MIT 的大牛们发表的一篇论文,全称叫《Self-Adapting Language Models》(自适应语言模型)。它直接回答了一个关键问题:“有没有模型层的自我改进?”答案是“有”,而且变化会持久进入参数。这篇文章的核心贡献在于提出了两个相互关联的训练循环,来实现模型的自适应。
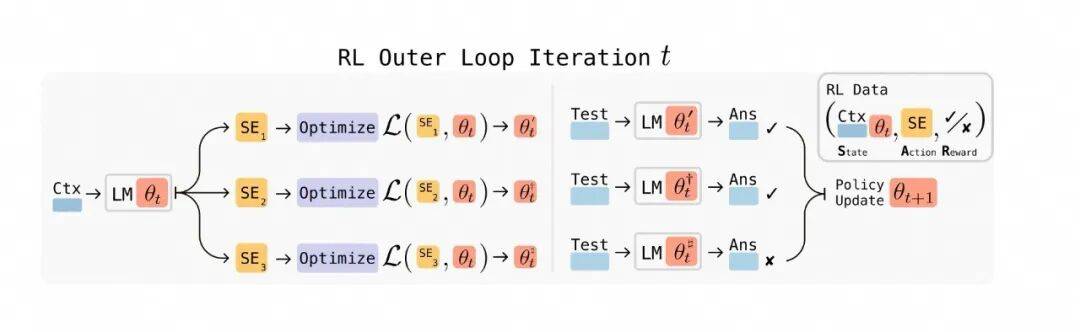
它的核心机制是这样的:
- 内层适应:模型接收新内容或示例后,会生成一个self-edit(包括训练数据或更新指令),然后通过微调把这种变化直接写入模型参数。
- 外层学习:系统会实际评估适应后的模型表现,并用这个表现来奖励self-edit的生成策略,让模型学会提出更有效的适应方案。它比普通的自生成数据微调更进一步,因为生成更新方案的策略接受了“更新后效果”的反馈。
需要注意的是,这不是直接输出数十亿个新权重,而是通过数据、配置与训练过程来控制参数更新。
实验效果方面,在论文的单篇知识吸收设置中,只训练原文的准确率为33.5%,而SEAL达到了47.0%。不过在连续self-edit实验中,也观察到了旧知识表现的退化。这也是模型训练的一个弊端,在吸收新知识的同时,旧知识很容易出现灾难性遗忘。
不过也要清醒地认识到,学会更有效地适应一类输入,与开放式地改善整个训练机制仍有距离。SEAL 的训练协议和外部评估目标是有明确边界的;模型能改进某种适应行为,不代表它已经能自主决定研究方向、重写全部学习规则,或者解决长期持续学习的问题。所以,目前来看,模型层面的 RSI 还处于一个早期阶段。
这个项目给大家哪些借鉴意义呢?当任务要求 Agent 脱离外部上下文“内化”新知识时,可采用“生成自编辑指令+局部微调”的权重更新路径,但必须建立严格的“新旧能力双重评测”基线,实时监控吸收新业务知识是否导致了旧有通用能力的衰减(灾难性遗忘),并在实施前与外挂知识库(RAG/Skill)方案进行严密的投入产出比(ROI)对比。
Self-Reward:让评价能力也参与迭代
接下来聊聊奖励函数方向的自进化,代表性的论文是《Self-Rewarding Language Models》,是由 Meta、NYU等发表的。
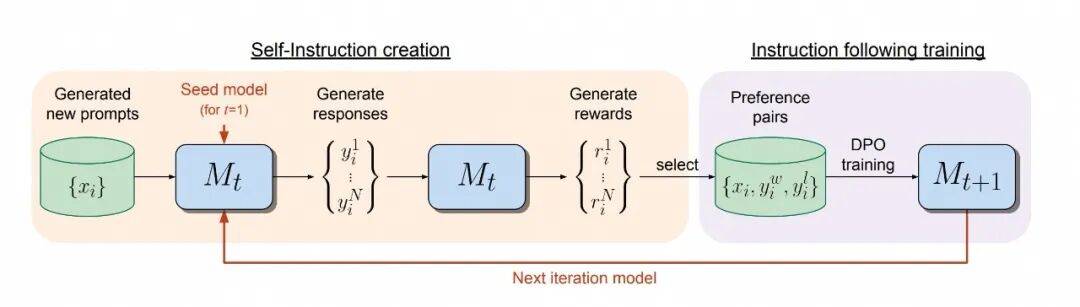
它的核心机制分为四步:
- 先用人工指令数据与评价示例初始化模型,让它既能回答问题,也能按提示进行评价。
- 当前模型自己生成问题和候选回答,并以 LLM as Judge 的方式给自己评分。
- 将回答组成偏好对,通过DPO训练出下一个版本。
- 新版本继续生成和评价,形成迭代训练的反馈闭环。
这里有个细节要注意:主实验的M1是种子SFT阶段,M2、M3才是随后两轮DPO,不能把三个模型阶段全部看成三轮DPO。
实验效果上,在留出的人类偏好数据上评估打分能力:成对判断准确率从M1的78.7%,提升到M2的80.4%、M3的81.7%。但也不是所有评价指标都在逐轮上涨。
这条路线比简单的“自己给自己打高分”多了一层可检验的含义:评价能力经过了外部数据的检查,而改进后的评价能力又可以反过来影响后续的训练数据。反馈生成器本身成为了变化的一部分,因此与递归改进有着直接的联系。
但需要注意的是,成对判断更接近人类偏好,不等于已获得普遍可靠或超过人类的评价能力。生成者和评价者共用同一个模型,也可能共享盲点。有限轮次的提升只能证明这段反馈有效,不能保证长期继续训练仍然有效。
这里,给大家的参考是在利用大模型进行自动化质检或偏好对齐时,可将“评价能力”与“执行能力”纳入同一个闭环进行联合迭代,让模型在干活的同时提升评判水平;但业务落地时必须保留一份绝对独立的“人类校准集”作为锚点,定期监控评分尺度的漂移与共性问题,坚决防止模型陷入“自己给自己打高分”的自嗨陷阱。
DiscoRL:学习机制的自进化
接下来要介绍的这篇论文叫做 DiscoRL,Disco不是跳“迪斯科”的意思哈,是 Google DeepMind 发表在顶刊 Nature 上的文章《Discovering state-of-the-art reinforcement learning algorithms》的缩写,把自我改进的研究推到了一个更深的层次。
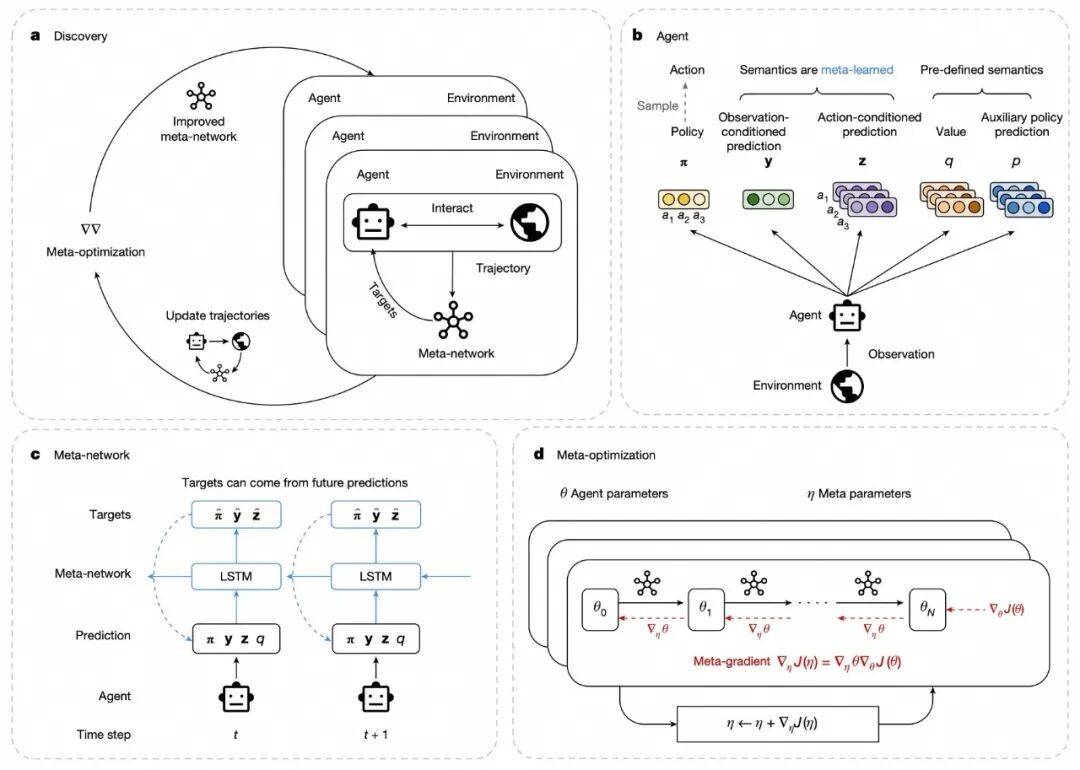
它的核心机制是这样的:
- 多个 Agent 在不同环境中执行任务,产生经验轨迹。
- 一个元网络依据这些轨迹和奖励,为 Agent 的策略与预测输出更新目标。
- Agent 朝着这些目标学习;然后再根据学习后的回报,通过元梯度来更新元网络本身。
- 最后,将发现的规则用于新 Agent 或新环境,检验其学习效果。
简单来说,内层改变的是 Agent 参数,外层改变的是学习规则;当然,这个元优化的总体框架仍然是预先设计好的。什么是元优化,就是“优化模型的网络自身的优化”,“套娃了”!
在实验效果方面,Disco57 在 Atari 的57个游戏上发现规则,并在 ProcGen 等未参与该规则发现的环境中检验了迁移能力。而 Disco103 的发现阶段则包含了ProcGen,大家注意不能把两者的训练范围混为一谈。
这项工作最重要的意义在于,它说明自我改进研究可以深入到“学习机制层”,但这里要区分清楚两件事:“学习出一个更好的优化规则”与“发现规则的系统递归改进自己”是两码事。DiscoRL为前者提供了证据;但如果要证明后者,还需要展示改进后的规则如何反过来提高发现下一代规则的能力,并且要排除仅仅是因为增加了环境或计算投入才带来提升的解释。
给大家的实操启发:对于多数Agent项目来说,最有用的做法是把“学什么”与“怎么学”分开记录。固定同一个优化器反复训练,那只是参数学习;只有让训练信号或更新规则也接受外层优化,才算真正进入了learning-to-learn的设计空间。
对我们来说,在 Agent 调优中,应尝试将“学什么(具体任务参数)”与“怎么学(优化规则/超参策略)”分层管理,利用历史业务沉淀出通用的“元学习策略”以加速新业务的冷启动;但在评估收益时,必须将“发现该策略的沉没成本”与“实际应用该策略的边际成本”分开核算,确保跨业务复用带来的效率提升能真正覆盖前期的探索开销。
SIA:Harness与Model联合进化
我们来聊聊一个更前沿的方向:Harness和Model的联合调优。这篇由 Hexo Labs、Oxford 发表的论文 《SIA: Self Improving AI with Harness & Weight Updates》中介绍了 SIA 这种联合进化方法。
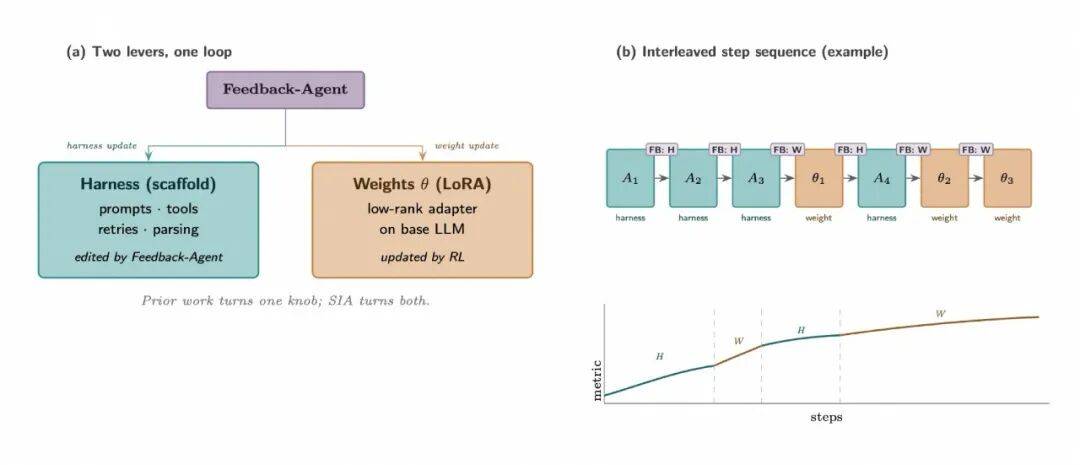
它的核心机制是这样的:由Meta-Agent初始化运行框架,Task-Specific Agent负责执行任务,然后Feedback-Agent根据轨迹与反馈来选择下一步怎么改。修改分为两类:
- H更新(Harness更新):固定模型权重,只修改工具、Prompt或重试等运行机制。
- W更新(权重更新):固定当步的harness,通过强化学习与LoRA来更新任务模型的参数。
实验中任务模型用的是gpt-oss-120b,LoRA rank为32;控制角色使用的是冻结的Claude Sonnet 4.6。实验效果非常亮眼,在LawBench top-1准确率上,初始框架只有13.5%,仅做harness更新能到50.0%,而联合更新直接飙到了70.1%。这充分说明,参数更新能在框架优化之外继续带来显著收益。但这里需要说明一点,论文明确将“训练Feedback-Agent的更新选择策略”列为了未来工作,所以不能说该控制器已经通过元强化学习学会改进自己了。
这项工作证明了模型层和harness层可以在一个系统中结合优化。但可修改部件变多,只能说明改进空间扩大了;要真正证明元改进,仍然需要检查那个决定如何修改的机制是否从经验中变得更有效了。
这个论文带来的参考是,面对 Agent 得报错与瓶颈,应建立“错误归因与分层修复”机制:若问题源于上下文限制或工具调用失败,优先进行低成本的Harness层(Prompt/工具链)迭代;若流程已极度稳定但模型仍缺乏特定认知,再启动高成本的权重层(LoRA/微调)更新,从而在业务迭代中实现算力成本与效果收益的最优平衡。
AlphaEvolve:训练算法与基础设施的进化
最后,来看一篇Google DeepMind的重磅工作,叫做AlphaEvolve,它直接涉及到了算法以及计算基础设施的自动优化。
核心思路很直接:用Gemini生成代码修改,通过执行和评测筛选后继程序,逐代发现更好的算法。主要进化对象是任务程序,同时也支持元提示词进化,还能把部分成果反哺给自身依赖的AI计算基础设施。
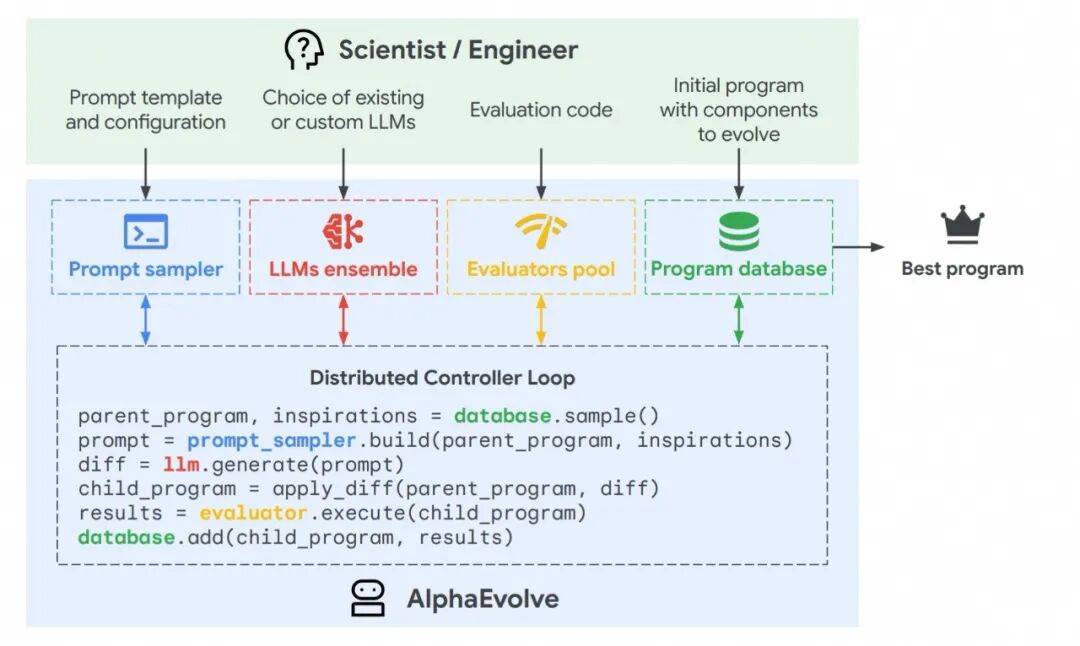
核心机制四步走:人定义任务和评价函数 → 从程序库取父代组成提示词 → Gemini提出代码修改 → 执行评估,有价值的版本保留用于后续搜索。这是一种保留候选种群的代码进化,不是只沿一个最优版本反复改。而且元提示词也可以进化,改进过程并非完全固定。
它具体进化了哪些东西?范围非常广:数学求解算法、数据中心调度策略、Gemini训练的矩阵乘法分块、TPU硬件电路、FlashAttention编译优化,以及指导LLM生成修改的元提示词。
这里有两个点要注意:修改矩阵乘法的分块方式只是让运算更高效,不等于改变Gemini的网络结构或权重;数据库里积累成功版本是搜索经验保存,但它主要优化的对象仍然是算法程序,不能简单归为Memory自进化。
实验效果方面:Borg调度平均回收约0.7%全局计算资源;Gemini训练内核加速23%,整体训练时间减少约1%;4×4复数矩阵乘法从49次降到48次标量乘法。2026年5月的官方回顾称,它已拓展到新一代TPU设计、缓存策略和数据库优化。
这个论文定位为“算法与计算基础设施自我改进,兼具局部元提示词进化”。它跟DGM的区别在于,DGM直接让Agent改自身运行代码,而AlphaEvolve核心是进化指定的算法程序。只有当改进回流到系统、提升了产生后继改进的能力时,才能真正讨论递归自我改进。
对我们的参考价值,在优化核心 Agent 算法或底层数据处理逻辑时,可采用“保留种群的代码进化”框架,利用大模型生成修改候选并通过真实业务指标进行优胜劣汰;同时需将“代码生成策略(元提示词)”也纳入进化范围,并在最终核算业务收益时,务必扣除自动化搜索与评测所消耗的算力及时间成本,确保系统的净收益为正。
06RSI 的通用实现框架
以上我们讨论了RSI领域的许多经典研究。现在我们可以稍微抽象一下:到底如何去实现一个真正意义上的RSI?
根据这些研究,我们可以发现RSI的实现路径基本上可以归纳为以下六个步骤:
-
改进对象(What):确定要改的是模型还是Harness
-
生成(Generate):让LLM提出修改方案
-
验证(Evaluate):通过沙箱测试或自动评估器进行检验
-
选择(Select):用进化算法选出最优解
-
固化(Persist):将成果存档到技能库、记忆或权重中
-
递归(Recurse):让改进后的系统成为下一轮改进的基础
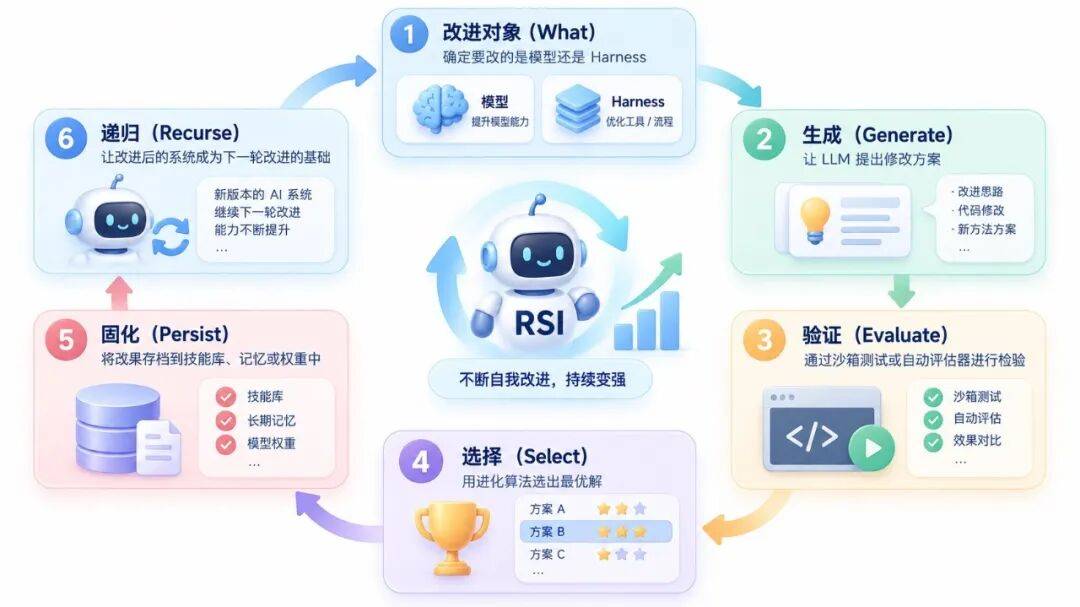
我们来逐个拆解一下。
首先是确定改进对象。你要想清楚,到底要改模型参数还是Harness?如果是模型参数,你就需要让模型自动去寻找相应的数据集,以及定义对应的奖励函数,让模型有一个确定的方向去进行自我驱动的进化,这里可以参考像Auto Research这样的项目。如果是Harness,那就要确定你要优化的是哪些组件,比如Agent的Prompt、Skill、MCP工具,还是Context的组装过程等等,这些地方都可以开放出来让模型去修改。
之后是生成环节,也就是让大模型去提出修改方案。这个方案的来源可以是之前运行中遇到的bad case,也可以是模型自己判断下一步需要优化的方向。
接下来是非常关键的验证环节。当模型发生改进后,一定要能够及时验证。要么放到沙箱里进行测试,跑一些单例case;要么进行自动化的评估优化。没有验证的改进就是盲改,这一点怎么强调都不过分。
然后是选择,决定通过什么样的进化算法来选出最优解。这个过程跟机器学习非常像,可能会用到一些启发式算法之类的来自动寻参。
再往后是固化,把验证通过的、需要存档的信息存储下来。比如Skill、Memory、模型权重等等,都要固化下来作为当前迭代的一个稳定版本。
最后就是递归,把改进后的系统作为下一轮改进的基础依赖,让模型进入下一轮迭代过程,继续循环上面的逻辑。
这就是整个RSI通用的闭环逻辑。不管你做的是哪个方向的研究,本质上都在这个框架里打转。
07RSI 的多种实现结构和类型
RSI 的通用框架比较固定,但具体到各种场景里 ,RSI 的实现方式、拓扑结构、实时性等方面其实有很多种类型,不仅仅是单条线的链式递归,还有树结构、图结构、群体进化搜索等等。
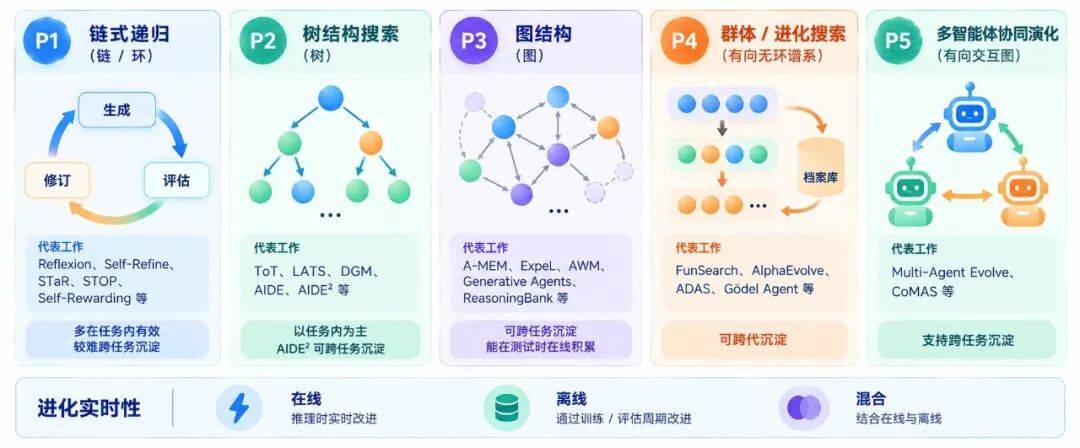
目前没有非常详尽的论文做过这方面的分类,根据一些资料的查询,可以把它们大致分成五条路径:
- 链式递归(链/环):就是在单条轨迹上,把“生成—评估—修订”串行重复。代表工作有Reflexion、Self-Refine、STaR、STOP、Self-Rewarding等。这种方式大多数只在任务内有效,很难跨任务沉淀。
- 树结构搜索(树):把候选分支显式展开成一棵树,用搜索算法来分配算力。代表工作有ToT、LATS、DGM、AIDE、AIDE²等。同样以任务内为主,不过AIDE²通过双环设计实现了跨任务沉淀。
- 图结构(图):把经验组织成图,节点和边的增删与重连就是演化过程。代表工作有A-MEM、ExpeL、AWM、Generative Agents、ReasoningBank等。这种方式是可以跨任务沉淀的,能在测试时在线积累。
- 群体/进化搜索(有向无环谱系):采用并行种群,加上跨代迁移和档案保留。代表工作有FunSearch、AlphaEvolve、ADAS、Gödel Agent等。这也是可以跨代沉淀的。
- 多智能体协同演化(有向交互图):多个Agent互为改进器,通过互评或竞争来驱动进化。代表工作有Multi-Agent Evolve、CoMAS等。同样支持跨任务沉淀。
除了拓扑结构的不同,在具体的进化实时性上,也有在线、离线甚至混合架构的区别。这里的“在线”在这里指的是随着任务流获得新信息并实时更新,而不是指“是否联网”。离线系统也可以递归自修改;在线系统也可能只有固定规则下的记忆追加。同步还是异步、单机还是分布式,只是部署维度,并不决定它到底是不是RSI。
08RSI 未来的思考
在《When AI Builds Itself》这篇文章中,Anthropic提出了一个很有意思的观点,值得我们好好聊聊。
经常有人反驳RSI说:到目前为止,许多关键工作仍掌握在人手中,比如选择解决哪些问题,这才是最重要的。AI只能执行,缺乏这种判断能力,因此可能无法独立推动自身的进步。
Anthropic在文章中坦诚地指出,确实,目前基于Transformer架构的训练方法,很难让AI出现那种“灵光乍现”的顿悟时刻。当然,这种时刻并非完全不会出现,但它不是必然的,也不是渐进式的。
但话又说回来,人目前做的许多工作,本质上也是在排查问题、修复Bug、尝试各种方法。也就是说,人其实也很少经历“灵光乍现”的顿悟,绝大部分工作都是机械重复的动作。而这恰恰是Agent非常擅长的领域。
就像爱迪生那句名言:“天才是1%的灵感加99%的汗水。”这99%的汗水部分,完全可以由AI自动化实现。这种自动化不仅能处理脏活、累活、高重复性、探索性以及费时费力的工作,还能在一定程度上推动前沿科研和大规模研究的进步。
很多时候,大规模研究的进展取决于工具资源、运行效率、实验速度以及能同时运行的实验数量。即使Agent始终无法获得“灵光乍现”的顿悟,人依然可以掌握决策权和选择问题的权利,让AI去处理其余99%的工作。这样一来,每位开发者、工程师或科学家都能大幅提高工作的速度和质量。
因此从这个角度看,AI提升自身探索边界、完成复杂及重复任务的能力,本身就是一种进步。Anthropic的核心观点是:在这种情况下,AI依然可以持续进化。
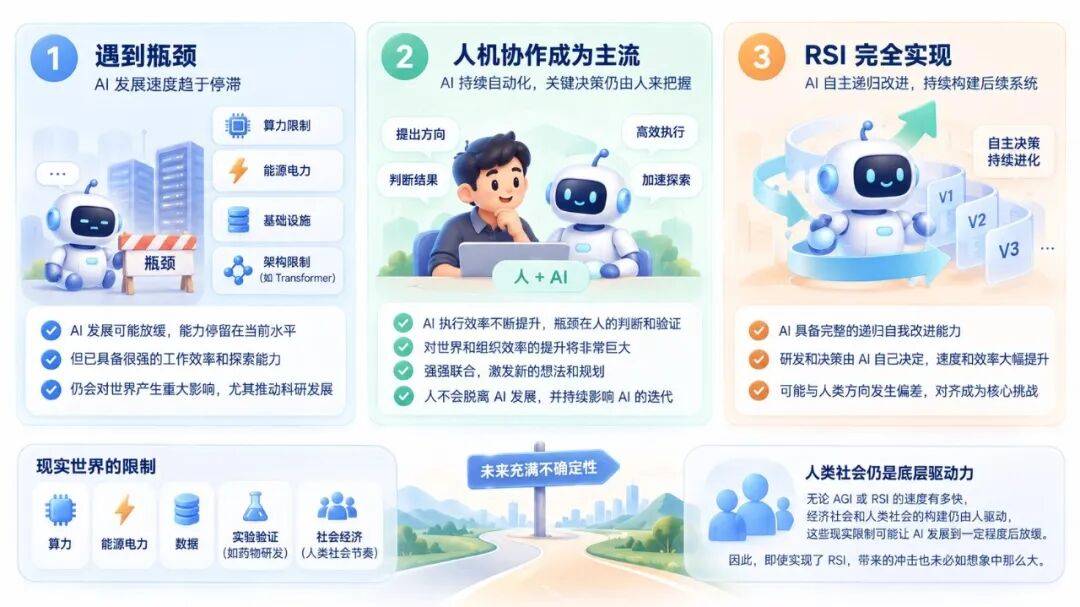
最后,Anthropic也给出了RSI发展的几种可能方向:
第一种可能是遇到瓶颈。由于算力、底层基础设施、电力能源等供应的限制,AI的发展速度可能会趋向停滞。如果一直基于Transformer这种架构,这种情况很可能出现,导致AI发展放缓。但即便模型能力停留在当前水平,依然会对世界产生较大影响。因为目前AI的工作效率和探索能力已经很强了,在很多场景下可以帮助大家完成更复杂的任务,尤其是助力科研发展,从而在一定程度上推动世界前进。
第二种可能是人机协作成为主流。AI会不断实现自动化,但关键的研究方向、结果判断以及解决哪些事情,仍然由人来决定。这种情况下,AI的运行和执行效率会越来越高,但瓶颈会卡在人的判断和验证时间上。不过即便如此,对整个世界的影响以及对组织效率的提升,仍然是巨大的,其规模肯定远超之前人类社会中各种团队所达到的效率。而且我们目前很有可能正往这个方向走。同时,模型与人的人机协作,很多时候也能带来强强联合,激发许多新的想法和规划,从而促进AI的发展。也就是说,人不会脱离AI的发展过程,但依然会对AI的持续迭代产生较大影响。这不仅是极有可能的情况,更是目前正在发生的状态。
第三种可能是RSI完全实现。AI已具备完整的递归自我改进能力,开始持续构建后续系统。在这种情况下,AI的决策和研发由自己决定,速度和效率会极大提升,但也可能出现与人类方向发生偏差的情况。如何将AI发展的决策路径与人类持续对齐,将是核心挑战。
不过,目前人类很难直观判断世界将来会怎样。但有一个底层逻辑是确定的:经济社会和人类社会整体的构建还是由人驱动的。因此,无论AGI或RSI的速度有多快,人类社会的关系和发展本身就会给AI带来瓶颈。
举个例子,即使AI能快速发明很多种药物,但药物的实验过程和效果观察也需要足够的周期,甚至几十年。AI研发速度再快,也不可能让生物实验的效果验证变得更快,依然要等待足够的时间才能拿到数据。再比如算力瓶颈,即使AI想更快地训练自己,但物理限制就在那里,没法瞬间突破。
因此,整个人类社会的许多限制,可能会让AI发展到一定程度就开始慢慢停下来。所以,即使实现了RSI,所造成的冲击也未必是我们想象的那么大。当然,未来这种瓶颈与速度的平衡,以及人工智能与人类社会的关系究竟会怎样碰撞,暂时也是没有办法准确预测的。
09、RSI 可能带来的风险
前面的讨论是 Anthropic 对未来的思考,整体比较乐观一些,而我们也不能回避一个严肃的问题:RSI如果真的跑起来了,会带来哪些风险?
前面提到过 Geoffrey Hinton、Yoshua Bengio 等大佬最近联合发表的论文《What if automating AI R&D triggers an intelligence explosion?》中就专门讨论了这个问题。当然,论文并不是说每个领域的 RSI 项目都有风险,风险大小取决于能力、权限、部署规模、收益分配以及制度安排。比如,医学进步等好处可能会提前数年甚至数十年到来。所以我们对 RSI 分析应该同时需要考虑这项技术带来的潜在的好处、风险和各类不确定性。
总体来说 ,RSI 的核心风险可以归纳为三个层面:
第一,社会适应不及时,AI 能力增长快于应对能力。智能爆炸可能让各种风险提前出现,压缩了人类调整制度、协调方向和建设防御的时间。所以真正的风险在于一种错配:威胁可以借助AI快速增长,但必要的缓解措施却因为依赖现实而变得很慢。
第二,人类监督削弱与失控,自动化研究链也可能自动化错误。当人类越来越少参与研发,不仅减少了发现和修正问题的机会,也可能丧失独立判断所需的专业知识。更强的系统更难监督,而“用AI可靠地监督AI”仍然是一个没解决的挑战。如果监督不足,未对齐的系统可能污染后继系统的研发,或者突破隔离环境在授权范围之外行动,这些问题还会随着后继模型和研发流程被继承下去。
第三,研发优势可能变成难以追赶的行动优势。现有的 AI 各方互相制衡依赖于任何一方都不能在思考和执行上远超其他各方。如果某一方的前沿系统的访问权高度集中,智能爆炸可能使原本有限的研发优势迅速累积,削弱外部的追赶、监督和反制能力。这种失衡甚至可以来自人类行为主体利用 AI,并不一定需要 AI 先脱离人类控制。
这三类风险有不同的触发路径,即使 AI 系统始终服从人类,社会适应不及时和权力集中在某一方仍可能发生;即使 RSI 能力尚未进入爆炸式增长,监督的弱化也可能会导致局部研发风险事故。因此,“证明没有发生智能爆炸”不能说明不需要对实际部署权限、监督质量和制度影响做持续的检查。
RSI 的发展前景虽然确实很让人兴奋,但是真的需要保持清醒,这是我们在拥抱 AI 技术的同时,必须同步思考的事情。
10、总结
“兼听则明,偏信则暗”,关于 RSI 不同的声音还是很多的,我在整理信息资料的时候也尽量客观一些,不同的研究和观点让大家都可以了解一下。整体来看 ,RSI 的发展还在持续进行中,目前的很多研究其实还没有很成熟。但是大家也都能明显感觉到,目前许多国内外大厂都在 RSI 上进行了重点投入,甚至有些头部玩家已经宣布他们最新的模型就是基于 RSI 搞出来的了。所以,我个人感觉,通用基模层面的RSI,真的已经离我们不再那么遥远了。
但话说回来,只有基础模型的 RSI 还远远不够。真正能把这波技术变革落到实处的,还得是各类跟具体业务深度结合的 RSI。只有通用底座和业务场景双管齐下,大家一起发力,才能真正推着整个AI行业滚滚向前。这就是我们接下来要一起见证、也要一起参与的时代。所以我们还是需要持续去观察整个AI 以及 Agent的发展是如何继续演进的。我们要不断观察这些新技术在工作、生活中哪些是值得尝试和借鉴的,能够帮助提升我们任务的执行效率,降低运行成本,更好地赋能我们自己。这才是当下我们真正需要关注,并且需要长期持续跟进的事情。当然,我也会继续跟进相关的最新研究,未来给大家做更多的分享。
本文内容就到此结束了,这篇文章写了挺长时间的,而且内容越加越多,也越来越发现这个研究领域还是很庞大的。我个人水平能力也有限,加上行文比较仓促,难免有瑕疵、纰漏之处。如果大家有任何问题或者建议意见,也非常欢迎在评论区留言,我们一起交流、互相学习,共同进步。谢谢大家!
References
[1] 深度解析 RSI:https://mp.weixin.qq.com/s/w7i-fp2QAPJVGN6PgHZqrQ
[2] Wikipedia: Recursive self-improvement
[3] Anthropic: When AI builds itself
[4] What if automating AI R&D triggers an intelligence explosion? Geoffrey Hinton, et al
[5] DeepMind: Levels of AGI for Operationalizing Progress on the Path to AGI
[6] METR: Research note: The Economics of Recursive Self-Improvement
[7] DGM: Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents
[8] SkillOpt: Self-Optimizing Skills for Language Model Agents
[9] SkillSmith: Co-Evolving Skills and Tools for Self-Improving Agent Systems
[10] MemRL: Self-Evolving Agents via Runtime Reinforcement Learning on Episodic Memory
[11] SEAL: Self-Adapting Language Models
[12] Self-Rewarding Language Models, Meta, NYU
[13] DiscoRL: Discovering State-of-the-Art Reinforcement Learning Algorithms, Google DeepMind, Nature
[14] SIA: Self Improving AI with Harness & Weight Updates, Hexo Labs, Oxford
[15] AlphaEvolve: A coding agent for scientific and algorithmic discovery, Google DeepMind
本文作者@阿里技术。原文链接:https://mp.weixin.qq.com/s/5SeQEderLjF53_579jJbVQ