Coding Agent 跑一轮仓库级任务,账单烧掉好几块,等结果还要盯着进度条发呆?DeepSeek 最新版 Flash 就是冲着这个痛点来的:一次更新把终端基准拉高三分之一多,输出价格却只有同级旗舰的一个零头。它快得真实,也糙得真实。
产品概述
Flash 系列一向是 DeepSeek 的走量款,1017 这个版本号却有点反常。
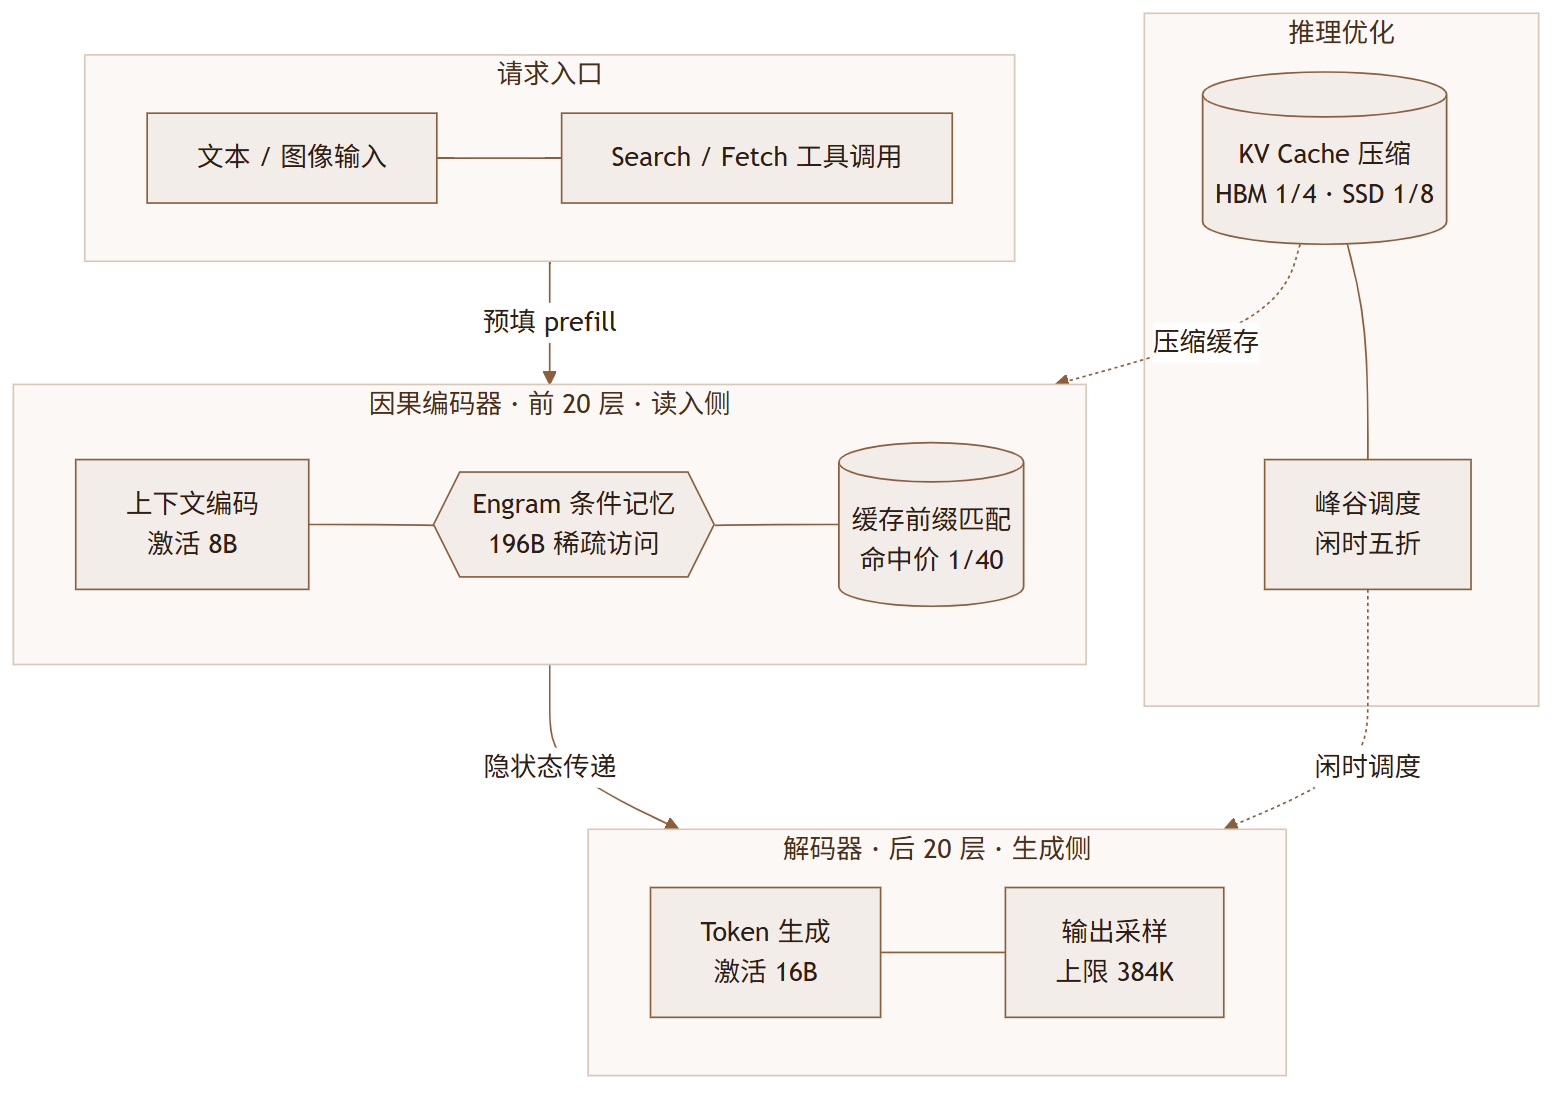
距离 9 月 10 日 V4.1 Flash 首发只过了一个多月,官方就推了一次全面强化,网页端、App、API 三端同步切换,调用方式没变,还是 deepseek-flash 这个模型名。家底也交代清楚:552B 参数的 MoE 模型,外加 196B 的 Engram 条件记忆参数,骨架是全新的因果编码器-解码器结构,40 层语言主干里前 20 层读输入、后 20 层逐 token 生成,输入侧只激活 8B 参数,输出侧激活 16B。上下文窗口 1M,最大输出 384K,原生支持多模态视觉理解,权重以 MIT 协议开源在 Hugging Face 和 ModelScope。
1017 更新的核心叙事只有一句话:性能涨,任务运行时间和输出长度同时降,官方称之为新的性能-费用帕累托改进。这次还一起开放了自研的 Search 和 Fetch API,用于网页搜索与网页抓取,5 元 1000 次成功请求,11 月 1 日起正式计费。
官网:https://www.deepseek.com
API 文档:https://api-docs.deepseek.com

核心功能
功能层面值得细说的有四件事,每一件都对应一类真实账单。
第一是非对称架构带来的预填成本减半。Coding Agent 的账单大头往往不是生成代码,而是一次次把整个仓库、历史对话、测试日志重新塞进上下文。编码器-解码器拆分之后,长输入阶段的计算量接近砍半,对高频 Agent 场景是实打实的省钱,也解释了为什么多个编程工具愿意把它推成默认模型。
第二是 KV Cache 的极限压缩。相比上一代,V4.1 Flash 对 HBM 的需求降到四分之一,对 SSD 的需求降到八分之一,官方口径是相对初代模型已缩小 437 倍。缓存命中在 Agent 成本里占比很高,压缩之后长任务的持有成本明显下降,这是架构层面而非营销话术的改进。
第三是原生多模态。视觉理解不需要外挂模块,BabyVision 基准 92.5 分,Chartography 83.0 分,图表理解、图文混合这类活儿可以直接丢给它,不用先跑一遍 OCR 再接文本模型,链路短了,出错环节也少了,多模态 Agent 的搭建成本和调试难度随之下降。
第四是 1017 新增的自反馈强化学习方向:从零构建完整项目的能力,覆盖游戏开发、3D 建模等场景,官方说法叫承接许愿式编程,即在提示词和素材极少的条件下直接产出可运行的项目。官方还针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等平台框架做了适配优化,Harness 建议升到 0.2.1-rc.1 以上。
上手体验
接入路径对开发者极其友好,甚至可以说没有路径。
充值之后到开放平台创建 API Key,端点同时兼容 OpenAI Chat Completions 和 Anthropic Messages 两套协议,存量 Claude 系代码基本零迁移成本,改一个模型名就能跑。模型名写 deepseek-flash,旧名 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 仍会被路由到 1017,但建议直接换新名,免得后续兼容期结束踩坑。整个接入过程不看文档也能在十分钟内走完。
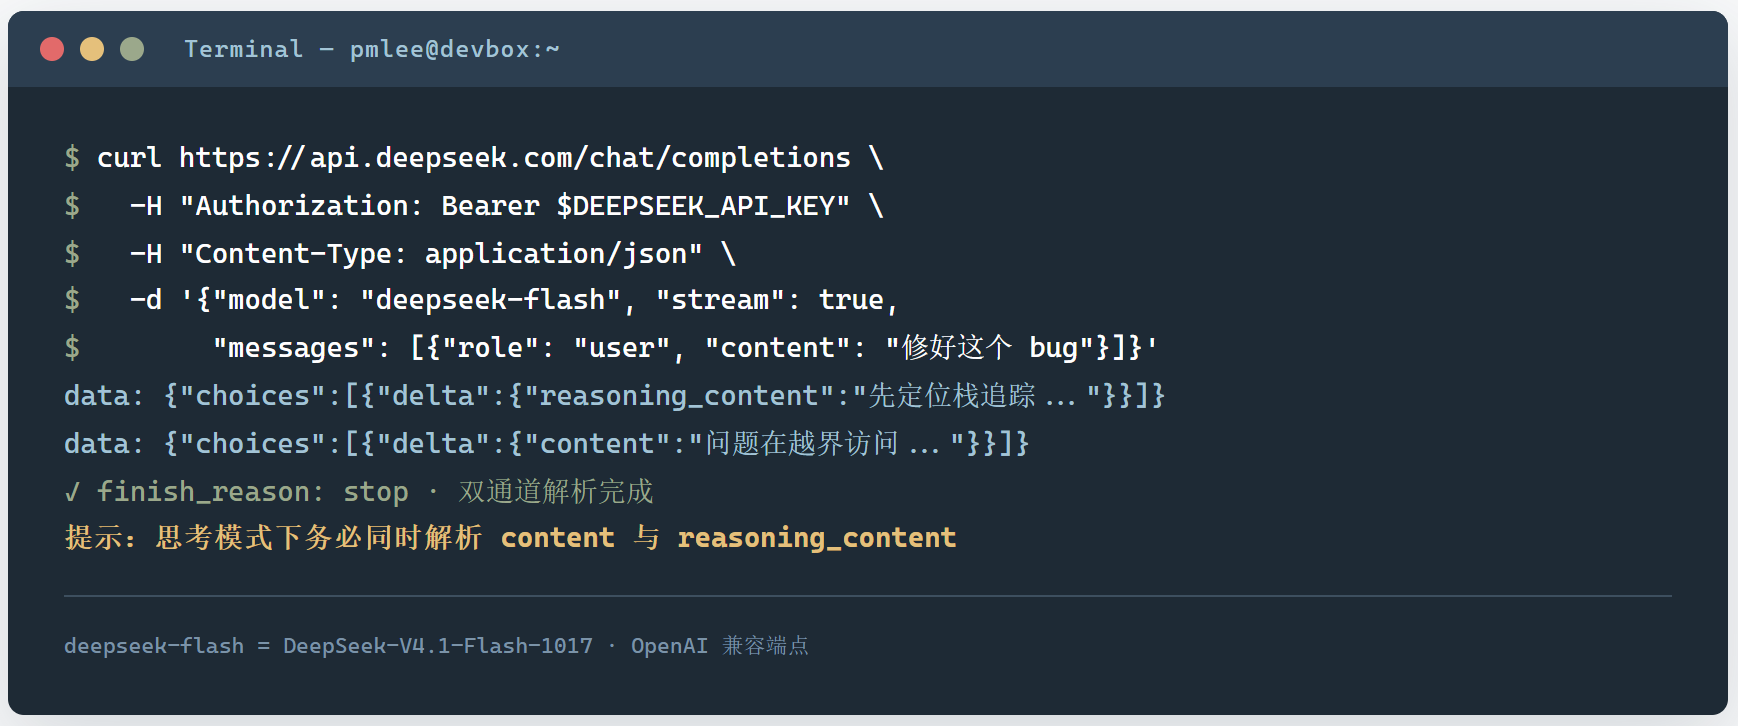
第一次调用的观感就一个字:快。第三方机构 Artificial Analysis 实测平均输出 195 tokens/s,首 token 约 11 秒且含思考时间;社区在轻负载下观察到的峰值接近 490 tokens/s,稳定态 300 以上。需要提醒的是,官方 API 没有免费额度层,预充值按量付费,想零成本试手只能去 OpenCode 这类第三方平台,但那边只给 200K 上下文。
使用技巧
很多人不知道,想把 1017 用出性价比,有三条经验可以直接抄。
- 把灵活度高的活儿排到闲时。峰谷定价下闲时全部五折,输出从 8 元降到 4 元每百万 tokens,批处理、离线评测、数据清洗这类不赶时间的任务,挪出 UTC 周一至周五的 01:00-04:00 和 06:00-10:00,账单直接对半。
- 缓存前缀要主动设计。把系统提示、工具定义、长文档放在 prompt 最前面且保持稳定,缓存命中价只要未命中的四十分之一,Agent 类应用省的是大头。
- 长上下文任务盯紧速度衰减。社区实测上下文超过 100K 后输出速度掉到 100 tokens/s 以下,接近 200K 时约 50 tokens/s,同一个任务的等待时间能差出近十倍。超长程规划请拆段,或者交给旗舰模型。
还有两条细节值得记一下。纯代码补全场景要选非思考模式,FIM 补全只在非思考模式下可用,选错模式会直接报不支持。做流式解析的代码则务必同时处理 reasoning_content 与 content 双通道,具体原因在用户反馈章展开说,那里有一个真实的线上事故样本。
竞品对比
对比之前先把对手摆清楚,同一个价位段的竞争者其实很好数。
同级开源阵营有 GLM-5.3 和 Kimi K3,闭源旗舰是 GPT-5.6 Sol 和 Claude Opus 5,五个模型的跑分全部来自 DeepSeek 官方基准表,价格为 2026 年 10 月第三方汇总的刊例价,单位是美元每百万 tokens,横向对比时请注意各家口径并不完全一致。
| 维度 | V4.1-Flash-1017 | GLM-5.3 | Kimi K3 | GPT-5.6 Sol | Claude Opus 5 |
|---|---|---|---|---|---|
| HLE(无工具) | 42.6 | 42.0 | 43.5 | 44.5 | 56.3 |
| Terminal-Bench 4.0 | 42.3 | 37.9 | 12.6 | 39.9 | 51.8 |
| DeepSWE v1.1 | 77.0 | 66.9 | 67.5 | 73.0 | 74.0 |
| ProgramBench | 29.1 | 19.0 | 17.5 | 23.0 | 37.0 |
| NL2Repo-Bench | 68.2 | 58.0 | 58.0 | 56.8 | 75.3 |
| 输出价格(美元/百万) | 0.60-1.20 | 4.40 | 15.00 | 20.00 | 25.00 |
| 开源权重 | MIT | 开放 | 开放 | 否 | 否 |
口径说明:HLE 一列中 1017 的 44.0 为纯文本子集成绩;Terminal-Bench 4.0 使用 Claude Code 框架测试,DeepSWE v1.1 使用 Mini-SWE-V2 框架测试,各家自报成绩存在框架差异。
几个数字值得咂摸。Terminal-Bench 4.0 上 1017 拿到 42.3,压过 GPT-5.6 Sol 的 39.9,仅次于 Claude Opus 5 的 51.8;但 HLE 这种硬推理基准,Opus 5 的 56.3 又把它甩开十几分。价格维度更极端:输出单价只有 Opus 5 的二十四分之一到四十八分之一,是 Kimi K3 的二十四分之一。总结这张表:编码和 Agent 任务它已经摸到旗舰门槛,纯推理还差一档,但价格差了二十倍以上。选型时就一个原则:按任务类型分层,而不是全网一个模型打天下。
用户反馈
社区的讨论热度很高,但口碑相当两极,喜欢的和吐槽的往往是同一批重度用户。
好评集中在速度和成本两头。OpenCode 公开用量榜上它是 token 消耗量最大的模型;有第三方按真实请求测算,峰时单价下平均每个 Coding 请求约 0.0067 美元,同样的活儿成本只有旗舰模型的零头。不少开发者把高频的检索、改写、批量处理全压给它,账单肉眼可见地瘦下来,这也是它被多个编程工具设为推荐模型的原因。
差评集中在稳定性和智商波动。GitHub Issue #1673 记录了一个硬缺陷:开启思考的流式调用中,模型会间歇性把完整回答写进 reasoning_content 字段而 content 为空,回放三个生产对话,45 次运行有 13 次中招,发生率约三成,调用方无法区分正常完成与静默失败。此外社区频繁吐槽输出车轱辘话、上下文到 300K 后就需要压缩交接、复杂任务返工,论坛甚至给了个工作记忆很低的诊断。
多维评分
综合基准数据、第三方实测与社区反馈,八个维度打分如下,无 N/A 维度。
| 维度 | 权重 | 星级 | 一句话解读 |
|---|---|---|---|
| 功能完整性 | 20% | ⭐⭐⭐⭐⭐ | 多模态、1M 上下文、双协议齐全,FIM 限非思考模式 |
| 易用性 | 15% | ⭐⭐⭐⭐☆ | 改个模型名即可接入,但无免费额度需先充值 |
| 性能表现 | 15% | ⭐⭐⭐⭐☆ | 闲时快至 300+ tokens/s,峰时与长上下文波动明显 |
| AI 能力 | 15% | ⭐⭐⭐⭐☆ | Terminal-Bench 压过 GPT-5.6 Sol,硬推理距 Opus 5 一档 |
| 价格合理性 | 10% | ⭐⭐⭐⭐⭐ | 峰谷五折加缓存四十分之一价,同级最低一档 |
| 生态集成 | 10% | ⭐⭐⭐⭐☆ | CodeBuddy、WorkBuddy、OpenCode 全面适配,权重 MIT 开源 |
| 文档与支持 | 10% | ⭐⭐⭐☆☆ | 文档详尽,但 10 月 15 日刚出过近 5 小时全线故障 |
| 更新频率 | 5% | ⭐⭐⭐⭐⭐ | 一个多月一次大版本,1017 全端同步切换 |
综合评分:8.2 / 10
优缺点
优点很直白:便宜、快、跑分能打。闲时输出 4 元每百万 tokens,缓存命中低至 0.02 元,Agent 类任务的持有成本被架构级压缩;Terminal-Bench 4.0 拿到 42.3 分,意味着它不再是只能干粗活的小模型;MIT 开源权重给了自部署的退路,2000 卡以上规模还可以直接联系官方谈部署方案。
缺点也很直白。速度像坐过山车,社区观测区间从 50 到 490 tokens/s,长上下文衰减接近十倍;复杂任务上工作记忆不足,容易在小细节上反复试错、来回返工;流式回答存在写入错误通道的已知缺陷;服务稳定性今年已发生十余次异常,10 月 15 日故障持续 4 小时 52 分钟,官方按账号 7 日消耗金额以赠金返还作为补偿。
适用人群
有四类团队最适合把它放进主力位。
高频 Coding Agent 开发者是首选人群。读取仓库、回放历史、接收测试日志的负载模式下,预填减半加缓存压缩直接转化为成本优势,Terminal-Bench 42.3 分也撑得起日常迭代节奏,写码改 bug 的循环里省下的每一秒都是复利,用量越大体感越明显。
成本敏感的批量任务团队同样合适。数据清洗、分类、摘要、改写这类对智力密度要求不高的走量活儿,用旗舰模型属于拿大炮打蚊子,Flash 档位定价与能力的配比刚好,闲时再打对折就更香,月度账单能压到旗舰方案的十分之一以下。
需要私有化部署的团队值得考虑。MIT 权重加 1M 上下文,金融、政企场景可以自建推理集群掌握数据边界,不用担心 prompts 离开内网,国家超算互联网也已同步上线其 API 服务与权重文件,多了一条合规采购渠道,批量部署还可以直接联系官方洽谈。
还有一类是想做多模型路由的架构方。把它当量大管饱的底层,把超长程规划和难推理上抛给旗舰,成本和质量都能照顾到,路由规则按上下文长度和任务类型两个维度切分即可落地。反过来说,只做硬推理且预算充足的团队,它并不是旗舰的替代品。
定价方案
钱的事儿最受关注,先把 1017 的计价规则说清楚。
截至 2026 年 10 月,DeepSeek API 对 1017 执行峰谷定价,闲时全部五折。峰时为 UTC 时间周一至周五 01:00-04:00 与 06:00-10:00,不含中国法定节假日,其余时段含周末都按闲时计费,排班的时候可以直接对照这个区间,把批量任务挪出峰时就是最直接的省钱动作。
| 计费项 | 闲时 | 峰时 |
|---|---|---|
| 输入(缓存命中,每百万 tokens) | 0.02 元 | 0.04 元 |
| 输入(缓存未命中,每百万 tokens) | 1 元 | 2 元 |
| 输出(每百万 tokens) | 4 元 | 8 元 |
| 并发上限 | 2500 | 2500 |
换算成美元,闲时输出 0.60 美元,峰时 1.20 美元。作为参照,Claude Opus 5 输出 25 美元,GPT-5.6 Sol 20 美元,Kimi K3 15 美元,GLM-5.3 4.40 美元。同档开源里 MiniMax M3 与它价格接近,但跑分不在一个区间。这笔账的算法很简单:按需付费没有月费门槛,闲时调度加缓存命中设计能把综合成本再压一半,唯一要防的是峰时忘关的批量任务。
FAQ
问的人太多,挑十个最有代表性的统一回答。
Q1:DeepSeek-V4.1-Flash-1017 和 9 月发布的 V4.1 Flash 有什么区别?
A1:1017 是全维度强化版,调用方式不变。 Terminal-Bench 4.0 从 31.2 涨到 42.3,DeepSWE v1.1 从 74.2 到 77.0,同时任务运行时间和输出长度缩短,单次调用综合成本下降。
Q2:API 调用需要改代码吗?
A2:不用,模型名继续用 deepseek-flash。 网页端、App、API 已在 10 月 17 日同步切换,旧模型名 deepseek-v4-flash 也会被路由到 1017,按 Flash 价格计费。
Q3:它有免费额度吗?
A3:官方 API 没有免费层,需预充值按量付费。 想免费体验只能走 OpenCode 等第三方平台,但上下文通常限 200K,且不计入额度的政策可能随时调整。
Q4:权重可以商用吗?
A4:可以,MIT 协议。 1017 权重已在 Hugging Face 和 ModelScope 开放下载,自部署和商用都没有协议障碍,2000 卡以上规模部署可以直接联系官方。
Q5:为什么有时候感觉很慢?
A5:峰时调度和长上下文是两大减速带。 社区观测闲时峰值约 490 tokens/s,但超过 100K 上下文会掉到 100 以下,200K 时约 50 tokens/s,峰时排队还会进一步放大等待。
Q6:Vision 版本和文本版是同一个模型吗?
A6:是同一个,视觉能力原生内置。 不需要切换型号,直接传图即可。但要注意 FIM 代码补全只在非思考模式可用,选型时别搞错。
Q7:流式返回偶尔出现空内容怎么办?
A7:这是已知缺陷,需要客户端兼容。 思考模式下模型可能把完整回答写进 reasoning_content 而 content 为空,GitHub Issue #1673 实测发生率约三成,解析时必须把 reasoning_content 作为兜底数据源。
Q8:V4 Pro 还能用吗?
A8:已停止服务,请求会被路由到 1017。 9 月 14 日之后 deepseek-v4-pro 的调用全部由 V4.1 Flash 承接且按 Flash 价计费,V4.1 Pro 上线前不会变。
Q9:新出的 Search 和 Fetch 怎么收费?
A9:5 元 1000 次成功请求,11 月 1 日起计费。 两个接口分别用于网页搜索和网页抓取,目前通过 DeepSeek Harness、Claude Code、Codex 调用暂不收费。
Q10:适合当客服机器人的主力模型吗?
A10:中短上下文高频场景很合适。 200K 以内、问答轮次短的负载能跑满性价比;一旦上下文持续膨胀,速度衰减和上下文污染会明显拖累体验。
结尾
1017 这次更新把 Flash 系列推到了一个尴尬又舒服的位置:说它旗舰,HLE 42.6 和 Opus 5 的 56.3 还差着一档;说它走量款,Terminal-Bench 42.3 又真能扛事。真正划算的用法不是二选一,而是按任务分层:高频、长输入、可容忍返工的活儿交给它,难推理、长程规划的硬骨头留给旗舰。
如果你的账单已经被 Coding Agent 吃疼,这个模型值得在本周接入试跑。但要留个心眼:流式双通道的解析兼容做扎实,批量任务挂闲时队列,别把全部身家押在任何单一服务上,10 月 15 日那次近 5 小时的故障就是提醒。