
你让 agent 改一个表单校验,半小时后它顺手重排了目录,给三个模块换了名字,还在 PR 里补了一段你没要求过的架构说明。代码能跑,测试也过了,但你不敢合。问题不在它写得差,在于它替你做了一串没人授权的决定,而且每一步看起来都挺合理。这种返工没有报错,只有似是而非。
Skill Leaderboard 上排在第一位的 mattpocock/skills 就是冲着这件事来的。榜单页面写的是 39 个 skill 文件,综合排名与软件工程分类都是第一,还列了九种兼容 agent,Claude、Codex、Cursor 都在其中。GitHub API 那边更直白:322640 个 star,27058 个 fork,238 个开放 issue,仓库创建于 2026 年 2 月 3 日,MIT 协议。九个月攒到这个量级,本身就值得拆一拆。
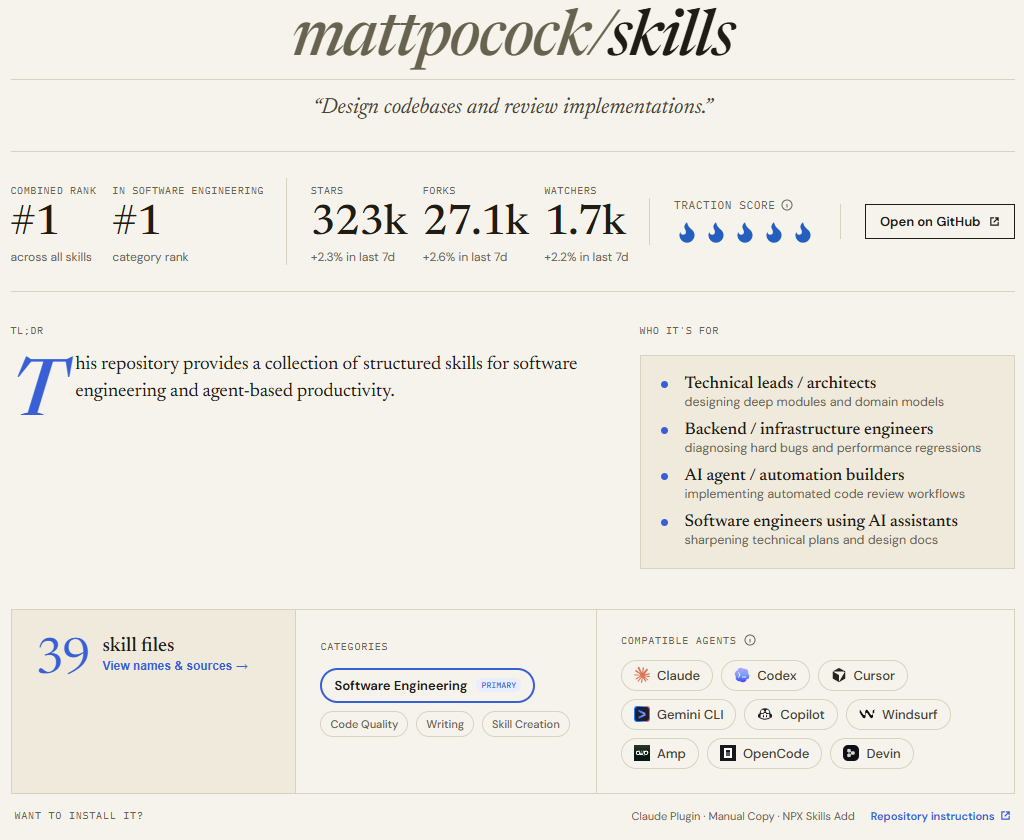
反常识的地方在 README 开头。它没急着列功能,先把 GSD、BMAD、Spec-Kit 点名摆在对面,说这类方法靠 owning the process 帮忙,代价是夺走你的控制权,流程里出了 bug 还难查。一个技能仓库先把同类方法论当对手,这不像产品介绍,更像一份立场声明。顺着读下去会发现,整份文档反复在讲同一件事:别让 agent 自己决定什么时候该停下来问人。
这篇按架构来拆,不按功能清单走。想看清的是三件事:39 个技能靠什么轴组织,一次改动从提问到 PR 怎么串起来,以及这套东西在什么条件下会打折扣。我的判断先摆在这儿,它真正卖的不是能力扩展,是一整套约束 agent 自主性的刹车,那 32 万星里大部分人买的可能就是这个。
架构解析
多数技能仓库按功能分,写代码一类,测试一类,文档一类。这里偏偏用了另一个轴,谁有权调用。README 的 Reference 写得很硬,user-invoked 只有你敲斜杠命令才能启动,职责是编排;model-invoked 你能敲,agent 判断任务合适也能自己够到,承载可复用的纪律。分完还补了一刀,user-invoked 可以调 model-invoked,但绝不能调另一个 user-invoked。
那条禁止回指的边比分类本身有意思。技能之间互相调用最容易长出套娃,一个入口唤醒另一个入口,上下文里叠着两轮访谈、两份计划,最后没人说得清哪个决定算数。从源码看,grill-me 的 SKILL.md 正文只有一行委托,grilling 才是那个被反复复用的原语。把编排权和纪律切成两层,等于给调用图定了个方向,只允许往下走。
触发权锁在人手里,还顺带解决了另一个容易被忽略的问题,什么时候不该用。访谈如果能被模型自动唤醒,改个拼写错误也可能触发一场架构盘问。把启动开关交回用户,等于把“值不值得停下来想清楚”这个判断也一并交回去了。很多技能设计只管能力够不够,不管什么时候该闭嘴,这里补的正是后半截。
四个目录桶的分工也清楚,但三份公开资料给出的数量并不一致:
| 来源 | 数量 | 口径 |
|---|---|---|
| Skill Leaderboard 仓库页 | 39 | 仓库内收录的 SKILL.md 文件 |
| GitHub README Reference | 27 | 当前文档化的工程与效率技能 |
| skills.sh 仓库页 | 59 | 平台上出现过的技能条目 |
README 那 27 个拆开看是这样:
- 工程类 user-invoked 11 个
- 工程类 model-invoked 9 个
- 效率类 user-invoked 5 个
- 效率类 model-invoked 2 个
三个数字打架不等于有人算错,从各页面的措辞推断,更像统计口径不同,一个按文件数,一个按当前推荐清单,一个按历史发布记录。对新人来说这仍是一笔认知成本,后面还会回到这点。
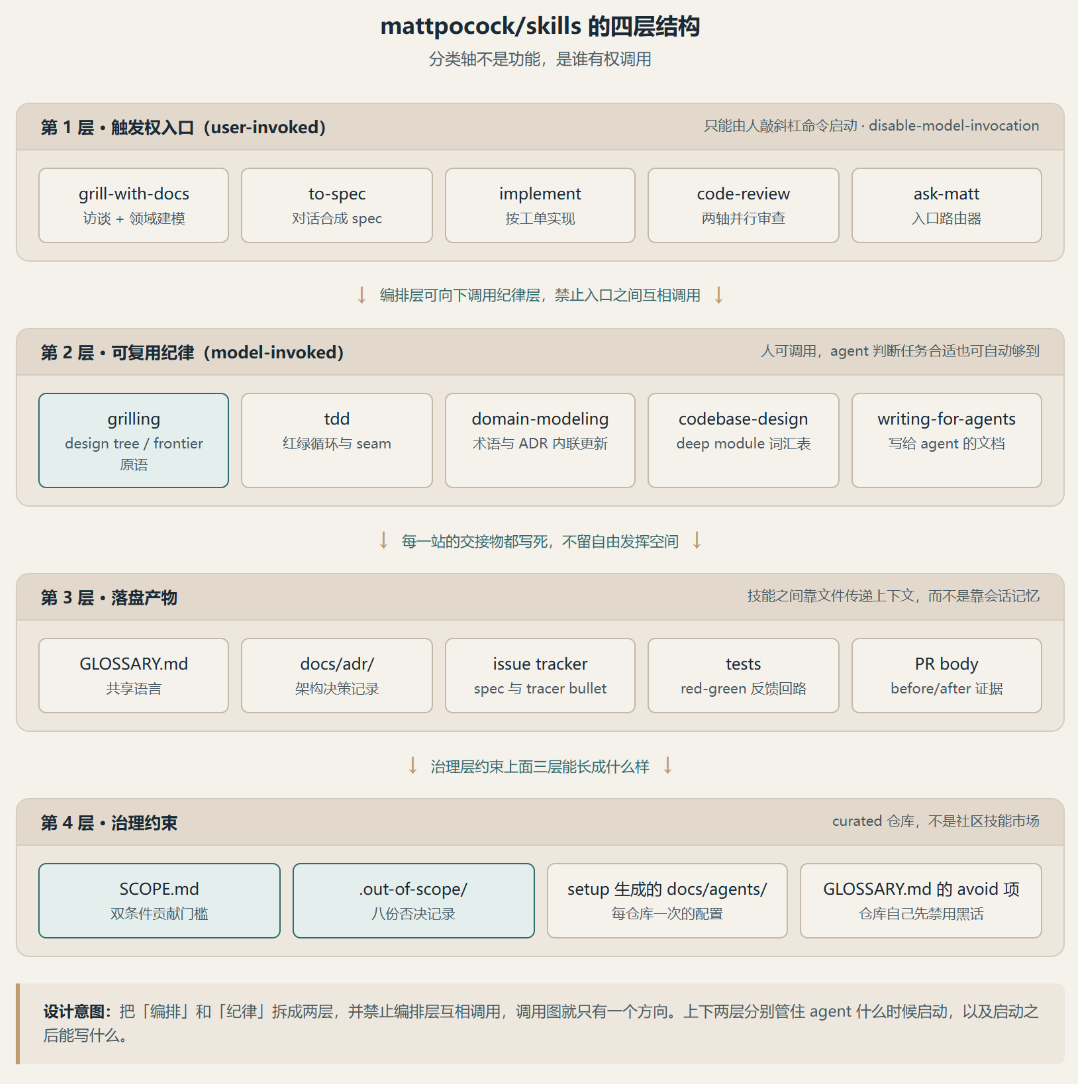
图里最下面那层容易被跳过,其实是这个仓库跟普通 prompt 集合拉开距离的地方。SCOPE.md 给贡献设了一道双条件门槛:issue 必须描述真实会话里观察到的失败,还得不撞进 .out-of-scope 里已否决的概念。假设性的“如果这样更好”不收,配置项、harness 分支、个人工作流偏好一律劝去自己的 CLAUDE.md 或 fork。尺寸不算数,一个字的修改和一次重写走同一条标准。
还有个更狠的设定,新技能提案直接关闭。SCOPE.md 写的是,如果某个行为能由现有技能组合出来,就不给它新建一个文件。.out-of-scope 目录里躺着八份否决记录,从 harness 命名冲突到子代理递归,每一份都写清为什么不做。这相当于把“不做什么”当成一等文档维护,比多数项目的 ADR 更实用,因为它拦的是新增,不是事后追认。
工作流分析
README 把 agent 写代码的翻车归成四类,每类配一句经典引文和一个修复入口,对应关系比功能列表好读:
| 失败模式 | 症状 | 对应修复 |
|---|---|---|
| 没做你要的事 | 需求理解偏差,返工三轮 | grilling session、grill-with-docs |
| 太啰嗦 | 二十个词说一个词的事 | shared language、GLOSSARY.md、ADR |
| 代码跑不通 | 没有运行反馈,agent 盲飞 | 静态类型、浏览器访问、tdd 的红绿循环 |
| 长成一团泥 | 复杂度随 AI 提速狂飙 | deep modules、to-spec、架构勘察 |
四类里最被低估的是第二类。README 借了 Eric Evans 那句 ubiquitous language,然后给了个很具体的例子,与其说“课程里某一节被变成真的,在文件系统里占了位置”,不如说“materialization cascade 有问题”。术语收进 GLOSSARY.md,变量和函数命名跟着统一,agent 读代码少绕路,思考也少烧 token。这不是文风问题,是把领域模型外置成共享缓存。
真正让这套东西不流于口号的,是仓库自己先照做了。根目录的 GLOSSARY.md 定义了 Issue tracker、Issue、Decision ticket 等四个术语,还逐个列出 avoid 项,禁止再用 backlog manager 这类含糊叫法。它甚至把一段历史歧义记了下来,backlog 曾经既指工具又指待办集合,现已消解,工具统一叫 Issue tracker。文档写着别让 agent 猜黑话,仓库自己就没留黑话。
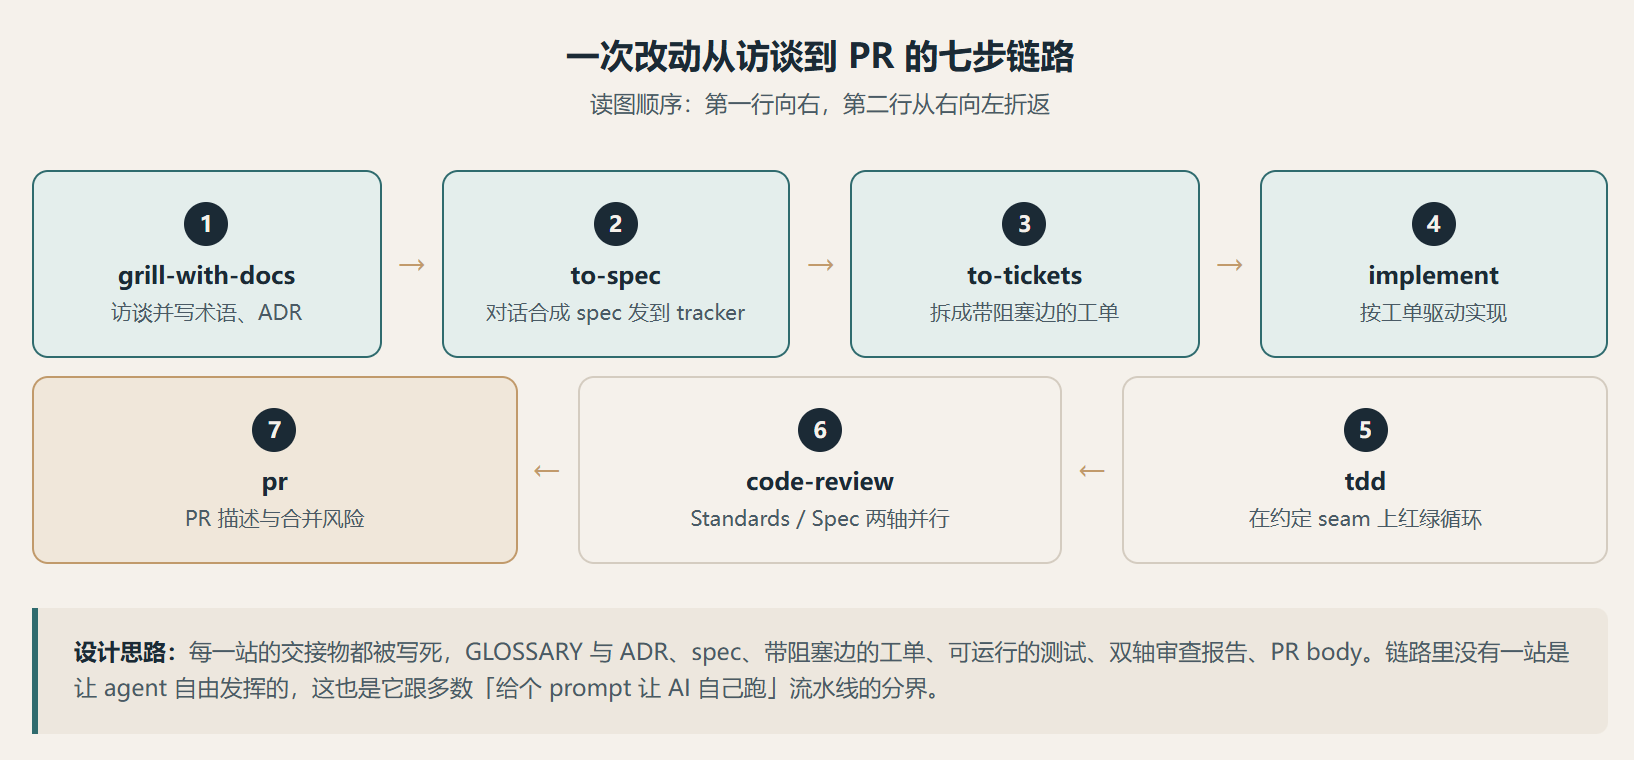
链路读起来像一条常规研发流水线,差别在每一站的交接物都被写死了。grill-with-docs 边访谈边把术语和决策落进 GLOSSARY.md 与 ADR,to-spec 只把已经聊清楚的对话合成 spec,to-tickets 拆成带阻塞边的 tracer bullet,implement 在预先约定的 seam 上驱动 tdd,收尾用 code-review 再进 PR。没有一站是让 agent 自由发挥的。
grilling 的 SKILL.md 把提问本身建模成一棵 design tree。当前所有前置条件都已敲定、不必靠猜的问题集合叫 frontier,一轮就是把整个 frontier 一次问完再停下来等。格式也钉死了,每题带编号和标题,紧跟一行 agent 自己的推荐答案,措辞要写成答 yes 就等于接受推荐,别让人在“同意问题”和“同意建议”之间再猜一次。一轮里会有多道这样的题,题间只隔一条水平线。
❓ **Q1** - **<question title>**: <question body, might be multiple paragraphs>

➡️ <your recommended answer>
更硬的一刀是事实和决策的分工。原文写 Finding facts is your job, never the user’s。frontier 里某个问题需要环境事实,就派一个带全新上下文窗口的 sub-agent 去查,而且不阻塞整轮,只有挂在这条事实下游的问题等它,其余照常问。决策一律留给人,frontier 空了也不算结束,得用户确认双方达成共识才允许动手。这道闸门是整套流程里最不像提效工具的一处。
code-review 也是同一个脾气。它把审查拆成 Standards 和 Spec 两条轴,各跑一个并行 sub-agent,明确要求别合并、别重新排序,因为一条轴通过常常正好遮住另一条轴的失败。Standards 那侧还自带一组 Fowler 代码坏味作基线,同时声明仓库文档优先,每条都只是判断而非硬违规。这种防止评价互相污染的设计,在别的技能仓库里很少见到。
使用场景
榜单把受众写成技术负责人、架构师,还有搭自动化代码审查的人。从技能清单看,这个画像偏窄了。有几个技能压根不碰代码:
- teach 拿当前目录当跨会话的教学工作区
- handoff 把当前对话压成交接文档
- to-questionnaire 把一个人答不上来的决策做成问卷,交给真正能答的人
它们共享的其实不是代码场景,是把模糊的东西逼清楚这件事。
装它有点分叉,README 特意用粗体提醒每个 agent 只挑一种,两个都装会得到两套重复技能:
# 路径 A:插件,自动更新,技能文件不可改
claude plugin install mattpocock-skills@claude-plugins-official

# 路径 B:skills.sh,把可编辑副本拷进项目,更新靠手动
npx skills@latest add mattpocock/skills -a <agent>

# 更新与补装
npx skills@latest update
Codex 走 plugin marketplace add,Copilot CLI 要多写一段 extraKnownMarketplaces 配置,Gemini CLI 得对 engineering 和 productivity 两个路径各跑一次 install,重新跑一遍才算更新。README 把这层差异说得很白,插件会自我更新,skills.sh 给你一份能随便改的文件,代价是升级得自己来。
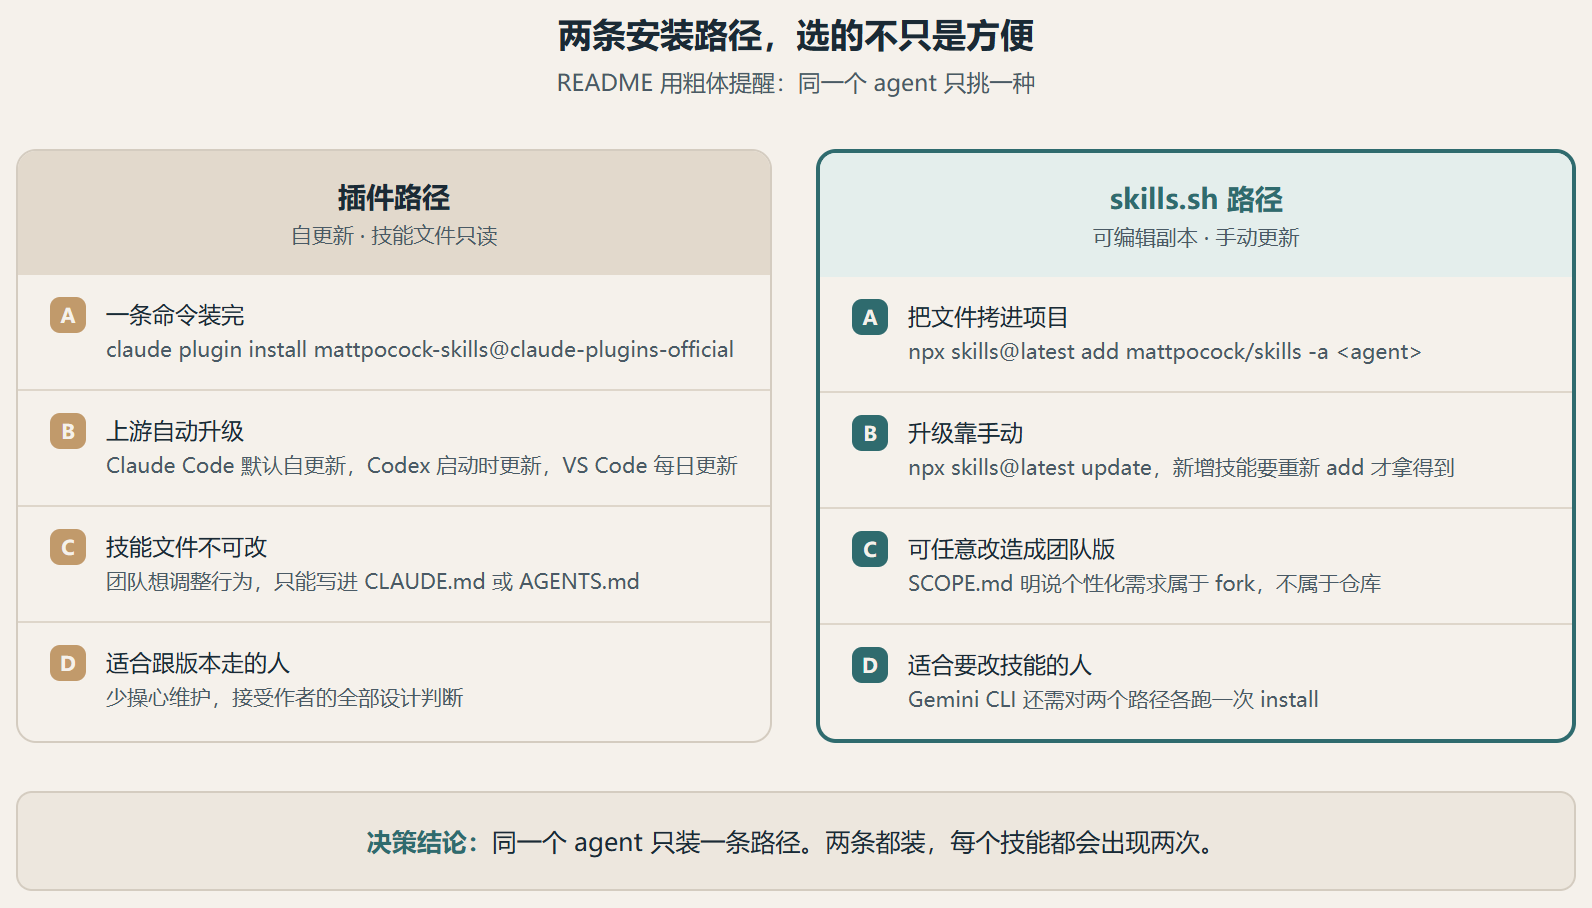
两条路的取舍不是方便与否,是你要不要这份技能的修改权。SCOPE.md 明说个人化配置不属于仓库,属于你的 CLAUDE.md 或 fork,所以真打算按团队习惯改技能的人,走可编辑副本才顺。只想跟着上游走、少操心版本的,插件更省事。选之前想清楚,装重了排查起来挺烦人。
装完还有一道每仓库一次的前置动作,跑 /setup-matt-pocock-skills。它是个 prompt-driven 的技能,不是确定性脚本,先扫 git remote 与 AGENTS.md 这类现状,再检查 GLOSSARY.md 和 docs/adr 这些领域文档,然后一段一段问三件事:
- issue tracker 放哪
- triage 标签叫什么
- 领域文档存哪儿
答案写进 docs/agents/ 下三份文件。跳过这步,to-tickets 和 code-review 里那些读 tracker 的指令就找不到落点。
| 手上的情况 | 这套东西划不划算 |
|---|---|
| 多人协作、长期维护、agent 天天写代码 | 划算,术语和决策沉淀能反复收息 |
| 单人小项目,改动两三个文件 | 不划算,setup 成本盖过收益 |
| 只想找几个好用的 prompt 抄 | 不划算,技能之间互相依赖 |
| 团队愿意把 spec、ADR、审查规范写进仓库 | 最划算,治理层正好接得住 |
洞察与反思
从 SCOPE.md 和 GLOSSARY.md 的写法来看,这仓库的护城河不是 39 个技能的数量,更像是它把自己宣扬的工程纪律原样施加在自己身上。要求项目维护 ubiquitous language,仓库先写 GLOSSARY 并禁掉歧义词;要求项目把决策记进 ADR,仓库先建 .out-of-scope 记录否决过的概念;要求代码别长成一团泥,仓库先关掉新技能提案。自洽程度比 README 里那五本书的引文有说服力得多。
热度数字得泼点冷水。skills.sh 页面显示 grill-me 1.5M 次安装,grill-with-docs 和 improve-codebase-architecture 各 1.3M,tdd 1.2M,而榜单自己就挂着一句 GitHub stars can be faked,另设了 Traction Score 去看近期关注和维护活跃度。32 万星、第一名、百万安装,这些都能证明传播广度,证明不了某个团队合 PR 的速度变快了。README 说这些技能 based on decades of engineering experience,那是经验提炼,不是对照实验。
局限落在三个地方。
一是强绑 harness 能力,SKILL.md 里随处可见 Call the Skill tool 和 fresh context window 这类原语,还要求把 HTML 报告写进系统临时目录再打开,榜单列的九种兼容 agent 里,能不能等价支持是两回事。
二是三个统计数字并存(39、27、59),加上 in-progress 与已经冻结的 misc 桶,新人很容易把停维护的技能当推荐项。
三是 curated 治理的另一面,新提案关闭,自定义需求劝去 fork,质量上限由一个人的判断决定,团队想长出新实践只能自己维护分叉。
如果让我改,会动两处,都算推断。一处是给榜单页和 README 补一句口径说明,把“39 个文件与 27 个当前推荐,外加若干历史条目”写在同一处,省掉读者自己拼图;另一处是让 setup 扫完仓库后输出一份能力自检,标明当前 harness 缺哪些原语以及哪些技能会因此降级。两处都不新增技能文件,只补元数据,成本很低。
还有个更根本的问题没人回答。这套技能把判断权硬留在人手里,人就成了吞吐瓶颈。agent 一小时能写的代码,配一个愿意被追问半小时的使用者,实际吞吐可能不如放手让它跑。我觉得这个取舍对长期维护的 codebase 成立,对一次性原型未必成立,README 没划这条线,只说了 fundamentals matter more than ever。这句话好听,但不构成适用边界。
资源地址
| 资源 | 链接 |
|---|---|
| 榜单主页 | https://www.skillleaderboard.com/skill/mattpocock-skills |
| GitHub 仓库 | https://github.com/mattpocock/skills |
| skills.sh 安装页 | https://skills.sh/mattpocock/skills |
| README 设计说明 | https://github.com/mattpocock/skills/blob/main/README.md |
| 贡献门槛 | https://github.com/mattpocock/skills/blob/main/SCOPE.md |
| 术语表 | https://github.com/mattpocock/skills/blob/main/GLOSSARY.md |
| 开源协议 | MIT |
总结
值不值得装,先看你有没有一个会被反复改的 codebase,以及愿不愿意把 spec 和审查规范写进仓库。两个都答是,这套东西的分层与治理文档会持续产生复利。只想要几个趁手的 prompt,直接抄 grilling 和 code-review 两份 SKILL.md 就行,别把整套治理一起背回家。
自己设计技能时,有三处可以直接拿走。按调用权给技能分层,禁止编排层互相调用;把事实查询和决策权在字面上分开,前者派 sub-agent,后者必须等人签字;把拒绝过的设计当成正式文档维护。第三点最少见,也最能防止一个技能仓库在半年里膨胀成谁都不敢碰的杂物间。
那 32 万星里有多少人真的跑完过一轮完整访谈,再让 code-review 跑完两条轴,没人统计过。但从 SCOPE.md 那句“假设性改进不收”来看,作者大概也不太在意这个数字。他更在意的是,agent 替你做决定之前,有人拦一下。