

改完两百行代码,你跟 AI 说帮我写个 PR 描述。它回你三段话,第一段复述你刚做的事,第二段写这次改动提升了代码质量与可维护性,第三段列了一串你根本没跑过的测试。你想改,又不知道从哪一句改起。
问题不在模型。你给的是一句话的意图,它只能靠猜去补上下文,猜不出来就用最安全最空洞的模板填满。openai/openai-agents-python 这个仓库里有个叫 pr-draft-summary 的 Skill 专门治这个毛病,思路很朴素,一句话能说完:把写 PR 描述这件事拆成四个环节,每个环节都写死约束,最后压进一个 5.6KB 的 SKILL.md。
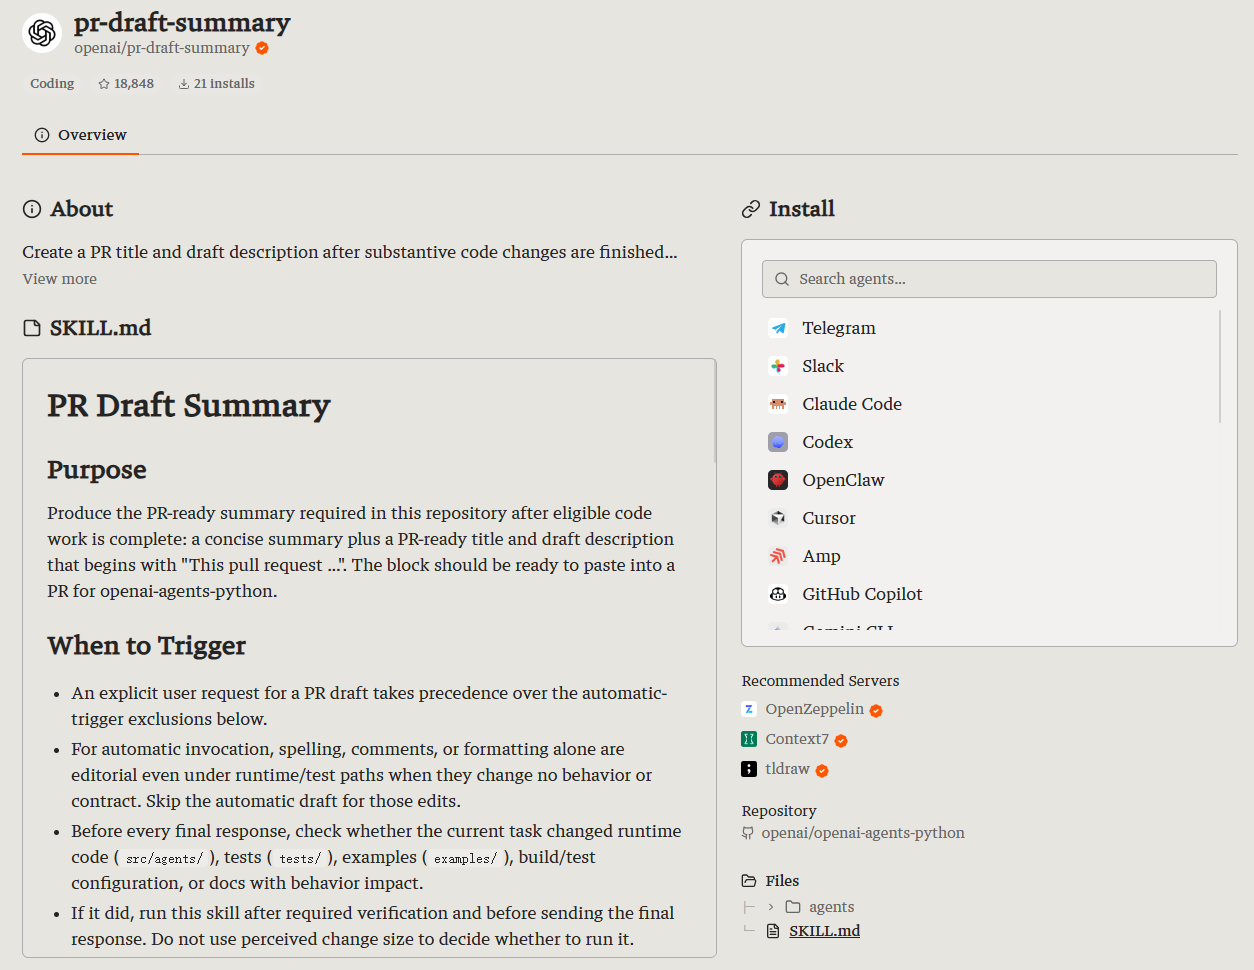
这四个环节分别是:
- 什么情况下才该触发
- 触发后先去采集哪些输入
- 怎么给这次改动定性
- 最终输出长什么样
我一开始以为这只是个格式化脚本,看完才意识到它真正的价值在另一处。它把本来属于模型自由发挥的整段区间,硬切成了一条有门禁的流水线,每个环节都有明确答案:
- 哪些情况才该跑
- 跑之前先执行哪几条 git 命令
- 描述开头必须是哪个动词
- 引用必须归一成什么形态
模型只负责最后一公里的措辞。
这也是它值得拆的原因。它不是社区里那种写着玩的 Prompt 玩具,是 OpenAI 放在自己生产仓库 .agents/skills/ 目录下、跟着代码一起进版本库的工程约束。你拿到的是一份被真实交付流程打磨过的样本。
我准备从四个维度拆它:
- 触发判定是怎么写的
- 输入采集凭什么敢写 do not ask the user
- 十步工作流里哪些步是真正的防呆设计
- 输出规范化为什么要用一整条指令去描述重扫
拆完再聊它的局限和我自己的改法。
架构分析
整份 SKILL.md 是标准五段式:
- Purpose
- When to Trigger
- Inputs to Collect Automatically
- Workflow
- Output Format
这五段不是并列的说明文档,是一条自上而下收紧的链路,越往下约束越硬。
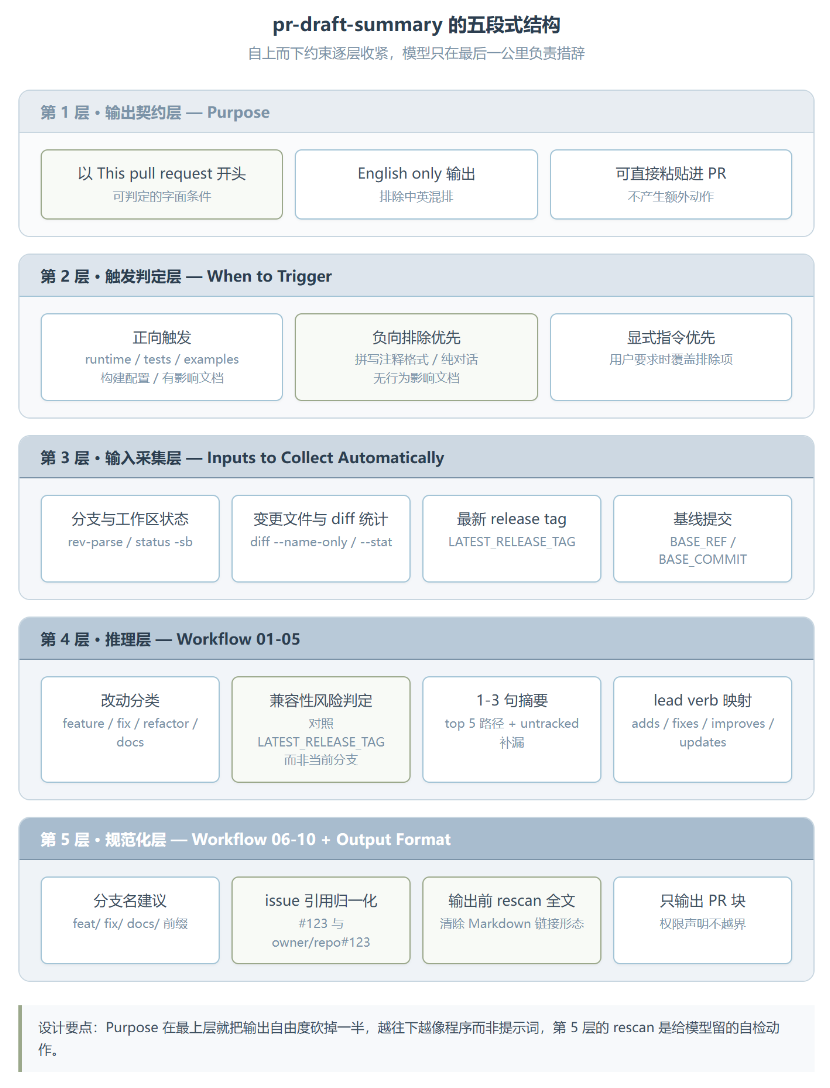
最上面那层 Purpose 只有两句话,但锁死了整份文档的硬约束:产物必须包含一个可以直接粘进 PR 的块,描述必须以 This pull request 开头。这两句看着不起眼,实际是把输出的自由度在最开始就砍掉一半。很多人写 Prompt 喜欢在结尾加一句请输出得专业一些,那种话等于没说,模型根本不知道专业指什么。这里给的是可判定的字面条件。
第二层 When to Trigger 用的是负向清单优先的写法。它先把不该跑的情况列全:
- 纯拼写、注释、格式改动
- 纯对话任务
- 仓库元信息或文档改动且无行为影响
- 用户明确说不要
$release-candidate-prep交接这类已有专门产物的场景
列完之后才说该跑什么。这个顺序很关键,因为排除项才是模型最容易踩坑的地方,正向描述写得再漂亮也拦不住它在改一行 typo 时给你输出一个 PR 草稿。
第三层 Inputs to Collect Automatically 是全篇信息密度最高的部分,一共七条 git 命令,标题里那句 do not ask the user 是核心。它不允许模型反问用户你的分支名是什么、你改了哪些文件,而是要求它自己去壳里执行。这一条把 Skill 从对话提示词升级成了带工具调用约定的程序。
git rev-parse --abbrev-ref HEAD
git status -sb
git ls-files --others --exclude-standard
git diff --name-only && git diff --name-only --cached
LATEST_RELEASE_TAG=$(.agents/skills/final-release-review/scripts/find_latest_release_tag.sh origin 'v*' 2>/dev/null || git tag -l 'v*' --sort=-v:refname | head -n1)
BASE_REF=$(git rev-parse --abbrev-ref --symbolic-full-name @{upstream} 2>/dev/null || echo origin/main)
BASE_COMMIT=$(git merge-base --fork-point "$BASE_REF" HEAD || git merge-base "$BASE_REF" HEAD || echo "$BASE_REF")
还有个容易忽略的细节:这份文档在 Smithery 上的版本比 skills.sh 收录的旧版多了两条,也就是第 08 步和第 09 步,专门处理 GitHub 引用的规范化。旧版只说引用 issue 时用 #123,新版加了一整段禁止清单,明确不许出现 PR #123 这种 Markdown 链接形态,并要求输出前 rescan 全文。能看出这是被真实事故逼出来的补丁,模型太喜欢把引用包成链接,粘到 GitHub 上就成了噪音。
工作流分析
Workflow 段编号从 01 到 10,读下来像一份被反复修过的检查单,几乎每一条都能对应到某个具体的翻车现场。
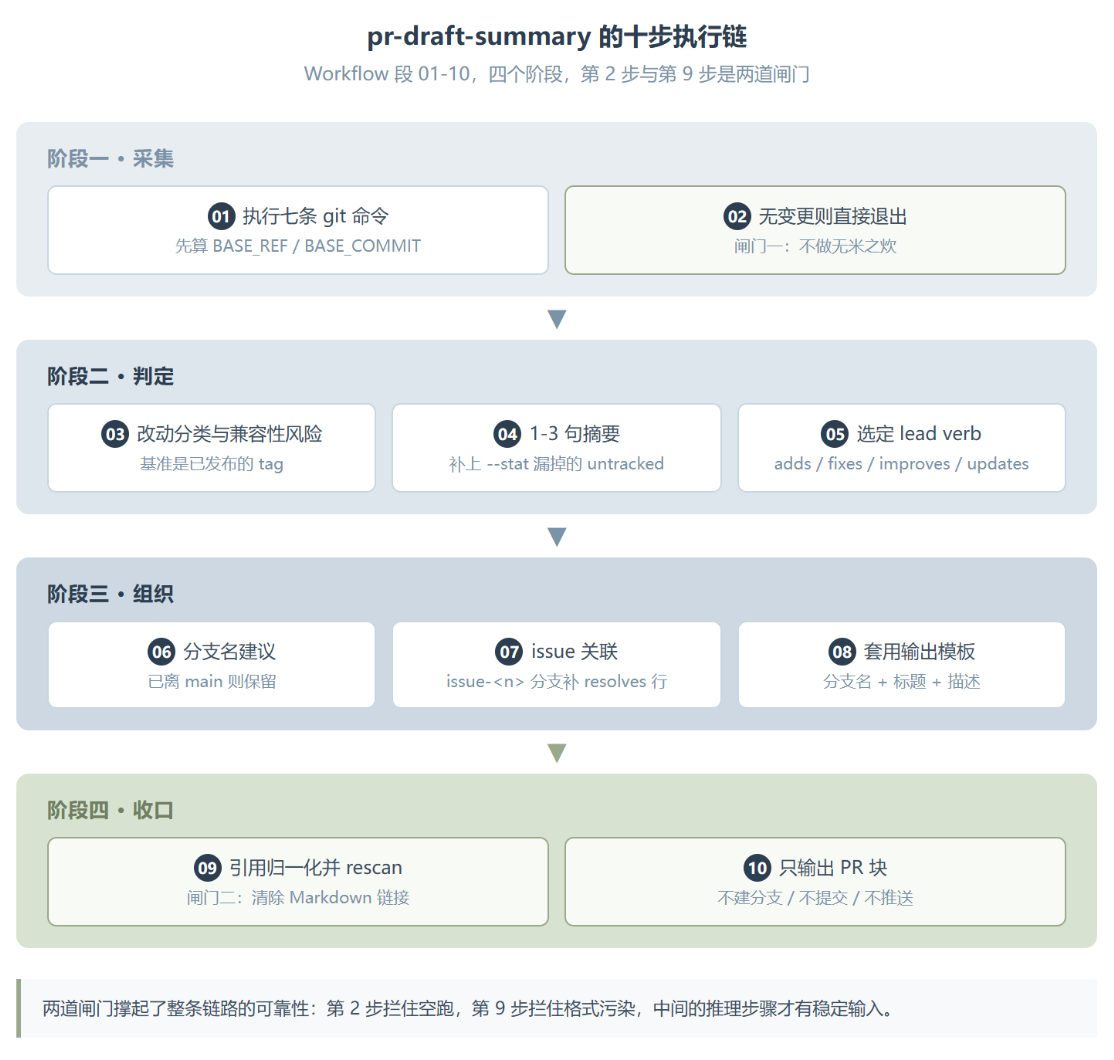
第 02 步要求先算 BASE_REF 和 BASE_COMMIT 再跑后面的命令,理由是后面的 diff 都要复用这两个值。这种顺序依赖写出来很琐碎,但不写模型就会每条命令各算一次,算出来的 base 还不一定一致,最后摘要张冠李戴。
第 03 步是分类与兼容性风险判定,这里有个我觉得很狠的设计。它要求风险判定必须对照 LATEST_RELEASE_TAG 做,而不是对照当前分支。意思是判断这次改动会不会破坏公开 API,基准是已经发出去的那个版本,不是你本地那堆还没合的提交。少了这句话,模型会拿工作区里的最新代码当基准,从而把所有 breaking change 都判成内部调整。
第 04 步点名了一个非常具体的坑:git diff --stat 不包含 untracked 文件,所以必须用 git status -sb 加 git ls-files --others --exclude-standard 补。新手写 Skill 最常漏的就是这个,结果新增的文件在摘要里凭空消失,PR 描述里只字不提真正的核心改动。
第 05 步给了一张动词映射表,feature 对应 adds,bug fix 对应 fixes,重构或性能对应 improves 或 updates,纯文档对应 updates。看起来是小事,作用是把描述的开头语气统一掉,避免同一个仓库里一半 PR 写 This PR adds,另一半写 This PR introduces。
第 06 到 07 步处理分支名和 issue 关联。已经在 main 之外的分支就保留,否则按主改动区域建议 feat/ fix/ docs/ 前缀;分支名如果匹配 issue-<数字>,保留原名并自动补一行 This pull request resolves #<number>.。第 09 步再兜一次底,把所有同仓库的 URL 归一成 #123,跨仓库的归一成 owner/repo#123,然后要求重扫全文确认没有遗漏。这两步加起来,本质是在做一个输出前的 lint。
使用场景
判断一个 Skill 好不好用,得看它在边界场景下的表现。这份文档对边界的处理比我预期细,我挑四个典型场景说。
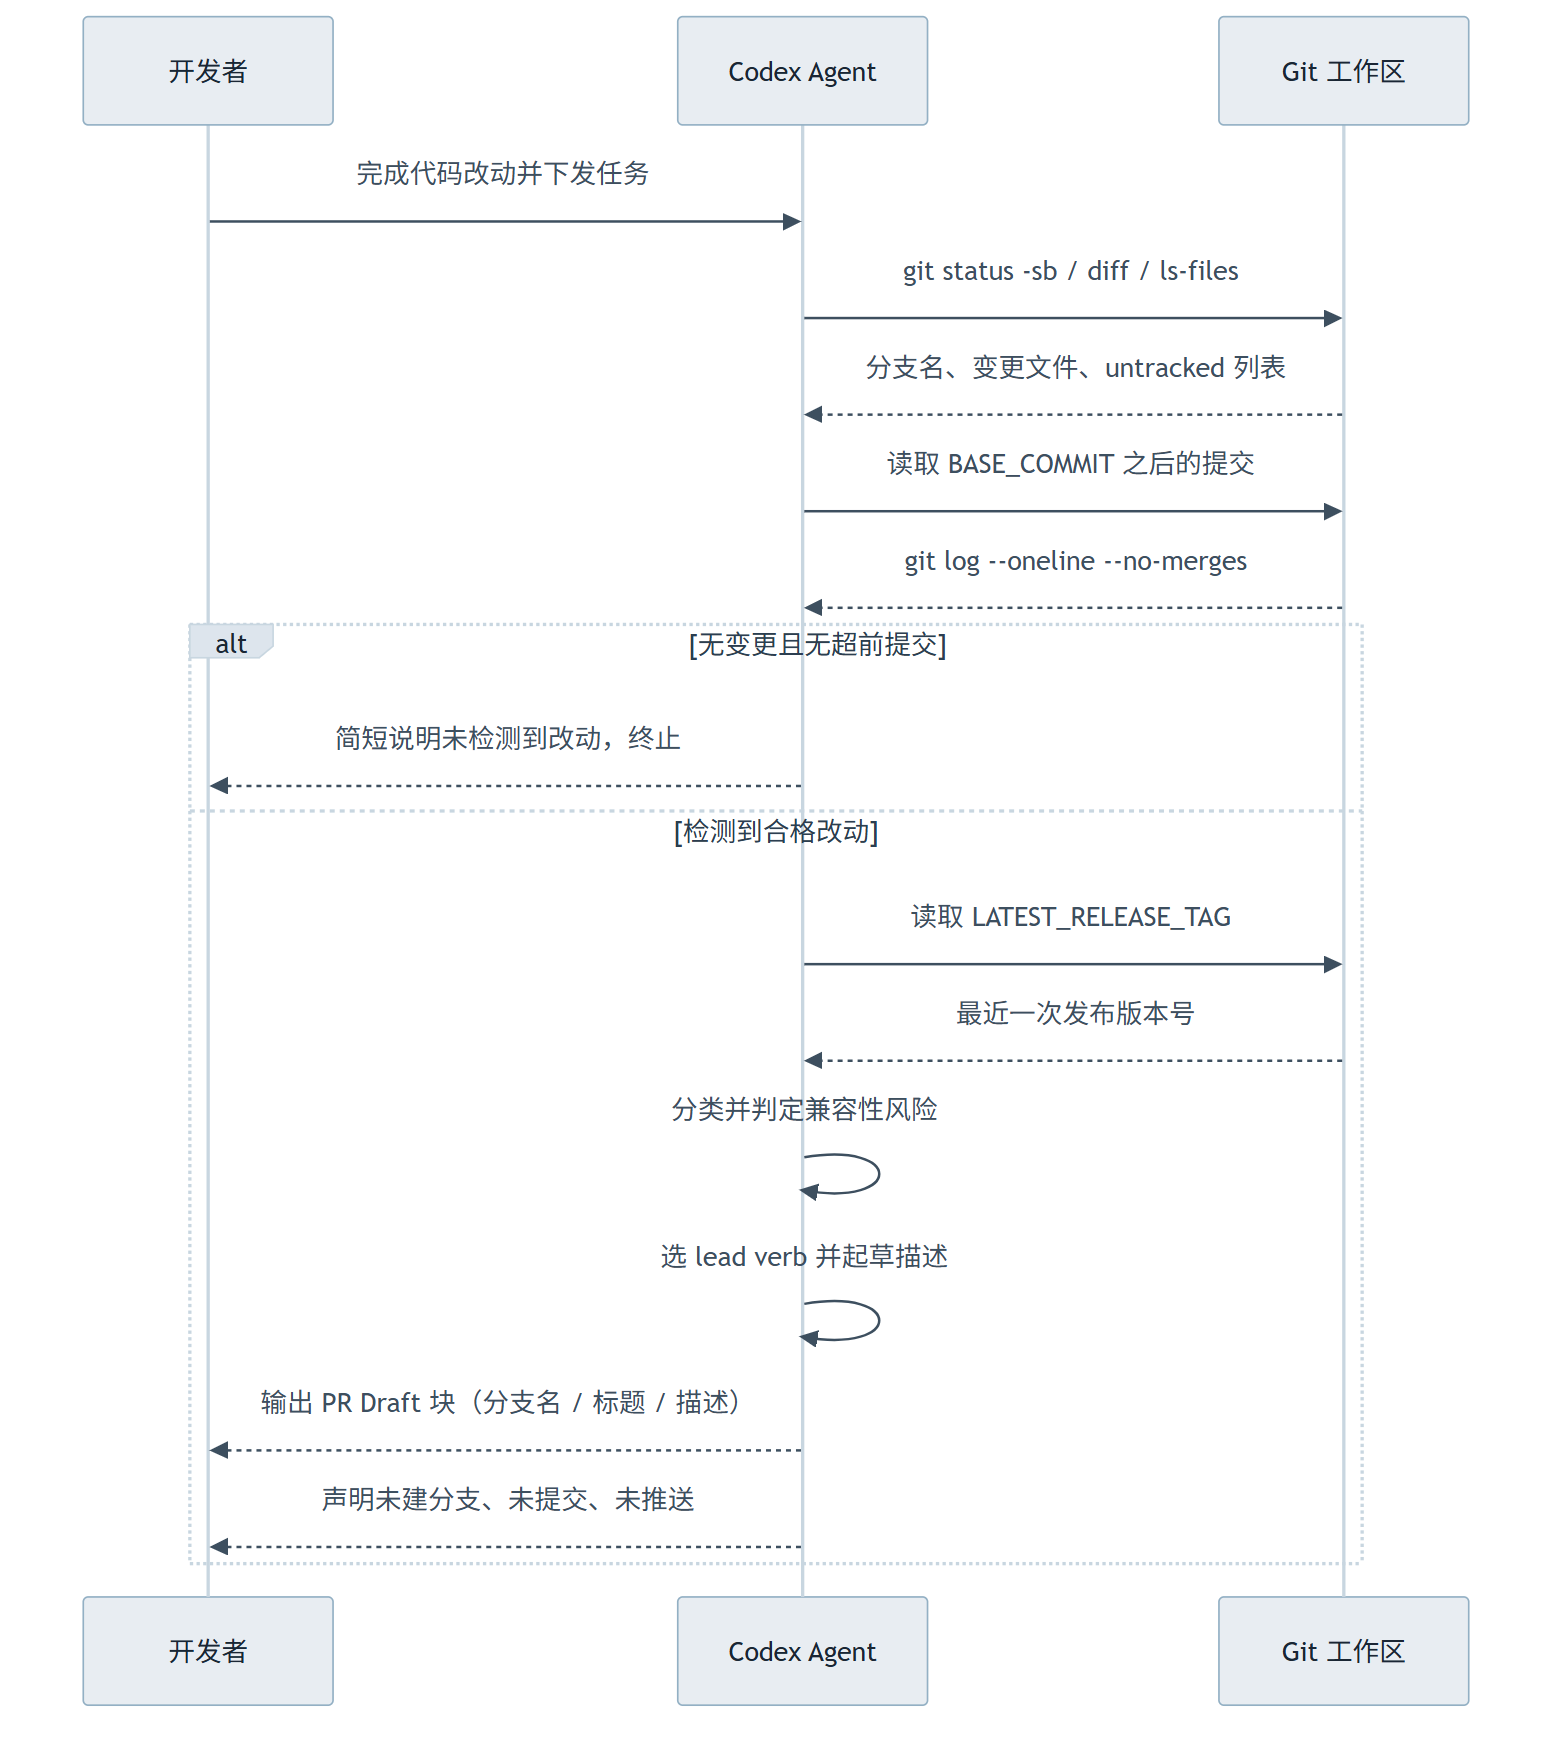
第一个场景是本地改了一堆还没提交,用户压根没提 PR 两个字。文档明确说这种情况要跑,并且加了一句 Producing this text does not authorize creating a branch, committing, pushing, or opening a pull request。这句是给 Agent 的权限划界,防止它自作主张把代码推上去。很多人写这类 Skill 时会漏掉权限声明,结果 Agent 一边生成描述一边顺手 commit 了。
第二个场景是改动只在注释、拼写、格式上,即便路径落在 runtime 或测试目录里。文档把这类判为 editorial,要求跳过。判定标准是是否改变行为或契约,不是文件在哪个目录。这个区分很值钱,因为按路径判断是最省事的写法,也是最容易误触发的写法。
第三个场景是用户明确说不要。文档把显式用户指令的优先级放在自动触发规则之上,包括自动触发的排除项。这条看着理所当然,但在 Prompt 里经常会被一堆规则淹没,模型容易记住规则忘了人话。
第四个场景是 release 流程。文档说当 $release-candidate-prep 被显式调用并且要用 $final-release-review 的完整报告作为 release 专用描述时,跳过本 Skill,同时补了一句这条例外只适用于准备 release candidate 本身,不适用于修改 release 准备流程的 Skill。这种补丁式的补充说明,一看就是踩过坑才写出来的。
洞察与反思
拆完之后,我觉得这份文档最值得抄走的设计有三个,也各有各的代价。
| 设计 | 做法 | 代价 |
|---|---|---|
| 输入采集脚本化 | 七条 git 命令 + do not ask the user | 强依赖 shell 环境,无 git 的场景直接失效 |
| 排除项优先 | 先列 5 类 skip 场景再讲触发 | 判定仍需模型理解行为影响,非机械匹配 |
| 输出前 lint | 第 09 步引用归一化 + rescan 全文 | 占用输出 token,长 PR 描述成本上升 |
第一个亮点是把输入采集从对话搬进了脚本。Prompt 工程里最容易被低估的一件事是:模型输出质量的下限,取决于它拿到的上下文是不是确定性的。你让它问用户改了哪些文件,用户可能随口说个大概;你让它执行 git diff --name-only,它拿到的一定是真的。
第二个亮点是输出规范化那条 rescan 指令。它不只说要用 #123,还列举了所有禁止形态,并要求输出前重扫一遍。这是在承认一件事:单次约束对模型不够用,得给它一个自检动作。这个思路可以直接搬到任何要求格式稳定的 Prompt 里。
不足也很明显。最要命的是强绑定 openai-agents-python,category signals 里把路径写死了:
- runtime →
src/agents/ - tests →
tests/ - examples →
examples/ - docs →
docs/、mkdocs.yml - 构建配置 →
pyproject.toml、uv.lock、Makefile、.github/
换仓库不改这些路径,分类推理会全部失准。它是一份仓库内置规范,不是通用工具,你照搬之前得先做适配。
另一个不足是全篇零 few-shot。所有要求都用规则描述,没有给一个合格输出和不合格输出的对照样例。规则能约束格式,约束不了语气和详略程度。真要我改,我会补一组正反例,再给描述加一个硬上限,比如正文不超过 150 词。现在这版只说 Keep it tight,tight 是多少全靠模型自己领会。
资源地址
| 资源 | 链接 |
|---|---|
| Smithery 页面 | https://smithery.ai/skills/openai/pr-draft-summary |
| 来源仓库 | https://github.com/openai/openai-agents-python |
| 安装命令 | npx skills add https://github.com/openai/openai-agents-python –skill pr-draft-summary |
总结
值不值得用,取决于你在哪个仓库。如果你就在 openai-agents-python 里干活,或者你的仓库结构跟它接近,这份 Skill 基本是开箱即用,改几个路径就能跑。如果你指望拿它当通用的 PR 描述生成器,那得先做一轮适配,而且适配完你会发现它的价值主要在分类信号那一层,不在生成那一层。
对我自己写 Prompt 的启发有两条。一条是排除项比正向描述重要,先写清楚什么时候不要跑,再写什么时候跑。另一条是能脚本化的输入就不要用对话问,确定性上下文比任何措辞技巧都管用。
还有个更大的问题留在这:这类收口型 Skill 到底该不该默认自动触发?它规定每次最终回复前都要检查一遍,代价是每次对话都多一轮判断。我倾向于在小仓库里值得,在大仓库里会拖慢节奏。你怎么看,评论区聊。