稿子改到第八版,声音就得跟着重录第八遍。YoVoice 的想法是把整套音频工作室搬进你自己的电脑:文字转语音、几秒参考音频复刻音色、AI 写歌、五线谱编曲,13 款开源模型按需下载,推理全程在本地完成,不按字数计费。上线一个月拿到 1700 个 star,它到底能不能替代云端配音,上手跑一遍才知道。
产品概述
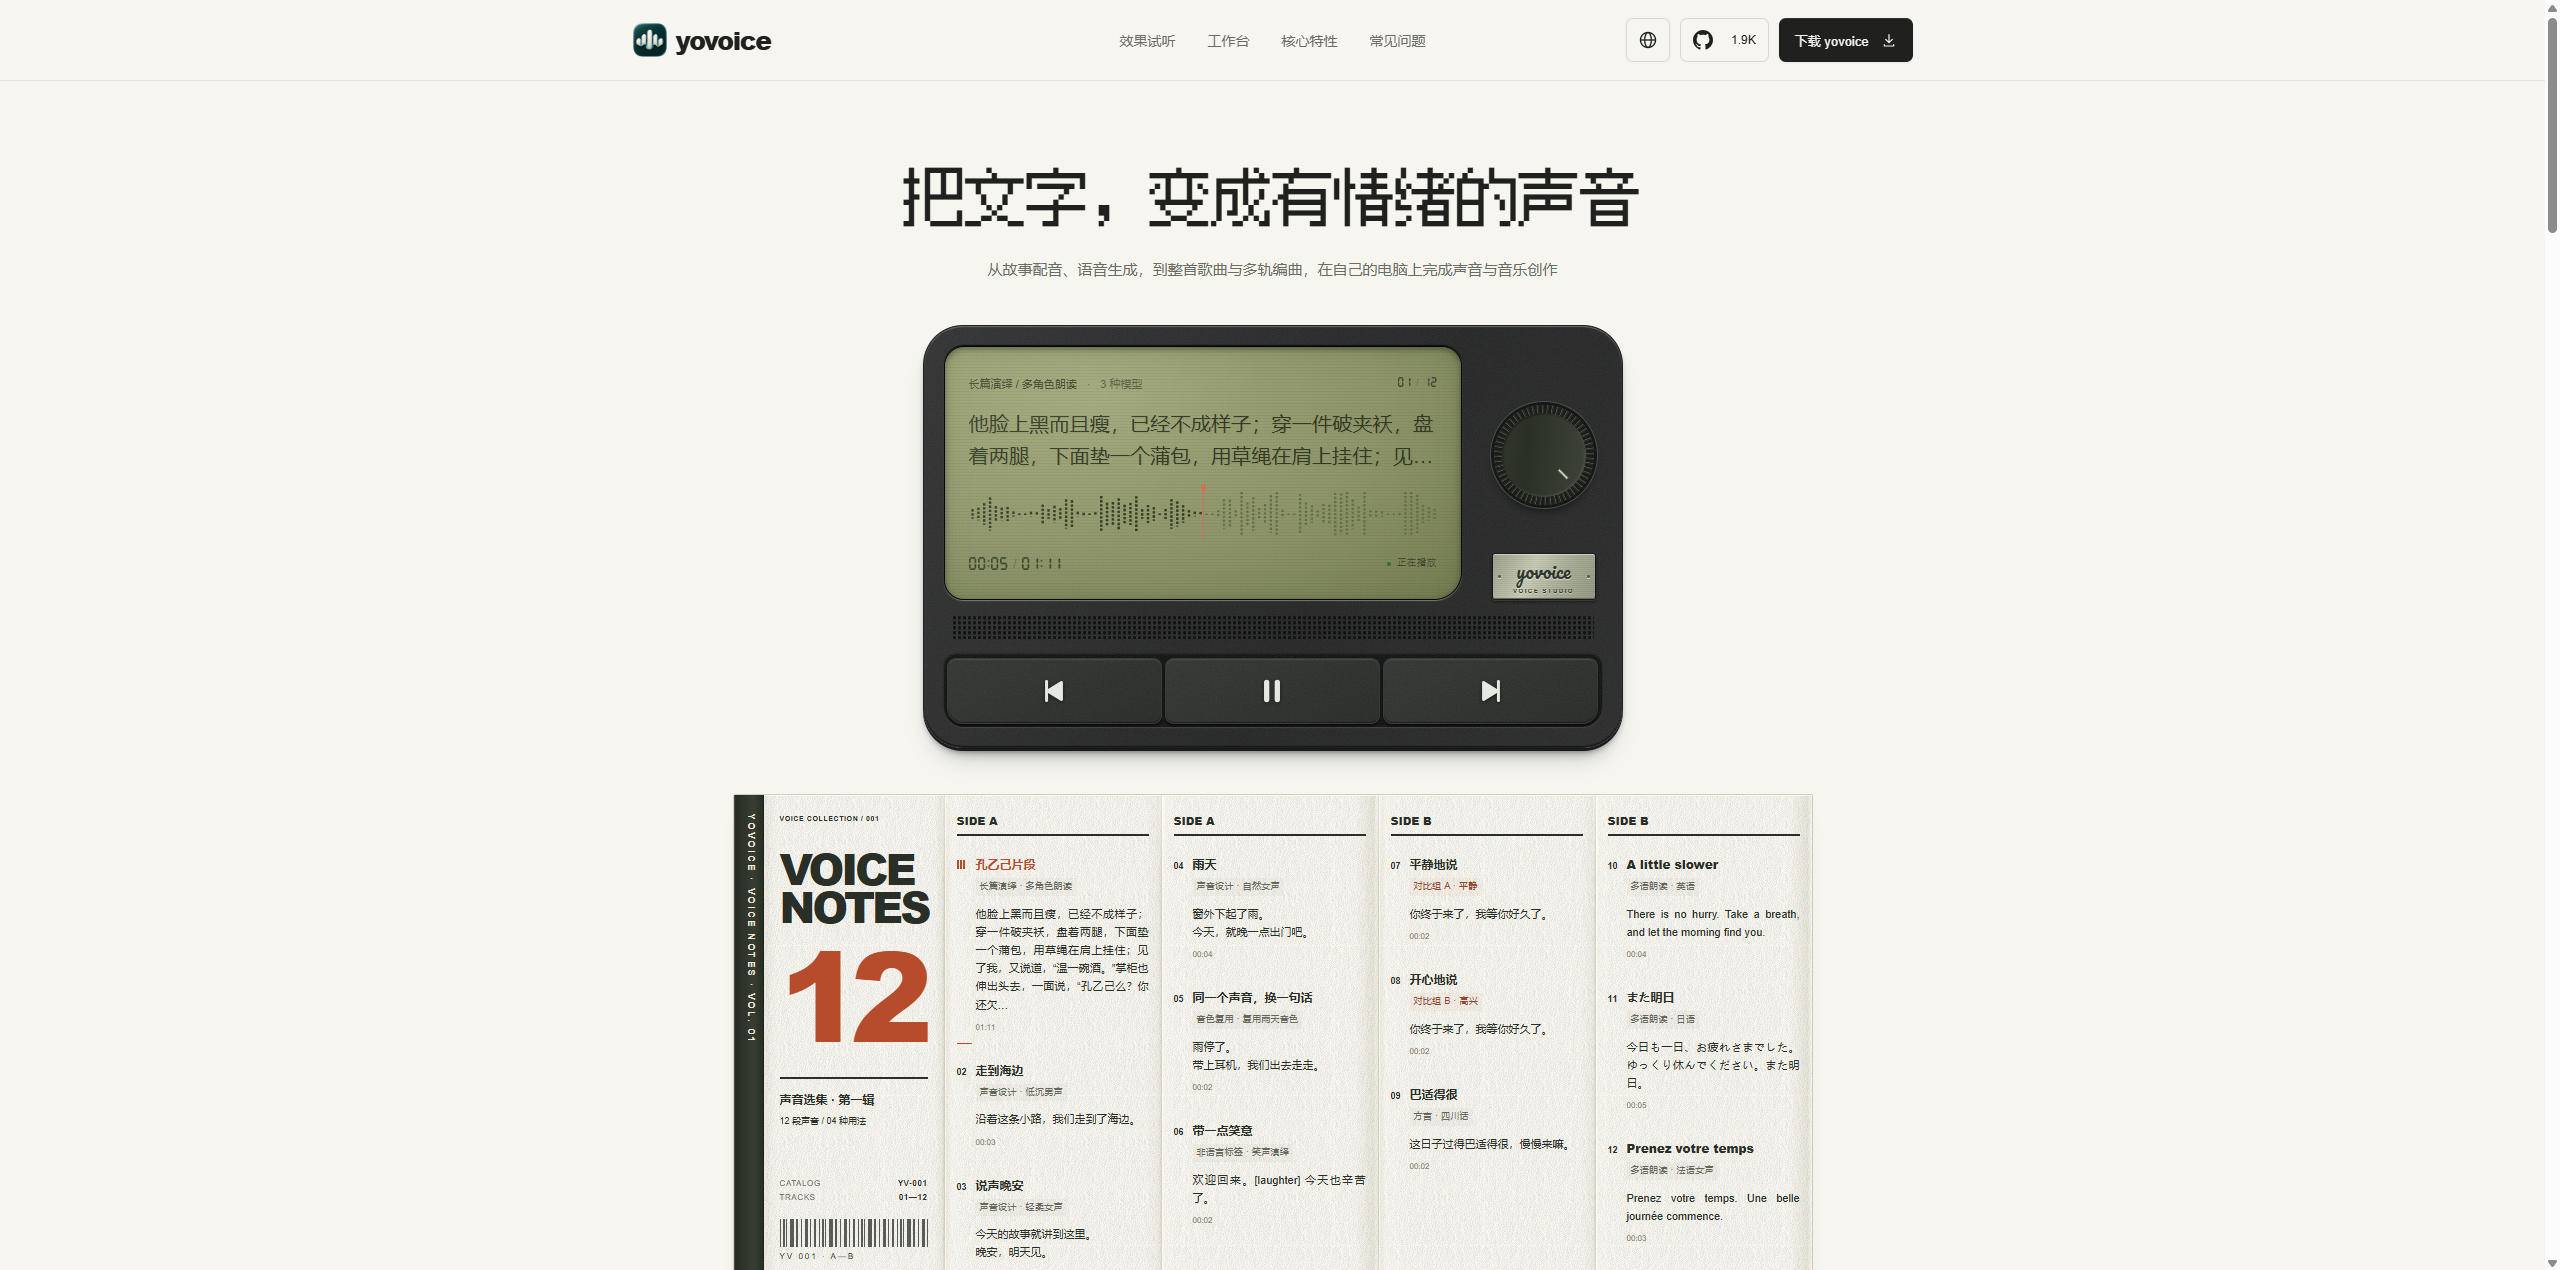
YoVoice 是一款开源的本地音频与音乐创作工作台,支持 macOS 14 以上的 Apple Silicon 机型和 Windows 10/11 x64 桌面端。它把文字转语音、零样本声音克隆、AI 音乐生成和五线谱编曲收进同一个应用,底层由 C++ 推理引擎 audio.cpp v0.9.1 驱动 13 款开源模型,安装包双击即用,不用配 Python 环境,也不用注册账号。
项目 2026 年 9 月 15 日上线,到 10 月 19 日已迭代到 v0.3.0,不到一个月连发五个版本,GitHub 收获 1705 个 star、128 个 fork。代码采用 Apache 2.0 协议,桌面端基于 TypeScript 编写,模型在应用内下载并支持断点续传,卸载软件后用户目录下的作品与模型仍保留在 ~/.yovoice 文件夹里。
官网:https://yovoice.leemysw.com | 项目地址:https://github.com/leemysw/yovoice
核心功能
先说结论:这不是又一个单一功能的 TTS 工具,它想把从文稿到成品音频的整条链路都包圆。
四个项目类型覆盖主要创作场景。故事配音模式可导入文本或字幕,给每一行分配角色声线后逐段生成;语音生成模式适合单段旁白,能调情绪和语气;音乐模式用风格提示词加带段落标记的歌词直接产出完整歌曲;乐谱模式按小节写音符,用 General MIDI 音色渲染,可导出 MIDI 和分轨文件。
模型生态是它最大的差异化。13 款开源模型按需下载,从 82M 参数的轻量款到 10GB 级的音乐模型,覆盖克隆、音色设计、内置音色、歌曲生成四类需求。每个模型都提供多种量化精度,下载支持断点续传,也支持导入 GGUF 格式的自制权重,折腾空间留得够。
| 模型 | 参数量 | 拿手场景 |
|---|---|---|
| IndexTTS 2.0 / 2.5 | — | 中英与多语言克隆、情绪控制、读音编辑 |
| VoxCPM2 | 2B | 文字描述设计音色、48kHz 克隆 |
| OmniVoice | 0.6B | 属性化音色设计、非语言声音标签 |
| Qwen3-TTS Base | 0.6B / 1.7B | 参考音频克隆、多语言朗读 |
| Qwen3-TTS CustomVoice | 1.7B | 9 种内置音色加风格指令 |
| Qwen3-TTS VoiceDesign | 1.7B | 纯文字描述造新音色 |
| Breeze TTS 2 | 约 3B | 中英文音色设计与带指导的克隆 |
| Kokoro-82M | 82M | 轻量内置音色,CPU 可跑 |
| ACE-Step 1.5 Turbo / XL Turbo | — | 风格加歌词生成歌曲或纯音乐 |
| YuE2 3B | 3B | 按歌词生成带人声歌曲 |
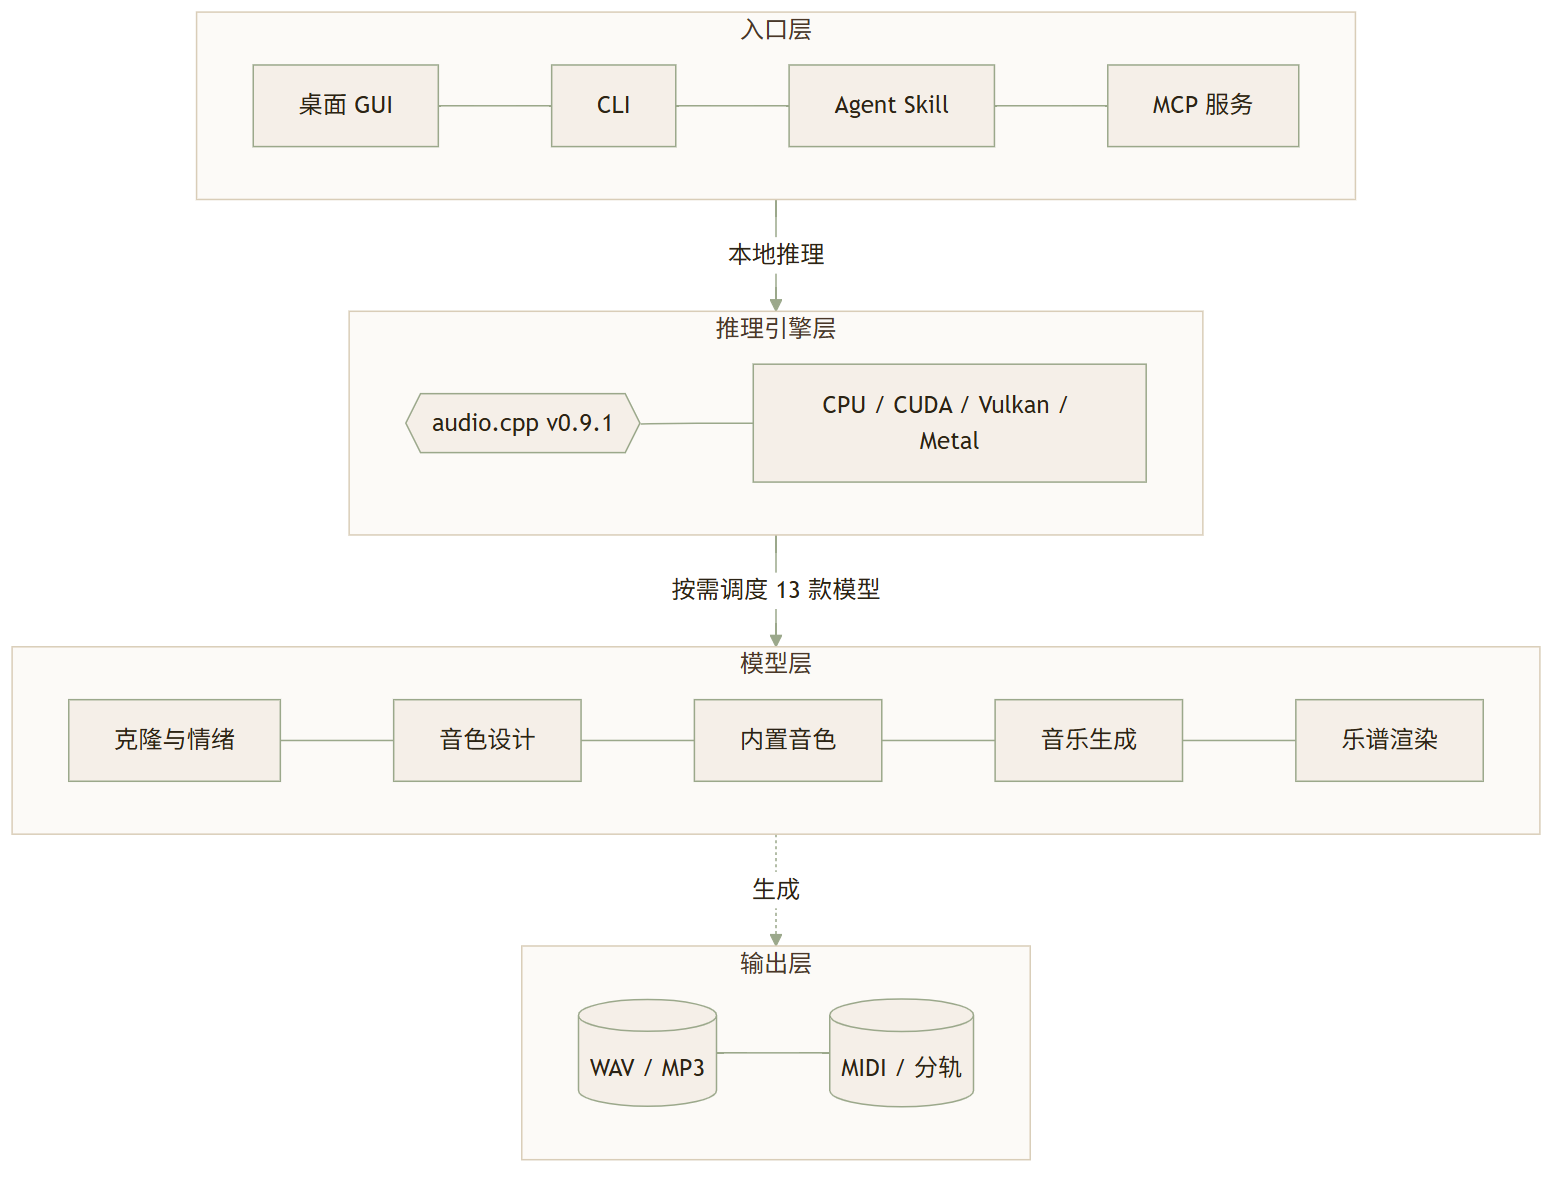
整条链路的拼装方式值得看一眼。桌面应用、命令行、Agent Skill 和 MCP 服务是四个平等入口,全部汇入同一个推理引擎,引擎再根据硬件后端调度模型,产出音频或乐谱。同一个模型能力,人可以用鼠标点,开发者可以用脚本调,Agent 可以用自然语言驱动。
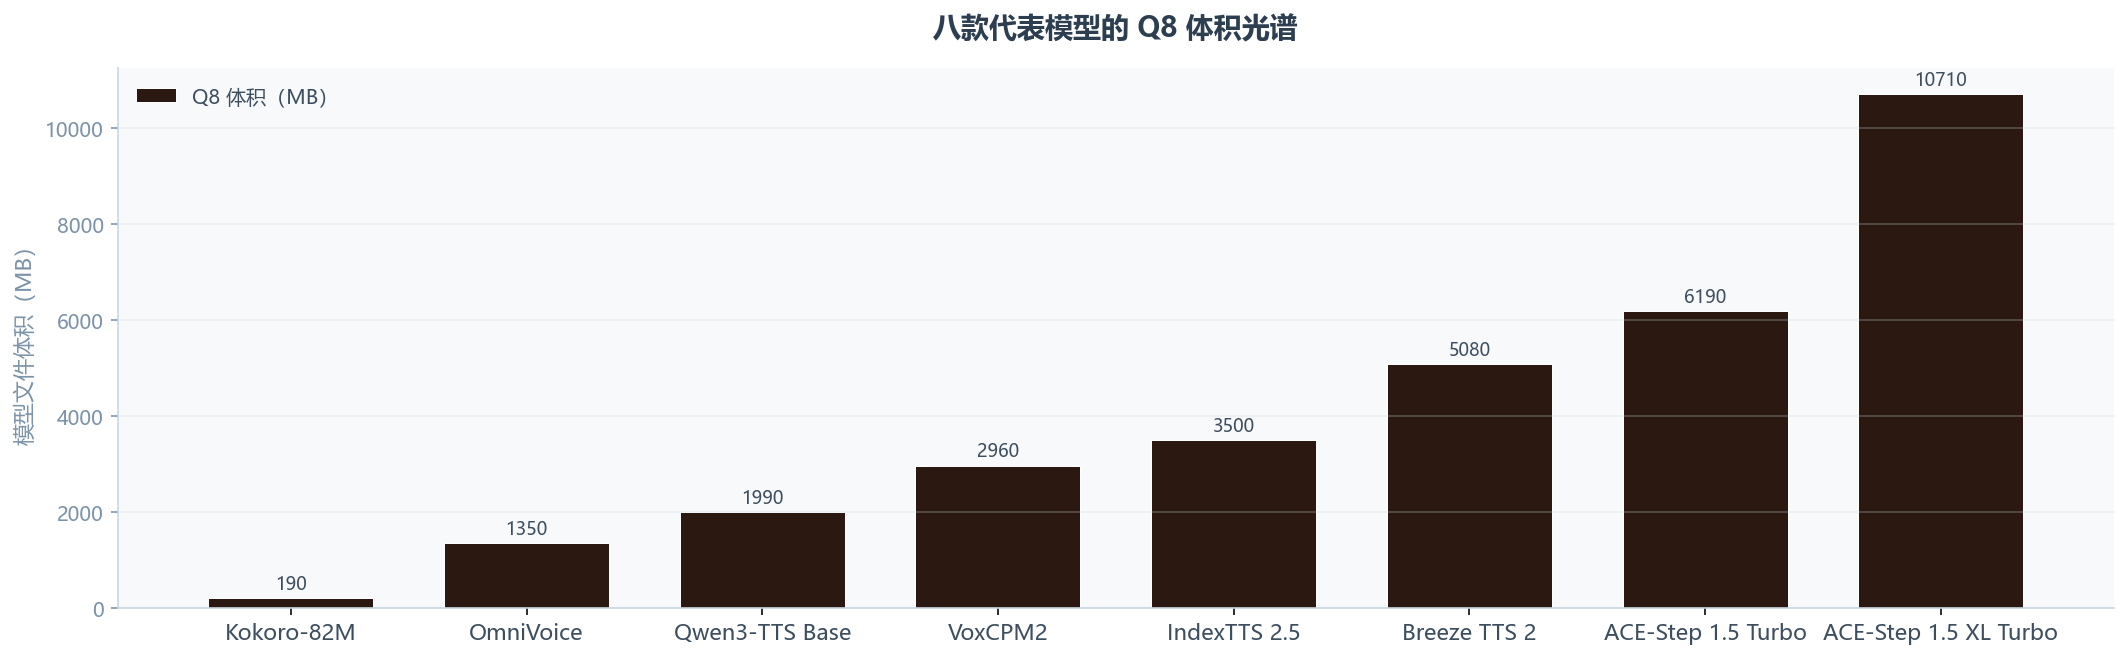
模型体积的跨度比想象中大。Q8 量化之后,最轻的 Kokoro-82M 只要 190MB,最重的 ACE-Step 1.5 XL Turbo 要到 10710MB,中间隔着五十多倍差距。模型文件大小不等于运行内存,实际占用还受量化精度和文本长度影响,选型前先看硬盘和显存余额,别一口气把音乐模型拖下来才发现跑不动。
多 take 管理是被低估的设计。每次生成都存为独立版本,同一段文稿的多个演绎可以并排试听,对比语速和情绪后再进波形编辑器修剪导出。对反复改稿的旁白流程来说,这比”生成一次覆盖一次”顺手得多。
上手体验
功能说得再好,不如从下载到产出完整走一遍。
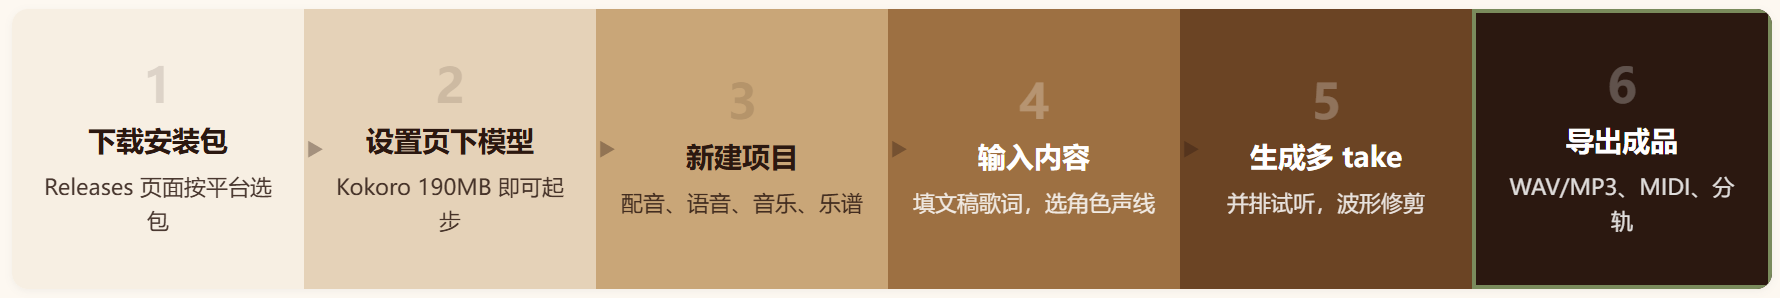
安装没什么门槛。GitHub Releases 页面按平台选包:macOS 拖进 Applications,Windows 跑 setup.exe,NVIDIA 用户还有捆绑 CUDA 12.4 或 13.3 运行时的专用版本,首次启动就能用上显卡。Windows 安装器会自动补装 WebView2 运行时,全程不用手动找依赖,也不用注册账号,装完直接新建项目。
真正花时间的是下模型。首次打开进设置页挑一个模型下载,之后才能新建项目。只想随便试试就从 Kokoro-82M 入手,Q8 量化后 190MB,4GB 内存的机器就能跑;要做声音克隆再下 VoxCPM2 或 IndexTTS,显存建议备足 4 到 6GB;玩 AI 作曲则要上 ACE-Step,Q8 也要 6GB 起步,XL 版本直奔 10GB。
| 模型 | Q8 体积(MB) | 硬件参考 |
|---|---|---|
| Kokoro-82M | 190 | 任意 CPU,4GB 内存 |
| OmniVoice | 1350 | 4GB 显存 |
| Qwen3-TTS Base 0.6B | 1990 | 4GB 显存 |
| VoxCPM2 | 2960 | 4 到 6GB 显存 |
| IndexTTS 2.5 | 3500 | 4 到 6GB 显存 |
| Breeze TTS 2 | 5080 | 6GB 以上显存 |
| ACE-Step 1.5 Turbo | 6190 | 12GB 以上显存 |
| ACE-Step 1.5 XL Turbo | 10710 | 12GB 以上显存 |
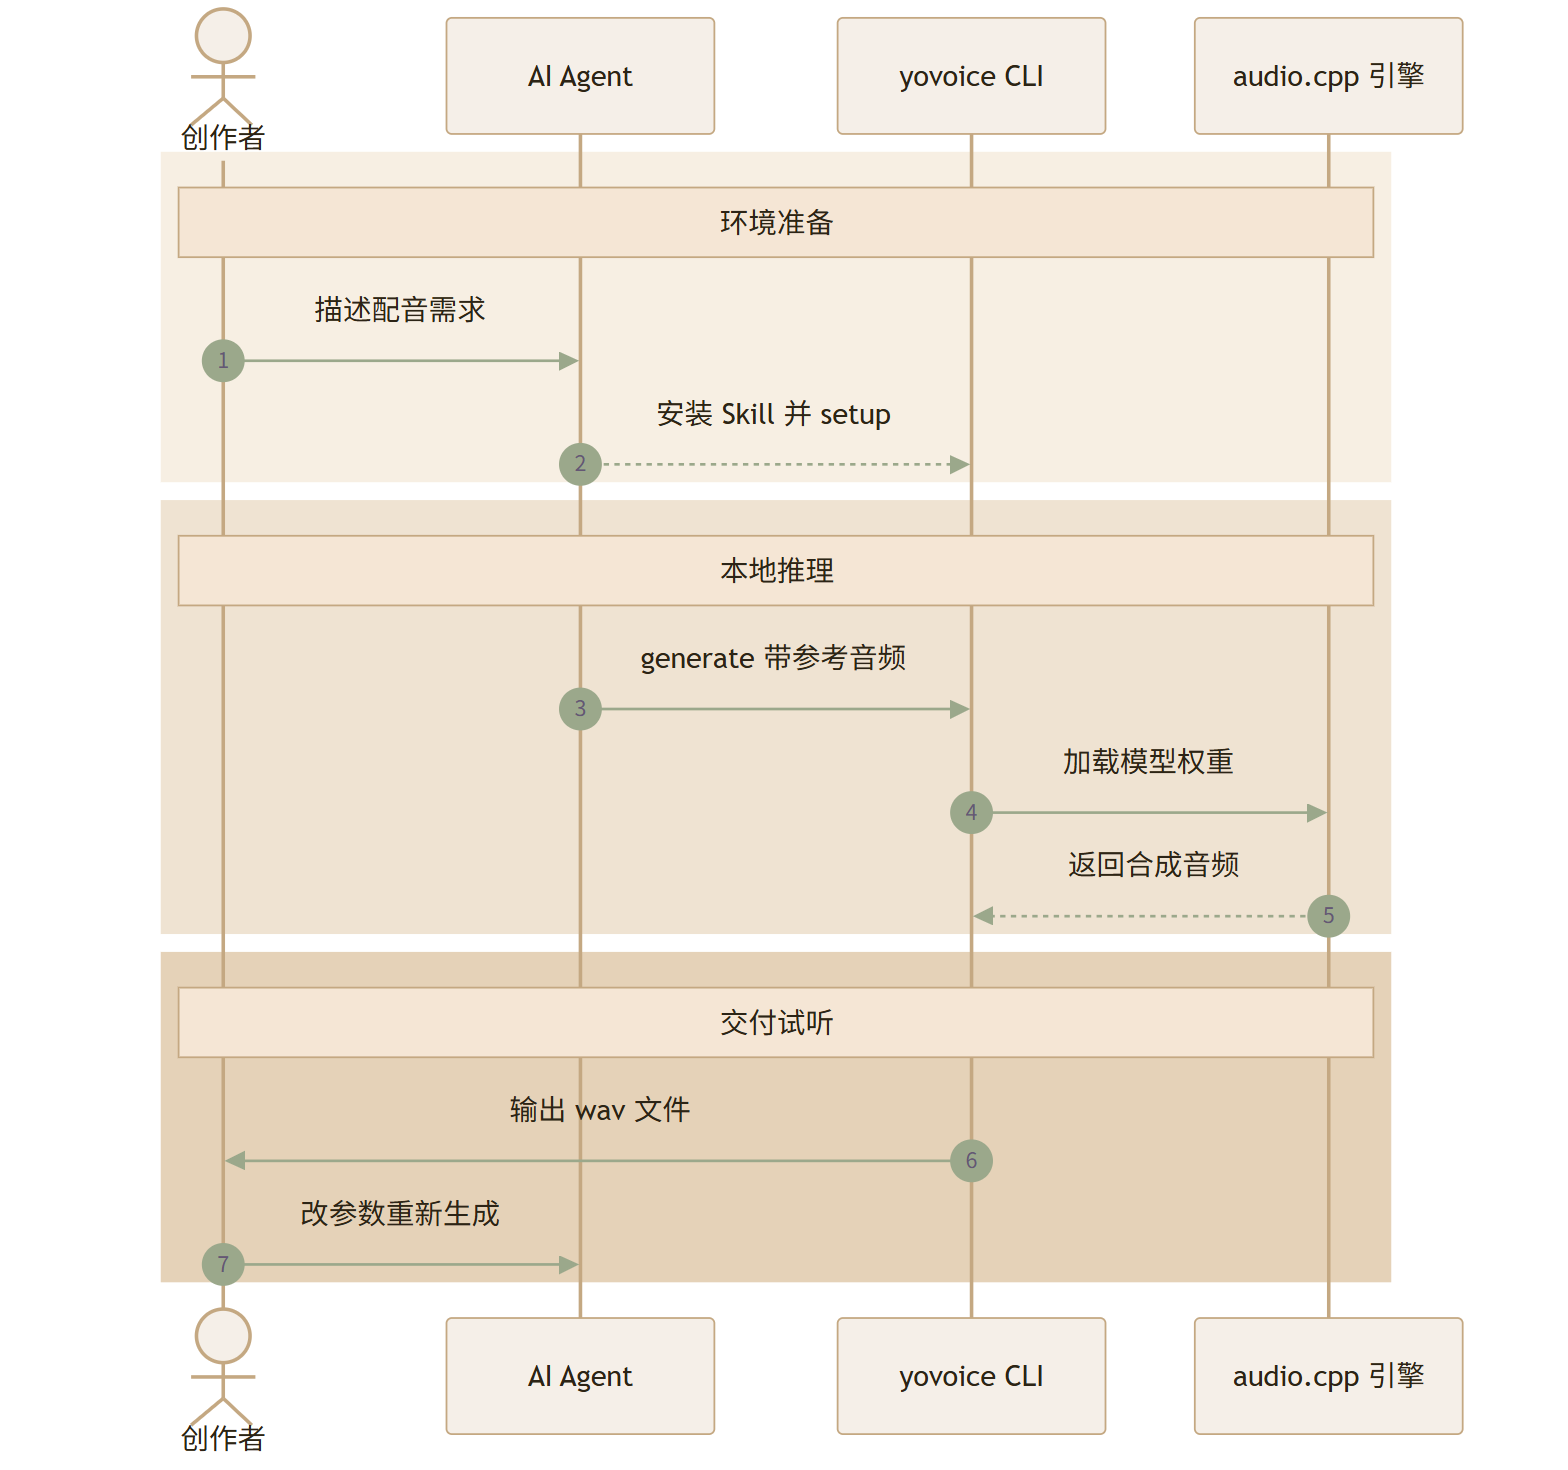
命令行是另一条腿。装好 CLI 之后,yovoice models download 拉模型,yovoice generate 带参考音频直接出片,批量任务可以脚本化;yovoice serve 还能起一个带鉴权的 HTTP API 和 MCP 推理服务,给别的机器或 Agent 调用。桌面端负责试听和微调,命令行负责重复劳动,两边共用同一套模型文件,分工很清晰。
yovoice models download kokoro-82m-q8
yovoice generate --model kokoro-82m-q8 --speaker af_heart --text "你好,欢迎来到我的频道。" --output hello.wav
yovoice generate --model voxcpm2-q8 --text-file narration.txt --reference voice.wav --output vox.wav
第一次产出比预期省心。用 Kokoro 念一段三百字的旁白,几秒出结果,内置音色的自然度对普通口播够用;换 VoxCPM2 克隆自己的声音,同一段稿子的辨识度立刻不一样。真正磨人的是长稿:不分段的几千字文稿可能出现音色漂移,按段落拆开生成再拼接才稳。
使用技巧
功能都摸清了,说几个很多人不知道的进阶玩法。
- 长文本记得分块。VoxCPM2 默认按 200 字切块,超过 400 字上限音色容易漂移甚至出噪音;克隆场景把长文本策略设成 stateless,让每一块都直接锚在参考音频上。
- Breeze TTS 2 的调参有顺序。先把文本块缩到 80 到 120 字,再把 temperature 降到 0.6 到 0.8,还拖就把 guidance_scale 提到 3 到 4,一步到位容易过头。
- 参考录音决定克隆上限。要清晰、单人、少混响,长度 1 到 60 秒、不超过 20MB;OmniVoice 和 Breeze 必须配逐字文本,文字对不上,效果大打折扣。
- IndexTTS 的情绪向量按 happy、angry、sad、afraid、disgusted、low、surprised、calm 八个值排序,配合 emotion-strength 调强度,比纯文字描述更可控。
- 写歌先排段落。用 [verse]、[chorus]、[bridge] 标记歌词结构,只要伴奏就打开 Instrumental;YuE2 想做翻唱,先用 SheetSage2 从原曲提取旋律再换成自己的音色。
竞品对比
单打独斗没意思,拉几个同类产品进来横向对比。
本地与云端两条路线都有成熟玩家:开源框架有 CosyVoice 3 和 GPT-SoVITS,云端订阅有 ElevenLabs,几个产品的战场并不完全重合,选型前先看自己在哪一头。
| 对比维度 | YoVoice | CosyVoice 3 | GPT-SoVITS | ElevenLabs |
|---|---|---|---|---|
| 产品形态 | 本地工作台加 CLI、MCP | 开源语音模型框架 | 开源本地克隆工具 | 云端订阅服务 |
| 费用 | 免费开源 | 免费开源 | 免费开源 | 免费 10k 积分每月,付费 $6 起(截至 2026 年 10 月官网) |
| 部署门槛 | 双击安装即用 | Python 加 PyTorch,建议 GPU | Python 环境,需准备训练 | 注册即用 |
| 声音克隆 | 几秒参考音频零样本 | 3 秒零样本,支持跨语言 | 1 分钟数据少样本训练 | 即时与专业克隆 |
| 音乐与乐谱 | AI 作曲加五线谱 MIDI | 不支持 | 不支持 | Eleven Music 按积分计费 |
| Agent 集成 | 原生 MCP 与 Agent Skill | 自行封装 | 自行封装 | 官方 API |
| 流式输出 | 以离线生成为主 | 双向流式约 150 毫秒 | 不支持 | 低延迟 API |
| 商用许可 | Apache 2.0,部分模型权重限非商用 | Apache 2.0 | MIT | 付费版含商用授权 |
核心差异在整合度。CosyVoice 3 的流式能力和克隆质量更强,但它是一个模型框架,部署、调参、写代码都得自己来;GPT-SoVITS 的克隆社区积累最深,代价是少样本训练流程;ElevenLabs 买的是省心和极致自然度,按量付费且素材要上云。YoVoice 占的是”开箱即用的本地全家桶”这个位置,代价是年轻项目的粗糙感。
预算和隐私是另一条分水岭。高频改稿的旁白场景,云端按字符计费的账单会随修改次数线性上涨,而 YoVoice 的边际成本是零;反过来,如果只是偶尔配一次音,或者要做直播实时配音,本地方案的准备时间和流式短板就都不划算。
用户反馈
媒体的实测反馈集中在两点:链路完整,门槛低。
中文开发者社区的评测普遍给出正面信号。有评测把它的功能链路概括为”从文字到语音到歌曲到乐谱”的全流程覆盖,13 款模型按需下载的设计对新手友好;ChatTools 的结论是”YoVoice 的出现,某种程度上降低了音频 AI 的使用门槛”。GitHub 上一个月 1700 个 star 的增长,也说明本地音频工具的需求真实存在。
吐槽集中在工程细节。流式输出被多次点名,它更适合离线生成而非实时场景,直播配音仍要看向 CosyVoice 这类支持流式的方案;音乐模型动辄 6GB 到 10GB,首次安装的等待时间客观存在;NavXD 的提醒更直接,接入可选云端 AI 服务后会产生对应调用与费用,不能把所有功能都描述成完全离线且零成本。
多维评分
按八个固定维度过一遍,价格维度对免费开源产品不适用。
| 维度 | 权重 | 星级 | 一句话解读 |
|---|---|---|---|
| 功能完整性 | 20% | ★★★★★ | 配音、克隆、作曲、乐谱、MCP 全覆盖 |
| 易用性 | 15% | ★★★★ | 双击即用,模型选型仍有学习成本 |
| 性能表现 | 15% | ★★★★ | C++ 引擎加原生加速,大模型吃显存 |
| AI 能力 | 15% | ★★★★ | 集成开源一线模型,上限取决于选型 |
| 价格合理性 | 10% | N/A | 免费开源,不参与评分 |
| 生态集成 | 10% | ★★★★ | MCP、CLI、Agent Skill 三入口齐全 |
| 文档与支持 | 10% | ★★★ | 中英双语文档齐,社区仍年轻 |
| 更新频率 | 5% | ★★★★★ | 不到一个月连发五个版本 |
加权归一化后综合得分 4.2 分(满分 5 分)。扣分主要在两处:模型体积和硬件门槛挡掉一部分轻量用户,文档与社区生态还撑不起”成熟”二字。如果愿意折腾模型选型,这个分数对应的性价比很高,同样的能力换到云端订阅,每月省下的都是真金白银。
优缺点
值得称赞的地方:
- 全本地推理,参考音频和作品不出本机,隐私敏感场景可用。
- 免 Python 环境,C++ 引擎开箱即用,卸载不丢数据。
- 功能链路长,配音、克隆、作曲、乐谱在一个应用里闭环。
- CLI、Agent Skill、MCP 三个自动化入口,能接进 Agent 工作流。
- 迭代速度惊人,不到一个月五个版本。
需要泼冷水的地方:
- 硬盘和显存是硬门槛,音乐模型 6GB 起步。
- 流式输出弱,实时配音场景请转向别的方案。
- 许可碎片化,OmniVoice、YuE2、Breeze TTS 2 权重限非商用,商用需逐项核对。
- 项目太年轻,社区生态、第三方教程和周边工具都在建设中。
- 长文本稳定性依赖手动调分块参数,开箱不等于开箱即好。
适用人群
对号入座之前,先看清自己的硬件和用途。
- 有声书与播客作者:长稿多角色配音,多 take 对比能提升成片效率,本地生成零边际成本。
- 短视频与漫剧团队:零样本克隆固定角色声线,全片音色一致,高频产出不烧钱。
- 独立音乐人:ACE-Step 出 demo、乐谱写 MIDI,灵感到成品都在本机完成。
- 隐私敏感的企业场景:内部培训、未发布产品宣传片,声纹不出内网。
- 开发者:CLI 和 MCP 可以把音频生成接进自动化流水线。
两类人建议绕道。只需要一次性配个音的用户,下载模型和等待安装的时间可能比收益高;没有独立显卡、硬盘也紧张的轻薄本用户,Kokoro 之外的模型都很勉强。商用前务必逐个核对模型权重许可,这是开源项目最常见的翻车点。
FAQ
挑几个被问得最多的问题集中答一遍。
Q1:YoVoice 完全免费吗?
A1:软件本体完全免费。 代码采用 Apache 2.0 协议,本地推理不按字符或分钟计费。但要注意,OmniVoice、YuE2 和 Breeze TTS 2 的模型权重限非商业用途,商用前需逐项核对许可条款。
Q2:必须联网才能用吗?
A2:下载阶段需要,推理阶段不需要。 模型下载和首次初始化要联网,之后语音合成、克隆、乐谱渲染全部离线完成。内置 AI 助手如果选择连接云端 API,那部分调用会走对应服务的计费规则。
Q3:没有显卡能跑吗?
A3:能,但只能跑轻量模型。 Kokoro-82M 的 Q8 版本只有 190MB,4GB 内存的 CPU 就能流畅运行。声音克隆建议 4 到 6GB 显存,AI 作曲要 12GB 以上,Windows 端支持 CPU、CUDA 和实验性 Vulkan 三种后端。
Q4:和 ElevenLabs 比该怎么选?
A4:看频次和隐私,不是看绝对质量。 高频改稿、素材敏感选 YoVoice,边际成本为零;追求极致自然度、需要低延迟 API 且用量不大,ElevenLabs 的订阅更省心,截至 2026 年 10 月其入门档为每月 6 美元。
Q5:克隆别人的声音合法吗?
A5:只有拿到授权才合法。 克隆真实人物的声音需取得本人许可,避免冒充、误导或侵权。参考音频同样要确认来源合法,成品用于商业场景前建议保留授权记录。
Q6:支持哪些语言?
A6:取决于所选模型,不是一刀切。 IndexTTS 2.5 覆盖中日英西阿,Qwen3-TTS 支持十一种语言自动检测,ACE-Step 的演唱语言超过五十种。应用界面本身有十二种语言,切换不用重启。
Q7:能生成完整的歌曲吗?
A7:可以,质量看模型档位。 用风格提示词加带 [verse]、[chorus] 标记的歌词,ACE-Step 1.5 Turbo 或 YuE2 3B 都能生成带人声的歌曲,时长可选 10 到 300 秒,纯音乐打开 Instrumental 即可。
Q8:Windows 要自己装 CUDA 吗?
A8:不用,选对安装包就行。 Releases 页面提供捆绑 CUDA 12.4 和 13.3 运行时的专用版本,NVIDIA 用户下载对应包即可,首次启动就能调用显卡;安装器还会自动补装 WebView2。
Q9:长文本生成出现拖音、重复怎么办?
A9:先砍分块,再降温度。 这是 Breeze TTS 2 的已知特性,把文本块缩到 80 到 120 字,temperature 降到 0.6 到 0.8,多数情况能解决;仍不理想就把 guidance_scale 提到 3 到 4。
Q10:生成的音频和工程存在哪里?
A10:默认在用户目录的 ~/.yovoice。 卸载桌面应用不会删除这里的作品和模型文件,重装后可以直接继续之前的项目。换电脑迁移时,拷贝这个文件夹即可带走全部素材。
Q11:有手机版或网页版吗?
A11:目前都没有。 只有 macOS 14 以上的 Apple Silicon 和 Windows 10/11 x64 桌面端。想让手机用上,可以考虑通过 yovoice serve 起服务,但延迟和体验取决于网络,官方并未提供移动端支持。
结尾
绕回最开始的问题:YoVoice 能不能替代云端配音?对高频改稿的内容创作者,能;对偶尔配一次音的轻度用户,不值当装这一套。
它的真正价值不在单项质量,而在把配音、克隆、作曲、编曲整合进一个本地应用,让音频创作的边际成本降到零,同时把素材留在自己硬盘上。对一个上线一个月、连发五个版本的项目来说,完成度已经超出预期。
当然要保留耐心:许可碎片化、流式短板、社区生态年轻,都是现阶段的真实约束,商用前逐项核对模型许可这一步不能省。适合就上手,不适合等它再迭代几个版本也不亏。软件本体采用 Apache 2.0 协议,完全免费,官网和 GitHub Releases 都能直接下载。